




Auf einen Blick: Service Level Objectives (SLOs) sind kritische Benchmarks, die zur Messung der Service-Zuverlässigkeit in Cloud-Diensten verwendet werden und durch spezifische Kennzahlen definiert sind. Die Etablierung effektiver SLOs erfordert die Abstimmung mit den Geschäftsanforderungen und die Sicherstellung des Verständnisses der Stakeholder, um eine optimale Serviceleistung zu erzielen.
- Definieren Sie SLOs als messbare Benchmarks innerhalb von SLAs.
- Regelmäßig kommunizieren und dokumentieren Sie SLOs für alle Beteiligten.
Wenn IT-Workloads von der On-Premise-IT-Infrastruktur zu externen Cloud-Rechenzentren verlagert werden, ist es wichtig sicherzustellen, dass Servicelevels mit den Anforderungen Ihres Unternehmens übereinstimmen. Die Parameter und Kennzahlen, die Servicelevel für jedes Element der Cloud-Lösung definieren, sollten diese Anforderungen erfüllen. Der Serviceprovider sollte hohe Performance-, Sicherheits- und Compliance-Standards einhalten und gleichzeitig eine erschwingliche Kostenstruktur bieten, die Kunden anzieht. Um diese Ziele zu erreichen, müssen Organisationen das Serviceverhalten auf Basis klar definierter Ziele verstehen, messen und bewerten. Das Thema Service Level Agreements (SLAs) wird häufig behandelt, um die Verantwortlichkeiten von Cloud-Service-Anbietern zu diskutieren. Ein besseres Verständnis der Service Level Objectives (SLOs) kann jedoch helfen, Messungen der Serviceleistung zu bewerten, die für Endnutzer tatsächlich von Bedeutung sind. Schauen wir uns also diese SLOs an.
Was sind die Ziele des Serviceniveaus?
Ein Service Level Objective (SLO) dient als Maßstab für Indikatoren, Parameter oder Metriken, die mit spezifischen Servicelevel-Zielen definiert sind. Die Ziele können ein optimaler Bereich oder ein spezifischer Wert für jede Servicefunktion oder jeden Prozess, der einen Cloud-Service ausmacht, sein. Die SLOs können auch als messbare Merkmale eines SLA bezeichnet werden, wie zum Beispiel Quality of Service (QoS)-Aspekte, die erreichbar, messbar, sinnvoll und für Dienstleister und Kunden akzeptabel sind. Ein SLO wird innerhalb der SLA als Verpflichtung vereinbart, mit Gültigkeit unter bestimmten Bedingungen (wie Zeitperioden) und wird in einem SLA-Dokument ausgedrückt. (Lesen Sie unsere Erklärung zu SLAs vs. SLOs.)
Wie SLOs funktionieren
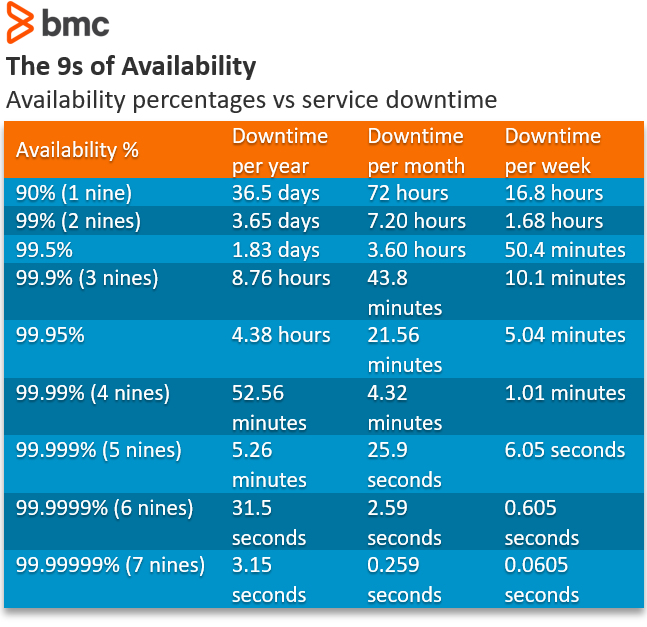
Während das Endziel der Definition effektiver SLOs darin besteht, zuverlässige Dienste für Endnutzer bereitzustellen, steigen die Kosten und Komplexität, sich einer 100%igen Zuverlässigkeit zu nähern, exponentiell an. (Sehen Sie, wie sich das mit der Serviceverfügbarkeit auszahlt.)
Jede Komponente des Cloud-Dienstes hat unterschiedliche Auswirkungen auf die von den Kunden wahrgenommene Serviceleistung. Zum Beispiel kann eine App eine Reaktionsfähigkeit auf einem bestimmten Leistungsniveau erfordern, über die Kunden hinaus keinen Unterschied mehr spüren können. Das Maß für Responsivität und App-Leistung kann durch numerische Indikatoren definiert werden, wie:
- Anforderungslatenz
- Chargendurchsatz
- Ausfälle pro Sekunde
- Weitere Kennzahlen
Diese Indikatoren beschreiben das Serviceniveau zu jedem Zeitpunkt. Um die Gesamtleistung im Kontext des vereinbarten SLA-Vertrags oder der Verfügbarkeitsanforderungen zu verstehen, müssen Sie diese Zahlen über einen längeren Zeitraum analysieren. Mathematisch umfasst die SLO-Analyse:
- Die Leistung des Service-Level-Indikators über einen langen Zeitraum aggregieren.
- Vergleichen Sie das Ergebnis mit einem numerischen Ziel für die Systemverfügbarkeit.
Ein SLO ist ein Bereich
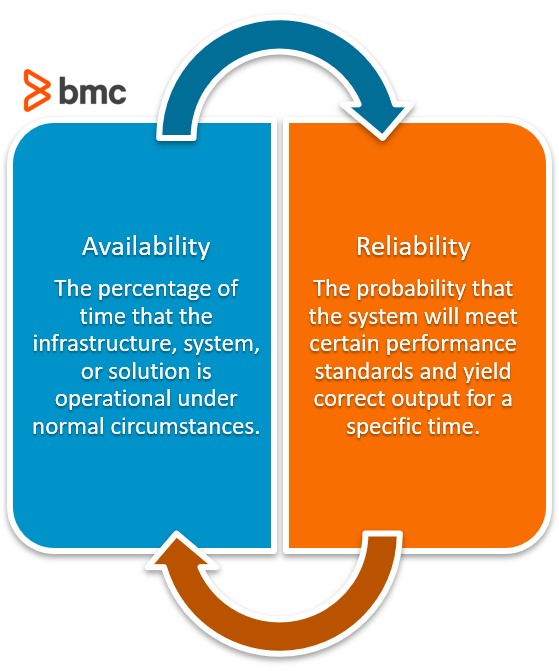
Ein SLO ist nicht dazu gedacht, das beste Leistungsniveau zu definieren. Stattdessen sollte es eine Reihe bestmöglicher und am wenigsten akzeptabler Leistungsstandards festlegen. Stellen Sie sich ein Szenario vor, in dem ein Cloud-Dienst mit einem SLA von 99 % Verfügbarkeit gekauft wird, was 7,31 Stunden Ausfallzeit pro Monat entspricht. Mehrere Monate vergehen, und die Systeme bleiben an der oberen Grenze der SLOs, die 99,9 % der Betriebszeit liefern, also weniger als eine Stunde Ausfallzeit pro Monat. Plötzlich, wenn die Systeme mehrere Stunden ununterbrochen ausfallen, sind Endnutzer unangenehm überrascht, dass der Dienst unter ihren üblichen Erwartungen liegt. Gleichzeitig ist der Dienstanbieter möglicherweise nicht verpflichtet, Unterstützung anzubieten, wenn er nicht beabsichtigt oder sich verpflichtet, die bestmögliche SLO zu liefern. Da SLO die Messung mehrerer quantifizierbarer Kennzahlen zur Systemzuverlässigkeit beinhaltet, sollten Sie den Unterschied zwischen den Begriffen Zuverlässigkeit und Verfügbarkeit sorgfältig verstehen. In der Praxis werden SLOs durch die niedrigsten akzeptablen Zuverlässigkeitsstandards definiert.
SLO-Best Practices
Einfach ausgedrückt beschreiben Service Level Objectives, wie gut die Servicezuverlässigkeit während einer bestimmten Zeitspanne war, basierend auf den Messungen spezifischer Servicelevel-Indikatoren. Die folgenden Best Practices können Ihnen helfen, diese Ziele zu erreichen:
- Identifizieren Sie die richtigen Kennzahlen und Indikatoren , um die Systemzuverlässigkeit genau zu beschreiben, wie sie von Ihrer Organisation und den Endnutzern wahrgenommen, erwartet und gefordert wird.
- Stellen Sie sicher, dass die richtigen Personen die SLOs verstehen. SLO sollte vom technischen Team und den Führungskräften der Organisation gut verstanden werden. Organisationen sollten SLOs basierend auf den geschäftlichen Anforderungen sowie der technischen Kapazität und Expertise der Organisation entwickeln.
- Richten Sie das technische Team und die Geschäftsbeteiligten auf die SLO-Ziele aus. Wenn Ingenieure die SLO-Ziele nicht erfüllen können, riskiert die Organisation die Nichteinhaltung ihrer SLAs gegenüber Kunden.
- Verwenden Sie für jede logische Systemkomponente eine unabhängige SLO. Jede Systemkomponente kann das Gesamtsystem unterschiedlich beeinflussen oder dazu beitragen. Daher ist es wichtig, für jede Systemkomponente optimale SLOs basierend auf Kosten, Komplexität und anderen damit verbundenen geschäftlichen und technischen Herausforderungen zu definieren.
- Missen Sie mehrere Service-Level-Indikatoren zusammen, um ein einziges SLO-Ziel zu bewerten. Zum Beispiel können Latenz, Fehler und andere QoS-Kennzahlen erforderlich sein, um die vollständige Systemleistung in Bezug auf spezifische Ziele zu bewerten.
- Dokumentieren und kommunizieren Sie SLOs für alle Stakeholder. Diese Informationen sind oft entscheidend für technische Teams oder Geschäftsleiter, um relevante Entscheidungen zu treffen.
- Priorisieren Sie SLOs für bestimmte Kunden. Zahlende Kunden mit strengen Verfügbarkeitsanforderungen benötigen möglicherweise einen höheren SLO-Basiswert als Freemium-Nutzer.
- Betrachten Sie SLOs als ein fortlaufendes Bekenntnis, optimale Systemleistung über verschiedene Servicelevel-Indikatoren hinweg zu liefern. SLOs entwickeln sich im Laufe der Zeit weiter; sie können nicht als statische Ziele betrachtet werden. IT-Workloads und die Erwartungen der Endnutzer ändern sich kontinuierlich. Ein SLO, der für die aktuellen Workload-Anforderungen entwickelt wurde, ist für seine zukünftigen Leistungsanforderungen möglicherweise nicht gleichermaßen gültig.
- Halte SLOs einfach, selten und realistisch. Vermeide absolute Zahlen, die unrealistisch sind. Du kannst eine interne SLO einstellen, die als Sicherheitsmarge oder Puffer dient, um ein niedrigeres SLO-Ziel zu erreichen, das mit den Endnutzern vereinbart wird.
Perfektion ist nicht notwendig
Es ist möglicherweise nicht möglich, Service-Level-Ziele zu 100 % der Zeit zu erreichen. Cloud-Service-Anbieter müssen innovieren, Funktionen hinzufügen und Systeme aktualisieren, was wahrscheinlich zu vorübergehenden Ausfallzeiten in mehreren Rechenzentrumsinstanzen führt. Betrachten Sie dies als Kompromiss, um SLOs zu erreichen, um bessere Dienstleistungen zu liefern. Service-Level-Ziele drehen sich ganz um die Ziele, über die das Servicelevel für Kunden und Endnutzer nicht akzeptabel ist. Erwartungen realistisch zu setzen und die Ziele nicht zu übertreffen, könnte der erste Schritt sein, um einen Cloud-Service mit akzeptablem Endnutzererlebnis zu einem erschwinglichen Budget zu liefern.
Verwandte Literatur
- BMC Service Management Blog
- Was ist hohe Verfügbarkeit? Konzepte und Best Practices
- Systemzuverlässigkeits- und Verfügbarkeitsberechnungen
- 6 SLA-Best Practices für den Erfolg im Servicemanagement
- Verfügbarkeitsmanagement & Die Rolle des Verfügbarkeitsmanagers
- Eine Einführung in Service Level Indicator (SLI)-Metriken
- Service Level Management in ITIL® 4, Teil unseres ITIL 4 Leitfadens
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.