




Auf einen Blick: Snowflake-Fensterfunktionen ermöglichen komplexe Berechnungen über Zeilen hinweg ohne Aggregation. Dieses Tutorial erklärt wichtige Funktionen wie OVER(), PARTITION BY und ORDER BY und demonstriert ihren Einsatz in Berechnungen wie laufenden Totalen und Rankings.
- Fensterfunktionen unterscheiden sich von traditionellen SQL GROUP BY.
- Verwendet OVER(), um das Fenster für Berechnungen zu definieren.
Snowflake unterstützt Windows-Funktionen. Stell dir Windows-Funktionen vor, die über eine Teilmenge von Zeilen laufen, nur dass die Ergebnisse jede Zeile zurückgeben. Das unterscheidet sich von der traditionellen SQL-Gruppe dadurch , dass es für jede Gruppe ein Ergebnis gibt.
Eine Windows-Funktion könnte nützlich sein in Beispielen wie:
- Eine laufende Summe
- Die Durchschnittswerte über eine bestimmte Anzahl vorheriger Zeilen
- Eine Perzentilreihenfolge jeder Zeile unter allen Reihen.
Das Thema Fensterfunktionen in Snowflake ist umfangreich und komplex. Dieses Tutorial dient als kurze Übersicht und wir werden weitere Tutorials weiterentwickeln.
Schneeflocken-Definitionen
Snowflake definiert Windows als eine Gruppe verwandter Zeilen. Sie wird durch die over()- Anweisung definiert. Die Over()-Anweisung signalisiert Snowflake, dass Sie eine Fensterfunktion anstelle der traditionellen SQL-Funktion verwenden möchten, da einige Funktionen in beiden Kontexten funktionieren.
Ein Fensterrahmen ist eine Fensteruntergruppe. Fensterrahmen erfordern eine Reihenfolge nach Anweisung, da die Zeilen in bekannter Reihenfolge sein müssen.
Fensterrahmen können kumulativ oder schiebend sein, was Erweiterungen der Ordnung nach Anweisung darstellt. Kumulativ bedeutet über den gesamten Fensterrahmen. Schieben bedeutet, einen Offset hinzuzufügen, wie zum Beispiel +- n Zeilen.
Ein Fenster kann auch eine Partitionsanweisung haben. Eine Partition ist eine Gruppe von Zeilen, ähnlich wie die traditionelle Group-by-Anweisung.
Windows vs. reguläres SQL
Wenn Sie zum Beispiel Verkäufe nach Produkt gruppieren und 4 Zeilen in einer Tabelle haben, könnten Sie im Ergebnis zwei Zeilen haben:
Windows-Funktion
Sortierung nach
Reguläre SQL-Gruppe durch
    select count(*) from sales group by product:

10 product A
20 product B
Mit der Windows-Funktion hat man immer noch die Anzahl über zwei Gruppen hinweg, aber jede der 4 Zeilen in der Datenbank ist aufgelistet, während die Summe für die gesamte Gruppe gilt, wenn man die Partitionsanweisung verwendet.
    count 10 product A
count 10 product A
count 20 product B
count 20 product B
Erstellen Sie einige Beispieldaten
Um das zu untersuchen, erstellen Sie zuerst diese beiden Tabellen.
    CREATE TABLE customers
  (
     customernumber     varchar(100) PRIMARY KEY,
    customername varchar(50),
    phonenumber varchar(50),
    postalcode varchar(50),
    locale varchar(10),
    datecreated date,
    email varchar(50)
  );


CREATE TABLE orders
  (
     customernumber     varchar(100) PRIMARY KEY,
    ordernumber varchar(100),
    comments varchar(200),
    orderdate date,
    ordertype varchar(10),
    shipdate date,
discount number,
quantity int,
    productnumber varchar(50)
)
Dann fügen Sie diese SQL-Daten ein. Der obere Teil der Daten sieht so aus:
    insert into customers (customernumber,customername,phonenumber,postalcode,locale,datecreated,email) values ('440','tiqthogsjwsedifisiir','3077854','vdew','','2020-09-27','[email protected]');

insert into orders (customernumber,ordernumber,comments,orderdate,ordertype,shipdate,discount,quantity,productnumber) values ('440','402','swgstdhmju','2020-09-27','sale','2020-10-01','0.7005950240358919','61','BB111');

insert into customers (customernumber,customername,phonenumber,postalcode,locale,datecreated,email) values ('802','hrdngzutwelfhgwcyznt','1606845','rnmk','','2020-09-27','[email protected]');

insert into orders (customernumber,ordernumber,comments,orderdate,ordertype,shipdate,discount,quantity,productnumber) values ('802','829','jybwzvoyzb','2020-09-27','sale','2020-10-06','0.3702248922841853','75','FF4444');

insert into customers (customernumber,customername,phonenumber,postalcode,locale,datecreated,email) values ('199','ogvaevvhhqtjcqggafnv','8452159','hyxm','','2020-09-27','[email protected]');
Partition durch
Eine Partition erzeugt Teilmengen innerhalb eines Fensters. Hier haben wir die Summe der Menge nach Produkt.
    select customernumber, ordernumber, productnumber,quantity,
        sum(quantity) over (partition by productnumber) as prodqty
               from orders
               order by ordernumber
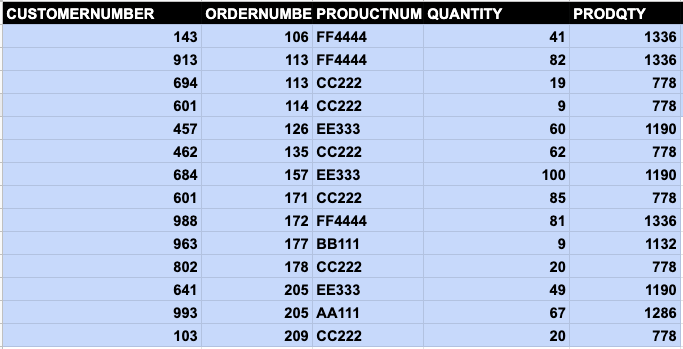
Dies liefert die gleichen Ergebnisse wie diese SQL-Anweisung, bei der die Order-Tabelle mit sich selbst verknüpft ist:
    select customernumber,
        ordernumber,
        productnumber,quantity,
        (select sum(quantity) from orders as o2 where o1.productnumber = o2.productnumber) as prodqty
               from orders as o1
         order by ordernumber
Die summe() -Funktion ergibt für eine Fensterfunktion keinen Sinn, weil sie für eine Gruppe und nicht für eine geordnete Menge ist. Dennoch erlaubt Snowflake, die Summe mit einem Fensterrahmen zu verwenden – also eine Anweisung mit einer order()-Anweisung – und liefert somit Ergebnisse, die schwer zu interpretieren sind.
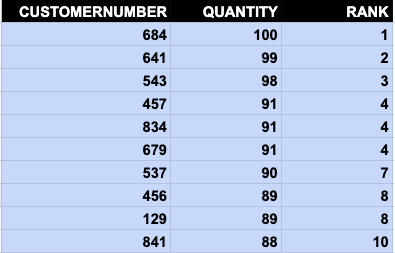
Schauen wir uns die Rangfunktion an, die für die Bestellung relevant ist. Hier verwenden wir eine Windows-Funktion, um unsere wertvollsten Kunden zu bewerten. Das sind diejenigen, die die größten Käufe getätigt haben.
Die Rang()- Funktion nimmt keine Argumente an. Das Fenster ist nach Größe in absteigender Reihenfolge geordnet. Wir begrenzen die Ausgabe auf 10, damit sie auf die folgende Seite passt.
select customernumber, quantity, rank() over (order by quantity desc) from orders limit 10
Hier ist die Ausgabe. Der Kunde mit den meisten Einkäufen wird zuerst aufgeführt.
Zusätzliche Ressourcen
Für weitere Tutorials wie dieses entdecken Sie diese Ressourcen:
Schneeflocken-Leitfaden
- Snowflake 101: Einführung in die Snowflake Data Cloud
- Wie man Amazon S3-Daten in Snowflake importiert
- Wie man JSON-Daten in Snowflake abfragt
- CSV-Dateien von S3 in Snowflake laden
- Snowflake: Verwendung von Analytik und statistischen Funktionen
- Snowflake-Fensterfunktionen: Partitionieren nach und ordnen nach
- Schneeflocken-Verzögerungsfunktion und gleitende Durchschnitte
- Snowflake SQL Aggregate Functions & Table Joins
- Benutzerdefinierte Funktionen (UDFs) in Snowflake
- Schneeflockenströme erstellen und nutzen
- Verwendung von gespeicherten Verfahren in Snowflake
- Schneeflocke vs. Redshift: Was ist der Unterschied und wie wählt man?
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.