




Auf einen Blick: Das Abfragen von JSON-Daten in Snowflake erleichtert eine effektive Verwaltung und Analyse strukturierter Daten. Das Tutorial behandelt das Erstellen von Tabellen mit JSON-Spalten, das Einfügen verschiedener JSON-Typen und das Abfragen von Daten mit unterschiedlichen Methoden.
- Schritte, um eine Tabelle mit einer JSON-Spalte zu erstellen und Daten einzufügen.
- Methoden zur Abfrage von JSON-Daten, einschließlich des Zugriffs auf verschachtelte Attribute und die Verwendung der Flatten-Funktion.
Wir haben Ihnen bereits gezeigt, wie man eine Variantenspalte in einer Snowflake-Tabelle erstellt, wobei Variante JSON bedeutet. In diesem Tutorial zeigen wir, wie man diese JSON-Spalten abfragt.
Erstellen Sie eine Tabelle mit einer JSON-Spalte
Erstellen Sie zuerst eine Datenbank oder verwenden Sie die Inventardatenbank , die wir im letzten Beitrag erstellt haben, und erstellen Sie dann eine Tabelle mit einer Spalte der Typvariante:
    use database inventory;
create table jsonRecord(jsonRecord variant);
JSON-Daten zu Snowflake hinzufügen
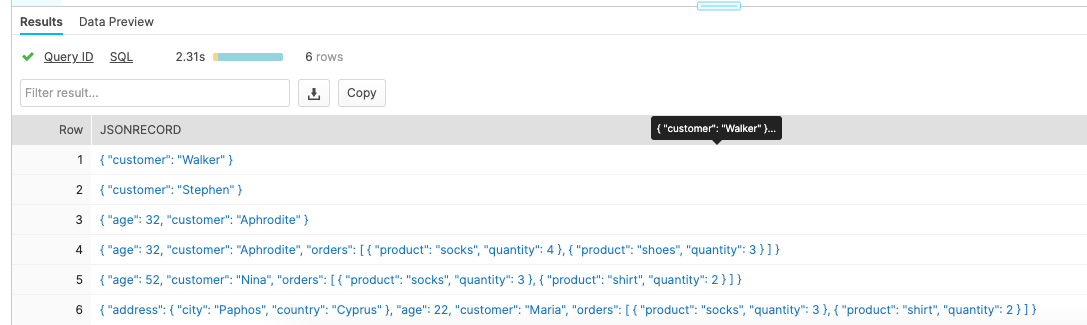
Dann fügen wir einige Daten hinzu. Wir fügen einfache JSON-, verschachtelte JSON- und JSON-Arrays hinzu (i.e. JSON Objekte in Klammern []), um zu zeigen, wie man jeden Typ abfragt. Beachten Sie die Funktion parse_json().
    INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON('{"customer": "Walker"}');
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON('{"customer": "Stephen"}');
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON('{"customer": "Aphrodite", "age": 32}');
Diese Datensätze enthalten ein JSON-Array, Befehle.
    i
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON(' {
            "customer": "Aphrodite",
            "age": 32,
            "orders": [{
                                    "product": "socks",
                                    "quantity": 4
                        },
                        {
                                    "product": "shoes",
                                    "quantity": 3
                        }
            ]
 }');
INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON(' {
            "customer": "Nina",
            "age": 52,
            "orders": [{
                                    "product": "socks",
                                    "quantity": 3
                        },
                        {
                                    "product": "shirt",
                                    "quantity": 2
                        }
            ]
 }');
Dieser Datensatz enthält verschachteltes JSON, also ein Attribut, eine Adresse, deren Wert ein weiteres JSON-Objekt ist.
    INSERT INTO JSONRECORD (jsonrecord) select PARSE_JSON(' {
            "customer": "Maria",
            "age": 22,
     "address" : { "city": "Paphos", "country": "Cyprus"},
            "orders": [{
                                    "product": "socks",
                                    "quantity": 3
                        },
                        {
                                    "product": "shirt",
                                    "quantity": 2
                        }
            ]
 }');
Wählen Sie nun die Taste * aus JSONRECORD, um alle Datensätze anzuzeigen. Beachten Sie, dass diese groß- und kleinschreibungssensitiv sind:
- Funktion
- Säule
- Tabellennamen
Wie man JSON-Daten in Snowflake auswählt
Das Format zur Datenauswahl umfasst alle folgenden Aspekte:
- tableName:Attribut
- tableName.attribute.JsonKey
- tableName.attribute.JsonKey[arrayIndex]
- tableName.attribute['JsonKey']
- get_path(tableName, Attribut)
Hier wählen wir den Kundenschlüssel aus dem JSON-Datensatz aus. Im JSON nennen wir die Schlüssel-Wertpaare der Artikel, wie: {"schlüssel": "wert"}.
select jsonrecord:customer from JSONRECORD;
Sehen Sie so aus:
Wir können auch die get_path()-Funktion verwenden:
select get_path(jsonrecord, 'address') from JSONRECORD;
Hier fügen wir eine where-Klausel hinzu, wobei wir dieselbe Doppelpunkt(:)- und Punkt-(.)-Notation verwenden wie auf der anderen Seite der Select-Aussage.
select jsonrecord:address.city from JSONRECORD where jsonrecord:customer = 'Maria';
Wir verwenden einen alternativen Ansatz. Wir erhalten verschachtelte JSON-Objekte, indem wir die Schlüssel in Klammern setzen [].
select jsonrecord['address']['city'] from JSONRECORD where jsonrecord:customer = 'Maria';
Werte, die nicht existieren, werden als NULL angezeigt.

Hier wählen wir das erste Element aus einem Array, da der Array-Index (er beginnt bei 0).
select jsonrecord['orders'][0] from JSONRECORD where jsonrecord:customer = 'Maria';
Hier verwenden wir den Doppelpunkt (:), um dieselbe Spalte zu erhalten.
select jsonrecord:orders[0] from JSONRECORD where jsonrecord:customer = 'Maria';
Ergebnisse:
{ "product": "socks", "quantity": 3 }
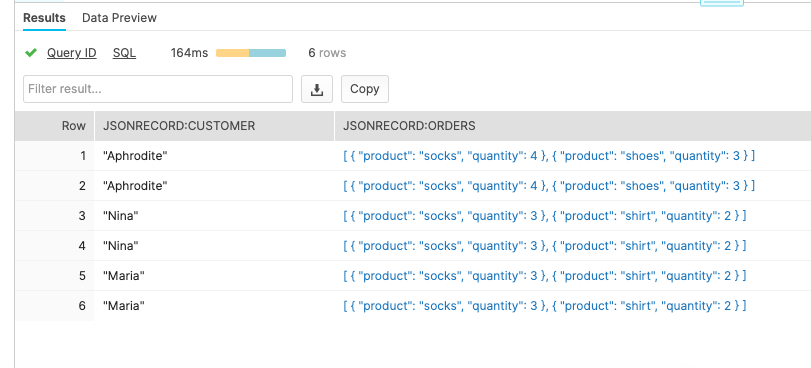
Hier flachen wir das Array. Dieser Datensatz hat zwei Order-JSON-Datensätze. Er zeigt also zwei Zeilen in den Ergebnissen an, wobei jeder Datensatz den anderen Attributen zugeordnet ist. Mit anderen Worten: Er verteilt ihn auf array_size Zeilen und füllt die anderen Spalten mit den Nicht-Array-Spalten in der Select-Anweisung. Man kann es sich so vorstellen, wie man einfach alle Bestellungen eines Kunden zeigt, bei denen die Bestelldaten und Kundendaten wiederholt werden, um es leicht sichtbar zu machen:
    select jsonrecord:customer, jsonrecord:orders  from JSONRECORD ,
   lateral flatten(input => jsonrecord:orders) prod ;
BMC, Control-M unterstützen Snowflake
BMC ist Mitglied des Snowflake Technology Alliance Partner-Programms. Die Cloud-Datenplattform von Snowflake hilft Kunden, das datengetriebene Unternehmen mit Snowflakes marktführendem, cloudbasiertem Data Warehouse und Control-M, unserer marktführenden Workflow-Orchestrierungsplattform für Unternehmensanwendungen, zu beschleunigen.
Zusätzliche Ressourcen
Für weitere Tutorials wie dieses entdecken Sie diese Ressourcen:
- BMC Machine Learning & Big Data Blog
- AWS Guide mit 15 Artikeln und Tutorials
- Amazon Braket Quantum Computing: So starten Sie
Schneeflocken-Leitfaden
- Snowflake 101: Einführung in die Snowflake Data Cloud
- Wie man Amazon S3-Daten in Snowflake importiert
- Wie man JSON-Daten in Snowflake abfragt
- CSV-Dateien von S3 in Snowflake laden
- Snowflake: Verwendung von Analytik und statistischen Funktionen
- Snowflake-Fensterfunktionen: Partitionieren nach und ordnen nach
- Schneeflocken-Verzögerungsfunktion und gleitende Durchschnitte
- Snowflake SQL Aggregate Functions & Table Joins
- Benutzerdefinierte Funktionen (UDFs) in Snowflake
- Schneeflockenströme erstellen und nutzen
- Verwendung von gespeicherten Verfahren in Snowflake
- Schneeflocke vs. Redshift: Was ist der Unterschied und wie wählt man?
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.