




Auf einen Blick: Snowflake ist eine cloudbasierte Data-Warehouse-Plattform, die für skalierbares Datenmanagement unter Verwendung von ANSI-konformem SQL entwickelt wurde. Sie verfügt über eine Weboberfläche, mehrere Client-Connectors und robuste Sicherheitsmaßnahmen, was sie ideal für die Verarbeitung großer Datenmengen macht.
- Unterstützt verschiedene Datenformate und Lademethoden.
- Bietet eine kostenlose 30-tägige Testphase für neue Nutzer an.
Mit dem stetigen Anstieg von Datenvolumen und -geschwindigkeit suchen Organisationen nach Lösungen zur Verarbeitung von Big Data und damit verbundenen Herausforderungen. Eine der ersten Entscheidungen, die Organisationen treffen? Die Einführung eines cloudbasierten Modells, das Flexibilität, Skalierbarkeit und hohe Leistung bietet.
Snowflake ist eine cloudbasierte Data-Warehouse-Plattform, die dank ihrer zahlreichen Funktionen und Effizienz an Beliebtheit gewinnt.
In diesem Artikel tauchen wir in die Architektur von Snowflake, die wichtigsten Funktionen und den Zweck ein, den es löst.
Was ist Snowflake?
Snowflake ist eine SaaS-basierte Data Warehouse (DWH)-Plattform, die über eine AWS- oder MS Azure-Cloud-Infrastruktur läuft. (Vielleicht hörst du das als Data Warehouse as a Service.)
Im Gegensatz zu anderen Warehouse-Lösungen nutzt Snowflake eine verbesserte, ANSI-konforme SQL-Engine, die ausschließlich in der Cloud arbeitet.
Grundsätzlich ermöglicht die Kernarchitektur von Snowflake, in der Public Cloud zu laufen, mit virtuellen Recheninstanzen und effizienten Storage Buckets, was es zu einer hoch skalierbaren und kosteneffizienten Lösung zur Verarbeitung enormer Mengen an Big Data macht.
(Verstehen Sie die Unterschiede zwischen Data Warehouses und Datenbanken.)
Hauptmerkmale von Snowflake
Im Vergleich zu alten DWH-Technologien bietet Snowflake eine Reihe von Funktionen, darunter:
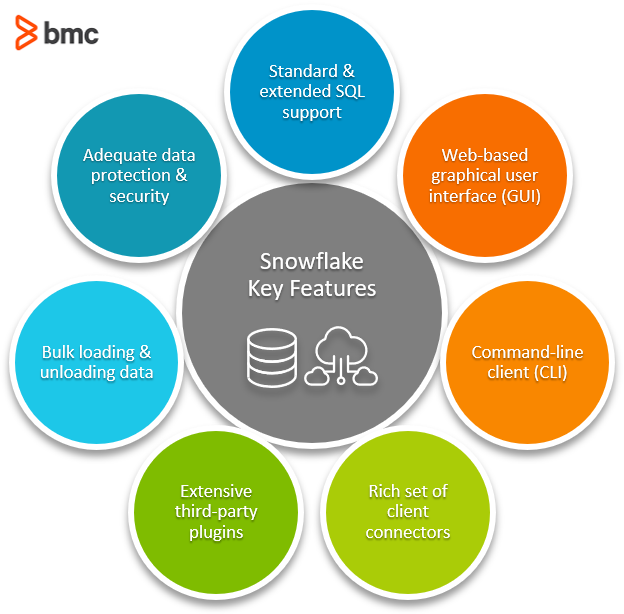
Standard- und erweiterte SQL-Unterstützung
Als SQL-basiertes Data Warehouse unterstützt es die spezifizierten datendefinierten Sprache und die DML-Befehle für Datenmanipulationssprache, die von SQL verwendet werden. Es bietet außerdem fortschrittliche DML-Befehle für Multi-Table-Operationen wie INSERT, MERGE und MULTI-MERGE.
Mit Snowflake können Nutzer:
- Einrichtung temporärer und vorübergehender Tabellen für Kurzzeitdaten
- Verwenden Sie analytische und statistische Aggregatfunktionen sowie laterale Ansichten
- Erstellen benutzerdefinierter Funktionen (UDFs), um die Funktionalität sowohl in SQL als auch in JavaScript zu erweitern
(Vergleiche SQL- und No-SQL-Datenspeicher .)
Webbasierte grafische Benutzeroberfläche (GUI)
Snowflake bietet eine Weboberfläche, mit der Nutzer mit der Data Cloud interagieren können. Mit der Web-GUI können Nutzer:
- Verwalte ihr Konto und andere allgemeine Einstellungen
- Ressourcen und Systemnutzung überwachen
- Abfragedaten
Kommandozeilen-Client (CLI)
Snowflake bietet eine auf Python basierende CLI namens SnowSQL zur Verbindung mit dem DWH. Es ist ein separates, herunterladbares und installierbares Terminaltool zur Ausführung aller Abfragen, einschließlich Datendefinition und Datenmanipulationsanfragen zum Laden und Entladen von Daten.
(Beginnen Sie mit unserer Einführung zu Python.)
Reiche Menge von Client-Connectoren
Snowflake bietet eine breite Palette von Connectors und Treibern, die Nutzer nutzen können, um sich mit ihrer Data Cloud zu verbinden. Einige dieser Client-Connectors sind:
- Python Connector, eine Programmierschnittstelle zum Schreiben von Python-Anwendungen, die mit Snowflake verbunden sind
- NodeJS-Treiber
- ODBC-Treiber für die Entwicklung von C/C++
- JBDC-Treiber für Java-Programmierung
Umfangreiche Drittanbieter-Plugins
Neben den oben genannten programmatischen Schnittstellen integrieren sich mehrere weitere Big-Data-Tools mit Snowflake. Diese Tools reichen von Business-Intelligence-Tools über Datenintegration, maschinelles Lernen, Sicherheit bis hin zu Governance-Software.
Massenbe- und Entladungsdaten
Snowflake ermöglicht das Laden von Daten in verschiedenen Formaten und aus verschiedenen Datenquellen – solange die Daten eine unterstützte Zeichenkodierung verwenden. Benutzer können Daten laden von:
- Komprimierte Dateien
- AWS S3-Datenquellen
- Lokale Dateien
- Flache Datendateien wie CSV und TSV
- Datendateien in den Formaten Avro, JSON, ORC, Parquet und XML
Zusätzlich können Nutzer mit Snowpipe kontinuierlich Daten in Chargen aus Snowflake-Stages, AWS S3 oder Azure-Speicher laden.
Angemessene Implementierung von Datenschutz und -sicherheit
Mit Snowflake können Nutzer:
- Stellen Sie Bereiche für die Datenspeicherung fest, um den regulatorischen Richtlinien zu entsprechen
- Passen Sie ihre Sicherheitsstufen entsprechend den Anforderungen an
Snowflake verschlüsselt außerdem automatisch Daten. Objektebene Zugriffskontrolle bietet eine detaillierte Kontrolle darüber, wer auf was zugreifen kann.
Schneeflockenarchitektur
Snowflake folgt einer Mischung aus Shared-Disk und Shared-Nothing-Datenbankarchitektur . Es besteht aus:
- Ein zentrales Repository, das Daten speichert
- Rechenknoten im Data Warehouse können auf diesen Basisspeicher zugreifen
Für die Ausführung von Abfragen verwendet Snowflake verteilte Massively Parallel Processing (MPP)-Cluster-Knoten, von denen jeder seinen eigenen lokalen Speicher zur Speicherung von Datenabschnitten, CPU und Speicher besitzt.
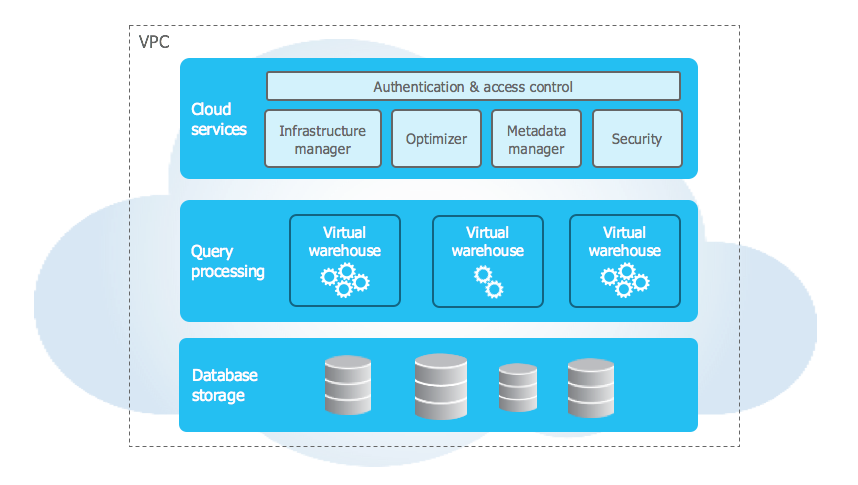
Das Snowflake-Framework ist typischerweise in drei Schichten aufgeteilt. Alle diese Schichten sind unabhängig voneinander und können einzeln skaliert, konfiguriert und verwaltet werden. Zu diesen Schichten gehören:
- Speicherschicht
- Rechenschicht
- Cloud-Services-Schicht
Speicherschicht
Die Schicht, auf der sich das zentrale Repository befindet. Alle im System geladenen Daten werden in Snowflakes komprimiertes, intern optimiertes Spaltenformat partitioniert und neu organisiert, mit AES 256 verschlüsselt und anschließend in der Cloud gespeichert. Snowflake führt die Partitionierung automatisch durch, stellt jedoch Einstellungen zur Verfügung, mit denen Benutzer Partitionsparameter konfigurieren können.
Die in dieser Schicht gespeicherten Daten sind zentral, und alle Knoten im Cluster können darauf zugreifen. Snowflake verwaltet alle Aspekte der Datenspeicherung und ermöglicht es den Nutzern, nur über SQL-Abfragen mit den zugrundeliegenden Daten zu interagieren.
Rechenschicht
Die Rechenschicht übernimmt die Ausführung von Abfragen. Dies geschieht über virtuelle Warehouses – das sind unabhängige MPP-Rechencluster mit mehreren Rechenknoten.
Snowflake weist diese Rechenknoten von einem gewählten Cloud-Anbieter jedem Nutzer zu. Diese Cluster sind autonom – verfügen über eigene CPU, Speicher und lokalen Speicher – wobei die Leistung eines Clusters die anderen nicht beeinflusst.
Cloud-Services-Schicht
Snowflake bietet eine Sammlung von Diensten zur Verwaltung und Verwaltung einer Snowflake-Datencloud. Auf dieser Ebene finden mehrere Aktivitäten statt:
- Zugangskontrolle
- Authentifizierung
- Infrastrukturmanagement
- Metadatenverwaltung
- Abfrageparsing
- Optimierung
Warum Snowflake verwenden?
Es gibt viele Gründe, warum Organisationen sich für Snowflake entscheiden. Hier sind die wichtigsten Gründe:
- Die hybride Architektur bietet den Nutzern das Beste aus beiden Welten. Die Nutzer zahlen separat für das zugrundeliegende zentrale Repository und so viel Rechenleistung, wie sie benötigen.
- SQL-basiert für schnelles Lernen. Eine SQL-basierte Implementierung stellt sicher, dass Entwickler keine steile Lernkurve durchlaufen müssen, um neue Technologien zu verstehen.
- Daten zuerst. Unterstützt Datenklonen und sicheren Datenaustausch.
- Keine Infrastrukturkonfiguration. Snowflake benötigt keine Infrastrukturkonfiguration – stattdessen erledigt Snowflake dies automatisch, sobald Sie den bevorzugten Cloud-Service-Anbieter ausgewählt haben.
Einstieg mit Snowflake
Bereit, loszulegen? Snowflake bietet derzeit eine 30-tägige kostenlose Testphase für neue Nutzer an. Sobald Sie Zugang haben, können Sie:
- Sehen Sie sich unser Menü "Schneeflockenleitfaden" rechts für mehrere Tutorials an.
- Siehe die offizielle Dokumentation
Schneeflocke ist Wolkenheimisch
Cloud-native Dienste sind die neue Normalität.
Snowflake ist ein DWH-Service, der speziell für die Cloud entwickelt wurde und es Organisationen ermöglicht, enorme Big-Data-Speicherung und -verarbeitung zu bewältigen, indem Rechenleistung und Speicher unabhängig skaliert werden können. Für schnellere Abfrageausführung und verbesserte Leistung ermöglicht Snowflake Nutzern, mit zusätzlichen Data Warehouses zu skalieren, indem zusätzliche Rechenressourcen bei Bedarf bereitgestellt werden.
Snowflake ermöglicht effiziente Analysen in großem Maßstab – und wenn Sie Snowflake-Workloads mit Control-M orchestrieren, fügen Sie Enterprise Scheduling, SLA-Management und systemübergreifende Abhängigkeitsbehandlung hinzu, um Snowflake-Datenpipelines zuverlässig in der Produktion zu gewährleisten.
Verwandte Literatur
- BMC Machine Learning & Big Data Blog
- Verwendung von gespeicherten Verfahren in Snowflake
- MySQL vs. MongoDB: Vergleich von Datenbanken, Teil unseres MongoDB-Leitfadens
- DataOps erklärt: Verstehen Sie, wie DataOps Analysen nutzt, um umsetzbare Geschäftserkenntnisse zu liefern
- Datenarchitektur erklärt: Komponenten, Standards und sich verändernde Architekturen
- Datenethik für Unternehmen
Schneeflocken-Leitfaden
- Snowflake 101: Einführung in die Snowflake Data Cloud
- Wie man Amazon S3-Daten in Snowflake importiert
- Wie man JSON-Daten in Snowflake abfragt
- CSV-Dateien von S3 in Snowflake laden
- Snowflake: Verwendung von Analytik und statistischen Funktionen
- Snowflake-Fensterfunktionen: Partitionieren nach und ordnen nach
- Schneeflocken-Verzögerungsfunktion und gleitende Durchschnitte
- Snowflake SQL Aggregate Functions & Table Joins
- Benutzerdefinierte Funktionen (UDFs) in Snowflake
- Schneeflockenströme erstellen und nutzen
- Verwendung von gespeicherten Verfahren in Snowflake
- Schneeflocke vs. Redshift: Was ist der Unterschied und wie wählt man?
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.