




Auf einen Blick: Der Import von Daten von Amazon S3 nach Snowflake erfordert die Erstellung eines Lagers, einer externen Stufe und einer Datenbank, gefolgt vom Datenupload und der SQL-Ausführung. Die Control-M-Plattform von BMC unterstützt diese Integration.
- Nutzen Sie den COPY-Befehl von Snowflake für effizientes Datenladen.
- Externe Stufen verbessern das Datenmanagement und vereinfachen den Zugriff.
In diesem Artikel zeigen wir, wie man JSON-Daten von Amazon S3 in Snowflake lädt.
Snowflake- und JSON-Dateien
Snowflake ist ein Data Warehouse auf AWS. Der Befehl Snowflake COPY ermöglicht es Ihnen, JSON-, XML-, CSV-, Avro-, Parquet- und XML-Formatdateien zu kopieren. Aber zu behaupten, Snowflake unterstützte JSON-Dateien, ist etwas irreführend – es analysiert diese Datendateien nicht, wie wir in einem Beispiel mit Amazon Redshift gezeigt haben. Stattdessen kopiert Snowflake die gesamten Daten in eine Snowflake-Spalte mit Typvariante. Dann führen Sie JSON-SQL-Abfragen darauf aus. Wir laden zwei Datendateien, die Sie hier herunterladen können:
Hinweis: Dies ist im NDJSON-Format . Das bedeutet, dass die gesamte Datei keine gültige JSON-Datei ist. Stattdessen besteht sie aus einzelnen JSON-Datensätzen.
Datenbank und Lager erstellen
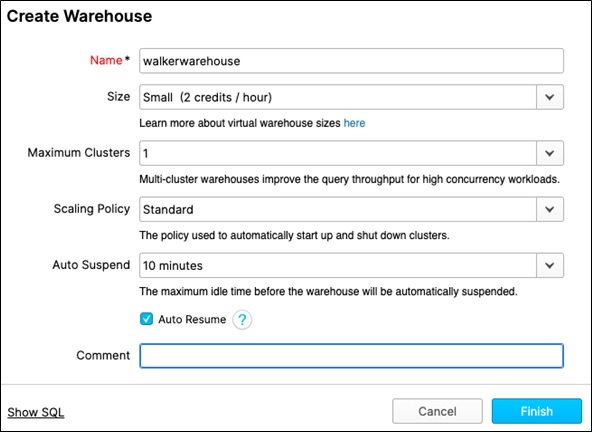
Wir betreiben unseren Snowflake-Cluster auf Amazon AWS. (Er ist in der Amazon AWS Console nicht als Dienst gelistet. Stattdessen meldet man sich auf der Snowflake-Website an, dann startet eine Instanz in den Clouds von Amazon, Microsoft oder Google.) Man erstellt ein Warehouse wie dieses. Hier wählt man den Maschinenstandort und die Anzahl der Server aus, und wählt somit die Rechenleistung und die Kosten aus.
Externe Stufe erstellen
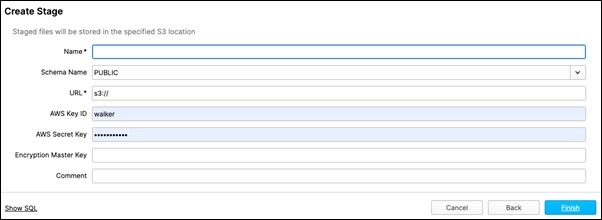
Man kann Daten direkt von Amazon S3 kopieren, aber Snowflake empfiehlt, den externen Bühnenbereich zu nutzen. Sie geben dafür keinen Grund. Das bedeutet aber, dass man seine Zugangsdaten speichern und somit die Kopiersyntax vereinfachen kann sowie Wildcard-Muster verwendet, um Dateien auszuwählen, wenn man sie kopiert.
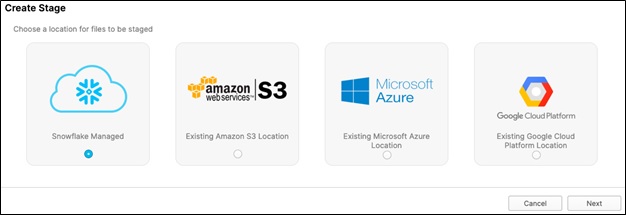
Du gibst ihm einen Namen und verweist auf einen S3-Eimer.
Eine Datenbank erstellen
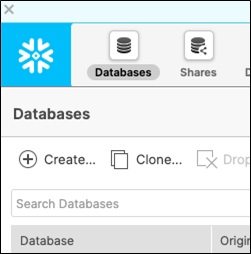
Wie bei anderen Datenbanken ist eine Datenbank eine Sammlung von Tabellen. In diesem einfachen Beispiel ist es also nur ein Name. Erstelle sie aus der Snowflake-Konsole so:
Tabellen erstellen
Öffne als Nächstes den Arbeitsblatt-Editor und füge dieses SQL ein, um die Tabellen für Kunden und Bestellungen zu erstellen. Beachte, dass beide eine Spalte mit Typvariante haben.
    use database inventory;

create table customers (customer variant);

create table orders(orders variant);
Lade JSON-Daten auf S3 hoch
Kopieren Sie die Daten über die Amazon S3-Konsole oder die AWS CLI-Befehlszeile nach S3:
    aws s3 cp customers.json s3:/(bucket name)

aws s3 cp orders.json s3://(bucket name)
Laden Sie die JSON-Daten in Bulk-Masse in Snowflake
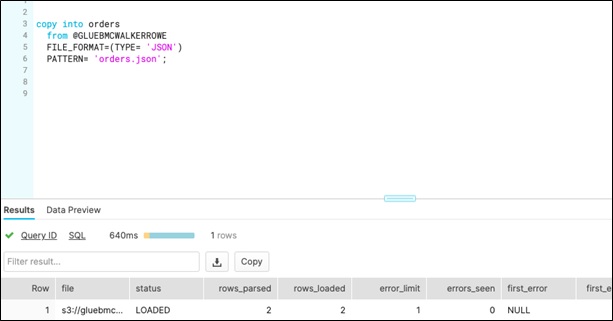
Kopiere die Kunden- und Bestelldaten so in Snowflake. Da dieser S3-Bucket beide Dateien enthält, geben wir den Namen mit PATTERN an. Das kann jeder reguläre Ausdruck sein.
    copy into customers
  from @GLUEBMCWALKERROWE
  FILE_FORMAT=(TYPE= 'JSON')
  PATTERN= 'customers.json';
Eine nervige Funktion ist, dass man das Kontrollkästchen Alle Anfragen aktivieren muss, um den Ausführen-Button zu aktivieren:
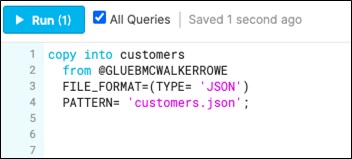
Das Arbeitsblatt sieht so aus, wenn man das SQL ausführt.
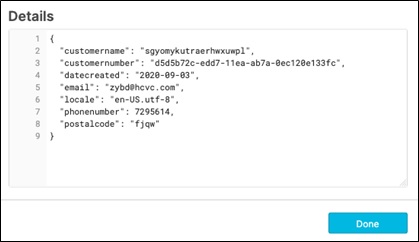
Klicken Sie dann auf die Datei und sehen die Daten, die geladen wurden.
BMC, Control-M unterstützen Snowflake
BMC ist Mitglied des Snowflake Technology Alliance Partner-Programms. Die Cloud-Datenplattform von Snowflake hilft Kunden, das datengetriebene Unternehmen mit Snowflakes marktführendem, cloudbasiertem Data Warehouse und Control-M, unserer marktführenden Workflow-Orchestrierungsplattform für Unternehmensanwendungen, zu beschleunigen.
Zusätzliche Ressourcen
Für weitere Tutorials wie dieses entdecken Sie diese Ressourcen:
- BMC Machine Learning & Big Data Blog
- AWS Guide mit 15 Artikeln und Tutorials
- Amazon Braket Quantum Computing: So starten Sie

Schneeflocken-Leitfaden
- Snowflake 101: Einführung in die Snowflake Data Cloud
- Wie man Amazon S3-Daten in Snowflake importiert
- Wie man JSON-Daten in Snowflake abfragt
- CSV-Dateien von S3 in Snowflake laden
- Snowflake: Verwendung von Analytik und statistischen Funktionen
- Snowflake-Fensterfunktionen: Partitionieren nach und ordnen nach
- Schneeflocken-Verzögerungsfunktion und gleitende Durchschnitte
- Snowflake SQL Aggregate Functions & Table Joins
- Benutzerdefinierte Funktionen (UDFs) in Snowflake
- Schneeflockenströme erstellen und nutzen
- Verwendung von gespeicherten Verfahren in Snowflake
- Schneeflocke vs. Redshift: Was ist der Unterschied und wie wählt man?
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.