




Auf einen Blick: Interpretierbarkeit und Erklärbarkeit sind entscheidend für das Verständnis von Machine-Learning-Modellen. Interpretierbarkeit bezieht sich auf kausale Zusammenhänge, während Erklärbarkeit die Parametersignifikans klärt, die sowohl für den Vertrauensaufbau als auch für ethische KI unerlässlich ist.
- Eine hohe Interpretierbarkeit ist in risikoreichen Situationen entscheidend für die Verantwortlichkeit.
- Erklärbarkeit hilft, Vorurteile in automatisierten Entscheidungsprozessen zu reduzieren.
Interpretierbarkeit hängt davon ab, wie genau ein Machine-Learning-Modell eine Ursache einer Wirkung zuordnen kann. Erklärbarkeit hängt mit der Fähigkeit der Parameter zusammen, die oft in Deep Nets verborgen sind, die Ergebnisse zu rechtfertigen.
Dies ist ein langer Artikel. Halte durch, und am Ende wirst du verstehen:
- Wie sich Interpretierbarkeit von Erklärbarkeit unterscheidet
- Warum ein Modell interpretierbar und/oder erklärbar sein muss
- Wer arbeitet daran, das Black-Box-Problem zu lösen – und wie
Was ist Interpretierbarkeit?
Verursacht Chipotle Bauchschmerzen? Begünstigt lauter Lärm den Hörverlust? Sind Frauen weniger aggressiv als Männer? Wenn ein Machine-Learning-Modell eine Definition für diese Beziehungen schaffen kann, ist sie interpretierbar.
Alle Modelle müssen mit einer Hypothese beginnen. Menschliche Neugier treibt ein Wesen dazu an, intuitiv zu erkennen, dass das eine mit dem anderen zusammenhängt. "Hmm... mehrere schwarze Menschen, die von Polizisten erschossen wurden... scheinbar unverhältnismäßig gegenüber anderen Rassen... könnte etwas systemisch sein?" Erkunde.
Menschen erstellen interne Modelle , um ihre Umgebung zu interpretieren . Im Bereich des maschinellen Lernens können diese Modelle entweder als genaue oder ungenaue Darstellungen der Welt getestet und verifiziert werden.
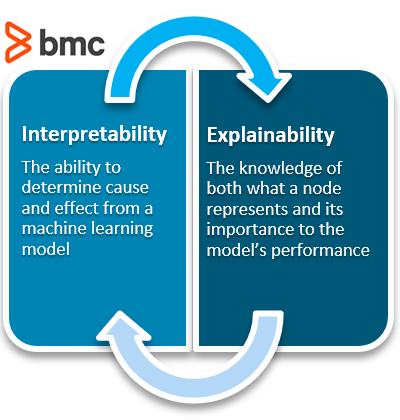
Interpretierbarkeit bedeutet, dass Ursache und Wirkung bestimmt werden können.
Wenn ein Modell die Eingaben nehmen kann und routinemäßig dieselben Ausgaben erhält, ist das Modell interpretierbar:
- Wenn du deine Pasta zum Abendessen zu viel isst und immer Schlafprobleme hast, ist die Situation interpretierbar.
- Wenn alle Umfragen von 2016 einen demokratischen Sieg zeigten und der republikanische Kandidat sein Amt antrat, zeigten all diese Modelle eine geringe Interpretierbarkeit. Wenn das Ziel der Meinungsforscher ein gutes Modell ist, wozu die Institution des Journalismus gezwungen ist – die Wahrheit zu berichten – dann zeigt der Fehler, dass ihre Modelle aktualisiert werden müssen.
Geringe Interpretierbarkeit
Interpretierbarkeit stellt in risikoarmen Szenarien kein Problem dar. Wenn ein Modell Filme empfiehlt, kann das eine risikoarme Aufgabe sein. (Außer du bist einer der großen Inhaltsanbieter und all deine Empfehlungen sind so schlecht, dass die Leute das Gefühl haben, ihre Zeit zu verschwenden, aber du verstehst, was ich meine). Wenn ein Modell generiert, welche Farbe deine Lieblingsfarbe des Tages sein wird, oder einfache Yogi-Ziele, auf die du dich im Laufe des Tages konzentrieren kannst, spielen sie Low-Stakes Spiele und die Interpretierbarkeit des Modells ist nicht nötig.
Die Notwendigkeit hoher Interpretierbarkeit
Die Interpretierbarkeit muss manchmal hoch sein, um zu rechtfertigen, warum ein Modell besser ist als ein anderes.
In Moneyball hatten die alten Scouts ein interpretierbares Modell, mit dem sie gute Spieler für Baseballteams auswählten; das waren keine maschinellen Lernmodelle, aber die Scouts hatten ihre Methoden (im Grunde einen Algorithmus) entwickelt, um auszuwählen, welcher Spieler in einer Saison im Vergleich zu einer anderen gut abschneidet. Aber der Cheftrainer wollte diese Methode ändern.
Damit Billy Beanes Methoden funktionierten und die Methodik sich durchsetzte, musste sein Modell hochinterpretierbar sein, wenn es allem widersprach, was die Branche für wahr gehalten hatte. Hohe Modellinterpretierbarkeit gewinnt Argumente.
Risiko und Verantwortung
Ein Modell mit hoher Interpretierbarkeit ist in einem Spiel mit hohem Risiko wünschenswert. Gut interpretierbare Modelle bedeuten, dass man eine andere Partei haftbar machen kann. Und wenn Modelle vorhersagen, ob eine Person Krebs hat, müssen Menschen für die getroffene Entscheidung zur Rechenschaft gezogen werden. Hochinterpretierbare Modelle und die Aufbewahrung hoher Interpretierbarkeit als Designstandard können dazu beitragen, Vertrauen zwischen Ingenieuren und Nutzern aufzubauen.
Es ist schon schlimm genug, wenn die Befehlskette verhindert, dass eine Person mit der Partei sprechen kann, die für die Entscheidung verantwortlich ist. Es ist viel schlimmer, wenn es keine verantwortliche Partei gibt und es sich um ein Machine-Learning-Modell handelt, dem alle die Verantwortung zuschreiben. Es gibt keine Vergeltung, dem Modell für seine Handlungen eine Strafe zu geben.
Wenn Theranos es nicht schaffte, aus einem "einzigen Bluttropfen" genaue Ergebnisse zu liefern, konnten die Menschen sich von der Unterstützung des Unternehmens zurückziehen und zusehen, wie es und seine betrügerischen Führungskräfte bankrottgingen.
Schließlich ermöglicht die hohe Interpretierbarkeit es den Leuten, das System zu spielen. Wenn der Lehrer eine Bewertungsmatrix ausgibt, die zeigt, wie er den Test bewertet, muss der Schüler nur seine Antworten für den Test abspielen. Wenn der Lehrer ein Wayne's World-Fan ist, weiß der Schüler, dass er Anekdoten in Wayne's World teilen muss. Oder, wenn der Lehrer wirklich sicherstellen will, dass der Schüler den Prozess versteht, wie Bakterien Proteine im Magen abbauen, sollte der Schüler nicht die Arten von Proteinen und Bakterien beschreiben, die existieren. Stattdessen sollte er direkt in das einsteigen, was das Bakterium tut.
Die Schüler fanden heraus, dass das automatische Bewertungssystem oder der SAT tatsächlich nicht verstehen konnte, was in ihren Prüfungen geschrieben wurde. Irgendwie erhielten die Schüler Zugang zu den Informationen eines hochinterpretierbaren Modells. Die ML-Klassifikatoren auf den Robo-Graders bewerteten längere Wörter besser als kürzere; so einfach war das. Eine Kette von 10-Dollar-Wörtern konnte höher punkten als ein vollständiger Satz mit 5-Cent-Wörtern, einem Subjekt und Prädikat.
Wie VICE berichtete: "Der BABEL-Generator hat bewiesen, dass man völlige Inkohärenz haben kann, das heißt, ein Satz hatte nichts mit einem anderen zu tun, und trotzdem eine hohe Note von den Algorithmen erhalten kann." Natürlich nutzten die Studierenden diese Gelegenheit.
Da ich selbst im NLP-Bereich gearbeitet habe, sind diese immer noch nicht fehlerfrei, aber die Leute entwickeln Wege, damit der Algorithmus erkennt, wann ein Text nur Kauderwelsch ist oder ob es zumindest einigermaßen kohärent ist.
Was ist Erklärbarkeit?
ML-Modelle werden oft als Black-Box-Modelle bezeichnet, da sie es erlauben, vom maschinellen Lernalgorithmus eine vorab festgelegte Anzahl leerer Parameter oder Knoten zuzuweisen. Konkret ist der Rückpropagationsschritt dafür verantwortlich, die Gewichte basierend auf seiner Fehlerfunktion zu aktualisieren.
Um vorherzusagen, wann eine Person sterben könnte – das spaßige Glücksspiel, das man bei der Berechnung einer Lebensversicherungsprämie eingeht, und die seltsame Wette, die eine Person beim Abschluss einer Lebensversicherung gegen ihr eigenes Leben eingeht – nimmt ein Modell dessen Eingaben auf und liefert eine prozentuale Chance, dass die betreffende Person bis zum 80. Lebensjahr lebt.
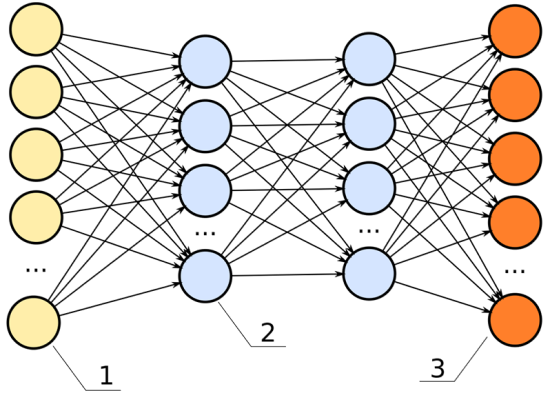
Unten ist ein Bild eines neuronalen Netzwerks zu sehen. Die Eingaben sind gelb; die Ausgaben sind orange. Wie ein Bewertungsraster für eine Gesamtnote zeigt die Erklärbarkeit, wie bedeutend jeder der Parameter, alle blauen Knoten, zur endgültigen Entscheidung beiträgt.
Zum Beispiel haben wir diese Dateneingaben:
- Alter
- BMI-Wert
- Anzahl der Jahre, die mit Rauchen verbracht wurden
- Karrierekategorie
Wenn dieses Modell eine hohe Erklärbarkeit hätte, könnten wir zum Beispiel sagen:
- Die Karrierekategorie ist etwa zu 40 % wichtig
- Die Anzahl der Jahre, in denen man geraucht hat, liegt bei 35 %
- Das Alter ist zu 15 % wichtig
- Der BMI-Wert ist zu 10 % wichtig
Erklärbarkeit: wichtig, aber nicht immer notwendig
Erklärbarkeit wird im Bereich des maschinellen Lernens wichtig, weil sie oft nicht ersichtlich ist. Erklärbarkeit ist oft unnötig. Ein Machine-Learning-Ingenieur kann ein Modell bauen, ohne jemals die Erklärbarkeit des Modells bedacht zu haben. Es ist ein zusätzlicher Schritt im Aufbauprozess – wie das Anlegen eines Sicherheitsgurts beim Autofahren. Sie ist für das Auto unnötig, bietet aber eine Versicherung bei einem Unfall.
Der Vorteil eines tiefen neuronalen Netzes für Ingenieure ist, dass es eine Black Box von Parametern erzeugt, wie gefälschte zusätzliche Datenpunkte, die es einem Modell ermöglichen, seine Entscheidungen zu stützen. Diese gefälschten Datenpunkte bleiben dem Ingenieur Unknown. Die Black Box oder versteckte Schichten ermöglichen es einem Modell, Assoziationen zwischen den gegebenen Datenpunkten herzustellen, um bessere Ergebnisse vorherzusagen. Wenn wir zum Beispiel entscheiden, wie lange jemand leben muss, und wir Karrieredaten als Eingabe verwenden, ist es möglich, dass das Modell die Karrieren von selbst in Hoch- und Risikoarme Karriereoptionen sortiert.
Vielleicht inspizieren wir einen Knoten und sehen, dass er Ölplattformarbeiter, Unterwasserschweißer und Bootsköche miteinander in Verbindung setzt. Es ist möglich, dass das neuronale Netz Verbindungen zwischen der Lebensspanne dieser Personen herstellt und einen Platzhalter im tiefen Netz legt, um diese zu verknüpfen. Wenn wir die einzelnen Knoten in der Black Box untersuchen würden, könnten wir feststellen, dass diese Clusterung Wasserkarrieren als risikoreichen Beruf interpretiert.
Im vorherigen Diagramm kann jede der Linien, die vom gelben zum blauen Punkt verbinden, ein Signal darstellen und die Bedeutung dieses Knotens bei der Bestimmung der Gesamtpunktzahl des Ausgangs abwägen.
- Wenn dieses Signal hoch ist, ist dieser Knoten für die Gesamtleistung des Modells von Bedeutung.
- Wenn dieses Signal niedrig ist, ist der Knoten unbedeutend.
Mit diesem Verständnis können wir Erklärbarkeit definieren als:
Wissen darüber, was ein Knoten repräsentiert und wie wichtig er für die Leistung des Modells ist.
Das "Wie" hinterfragen?
Bildklassifikationsaufgaben sind interessant, weil in der Regel nur eine Sequenz von Pixeln und Labels der Bilddaten bereitgestellt werden. Der allgemeine Zweck der Verwendung von Bilddaten ist es, zu erkennen, welche Objekte im Bild sind. Wenn Sie ein Bild eines Hundes eingeben würden, sollte das Ergebnis "Hund" sein. Wie dies geschieht, kann völlig Unknown sein, und solange das Modell funktioniert (hohe Interpretierbarkeit), besteht oft kein Zweifel daran, wie.
In Bilderkennungsalgorithmen, meist konvolutionellen neuronalen Netzwerken, enthalten ihre ersten Schichten Verweise auf Schattierung und Kantenerkennung. Der Mensch musste nie explizit eine Kante oder einen Schatten definieren, aber da beide bei jedem Foto gemeinsam sind, gruppieren sich die Merkmale als ein einzelner Knoten und der Algorithmus bewertet den Knoten als bedeutend für die Vorhersage des Endergebnisses. Das Bilderkennungsmodell wird erklärbarer.
Google hat sich kürzlich für die Ergebnisse seines Modells entschuldigt. Wie die Schlagzeile gerne sagt, hat ihr Algorithmus rassistische Ergebnisse erzeugt. Maschinelle Lernmodelle werden im Allgemeinen nicht verwendet, um eine einzige Entscheidung zu treffen. Sie werden, wie Software und Computer, entwickelt, um viele Entscheidungen immer und immer wieder zu treffen. Maschinelle Lernmodelle sind dafür gedacht, Entscheidungen im großen Maßstab zu treffen. Wenn diese Entscheidungen Vorurteile gegenüber einer Rasse oder einem Geschlecht enthalten und das Verhalten dieser Gruppen beeinflussen, kann das in sehr großem Maße Fehler machen.
Das Äquivalent wäre, einem Kind zu sagen, dass es die Süßigkeiten haben darf, während dem anderen gesagt wird, dass es es nicht darf. Die Entscheidung wird das Kind darauf konditionieren, Verhaltensentscheidungen ohne Süßigkeiten zu treffen. Bei ML passiert das im großen Maßstab und bei allen. Und – ein entscheidender Punkt – meistens haben die betroffenen Menschen keinen Bezugspunkt, um Vorurteile zu erheben. Sie wissen einfach, dass etwas passiert, das sie nicht ganz verstehen.
Zur Unterstützung der Erklärbarkeit
Für die aktivistischen Enthusiasten ist Erklärbarkeit für ML-Ingenieure wichtig, um sicherzustellen, dass ihre Modelle keine Entscheidungen aufgrund von Geschlecht, Rasse oder anderen Datenpunkten treffen, die sie ambivalent machen wollen. Die Entscheidungen, die Modelle auf Basis dieser Punkte treffen, können von Modell zu Modell schwerwiegend oder fehlerhaft sein.
Glücklicherweise gibt es in einer freien, demokratischen Gesellschaft Menschen wie Aktivisten und Journalisten weltweit, die Unternehmen in Schach halten und versuchen, diese Fehler wie bei Google aufzuzeigen, bevor Schaden entsteht. In einer Gesellschaft mit unabhängigen Auftragnehmern und vielen Remote-Mitarbeitern haben Unternehmen keine diktatorischen Regeln, um schlechte Modelle zu entwickeln und in die Praxis umzusetzen. Die Mitarbeiter vieler Unternehmen haben es leichter, ihre Ergebnisse anderen zu melden, und noch entscheidender sind sie in der Lage, Fehler zu korrigieren, die während ihrer täglichen Arbeit entstehen könnten.
Gute Kommunikation und demokratische Herrschaft gewährleisten eine Gesellschaft, die sich selbst korrigiert. Das gilt weiterhin für resiliente Ingenieurskunst und Chaos-Ingenieurwesen. Es gilt, wenn man die Unternehmens-Todesspirale vermeidet. Es ist ein Grund, erklärbare Modelle zu unterstützen. Erklärbare Modelle (XAI) verbessern die Kommunikation rund um Entscheidungen.
Durch die Erforschung der erklärbaren Komponenten eines ML-Modells und deren Anpassung ist es möglich, die Gesamtprognose anzupassen. Um auf ein weiteres heißes Thema auf einem anderen Spektrum hinzuweisen: Google hatte 2019 einen Wettbewerb auf Kaggle , um "Geschlechterbias bei der Pronomenauflösung zu beenden". Im Grunde verwenden natürliche Sprachprozesse (NLP) eine Technik namens Koreferenzauflösung, um Pronomen mit ihren Substantiven zu verknüpfen. Es ist zu einer Machine-Learning-Aufgabe geworden, das Pronomen "sie" nach der Verwendung des Wortes "Shauna" vorherzusagen.
Shauna mag Rennen. Das ist ihr Lieblingssport.
Die Koreferenz-Auflösung wird folgendes abbilden:
- Shauna → sie
- Rennen →
Diese Technik kann die bekannten Informationen in einem Datensatz um das 3- bis 5-fache erhöhen, indem alle Unknown Entities – die Shes, His, Its, Ihre, Them – durch die tatsächliche Entität ersetzt werden, auf die sie sich beziehen – Jessica, Sam, Spielzeuge, Bieber International. Das Ziel des Wettbewerbs war es, den internen Mechanismus aufzudecken, der das Geschlecht erklärt, und ihn umzubauen, um ihn auszuschalten.
Man könnte denken, dass große Unternehmen nicht darum kämpfen, diese Probleme zu beenden, aber ihre Ingenieure kommen aktiv zusammen, um die Probleme zu prüfen. Wirtschaftlich erhöht das ihr Wohlwollen.
Ich habe Google in diesem Artikel ziemlich oft verwendet, und Google ist nicht ein einziger Geist. Google ist eine kleine Stadt mit etwa 200.000 Beschäftigten, fast genauso vielen Zeitarbeitern, und sein Einfluss ist unermesslich. Amazon hat wahrscheinlich 900.000 Mitarbeiter in einer ähnlichen Situation mit Zeitarbeitern. Das sind viel zu viele Menschen, als dass es viel Geheimhaltung geben könnte. Enron hatte damals 29.000 Einwohner.
Lösung des Black-Box-Problems
Abschließend, um Google auf Hochtouren zu bringen, hat Susan Ruyu Qi einen Artikel mit einem guten Argument dafür zusammengestellt, warum Google DeepMind das Black-Box-Problem behoben haben könnte. Der Punkt ist: Erklärbarkeit ist ein Kernproblem, das das ML-Feld aktiv löst. Da alle viele Seiten desselben Problems angehen, wird es schwer sein, dass etwas wirklich Schlimmes jemandem unentdeckt unter die Nase rutscht.
Computer haben schon immer Außenseiter der Gesellschaft angezogen, die Menschen, gegen die große Systeme stets arbeiten. Diese Menschen schauen jeden Tag in den Spiegel auf Anomalien; sie sind die perfekten Wachhunde, um Codezeilen zu polieren, die bestimmen, wer wie behandelt wird. Erklärbarkeit und Interpretierbarkeit fügen den ML-Modellen eine beobachtbare Komponente hinzu, die es den Wachhunden ermöglicht, das zu tun, was sie bereits tun.
Es gibt auch Potenzial in der neuen Generation von Zwanzigern, die den Wert des Whistleblowers zu schätzen gelernt haben. Sie pflegen einen unabhängigen Moralkodex, der über allem anderen steht. Wenn Sie mir nicht glauben: Warum sonst glauben Sie, wechseln sie von Job zu Job?
Zusätzliche Ressourcen
Entdecken Sie den BMC Machine Learning & Big Data Blog und diese verwandten Ressourcen:
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.