




Auf einen Blick: Der R2-Wert und der mittlere Quadratfehler (MSE) sind entscheidende Kennzahlen zur Bewertung der Genauigkeit von Regressionsmodellen. Sie helfen zu bestimmen, wie gut unabhängige Variablen Variationen abhängiger Variablen erklären, was in Bereichen wie Finanzen und Gesundheitswesen von entscheidender Bedeutung ist.
- Der R2-Wert gibt den vom Modell erklärten Anteil der Varianz an.
- MSE misst die durchschnittliche quadratische Differenz zwischen beobachteten und vorhergesagten Werten.
Heute werden wir einige Begriffe vorstellen, die wichtig sind, um die Genauigkeit und Qualität von Regressionsmodellen zu bestimmen.
Wir veranschaulichen diese Konzepte mit scikit-learn.
Wie Regressionsmodelle verwendet werden
Das Verständnis dieser Kennzahlen hilft, festzustellen, ob Regressionsmodelle genau oder irreführend sind. Die Verwendung der statistischen Regressionstechnik hilft, Muster, Trends und Zusammenhänge in Daten hervorzuheben, die Einblicke in die Zukunft geben. Man kann sehen, wie unabhängige Variablen abhängige Variablen beeinflussen und wie stark diese Beziehungen sind.
Die Fähigkeit, in mögliche Zukünfte zu blicken und Zusammenhänge sowie Abhängigkeiten zu verstehen, ist für die Planung verschiedener Szenarien sowie für die Bewertung und Bewältigung von Risiken von unschätzbarem Wert. Verschiedene Hochrisiko-Branchen nutzen umfangreiche Regressionsmodelle, darunter:
- Finanzen
- Business Analytics
- Ingenieurwesen
- Gesundheitswesen
- Wissenschaft
- Sport
- Informatik
Warum der R2-Wert im maschinellen Lernen wichtig ist
Der Wert eines Regressionsmodells hängt von seiner Genauigkeit ab, insbesondere davon, wie gut es Datenvarianzen erklärt. Deshalb ist die Verbesserung des R2-Scores so wichtig. Maschinelles Lernen und KI arbeiten zusammen, um die richtigen Variablen zu identifizieren, Modelle für bessere Vorhersagen zu optimieren und schwer zu identifizierende Beziehungen in riesigen, komplexen und nichtlinearen Datensätzen zu erfassen.
KI und maschinelles Lernen verbessern, wie ein Modell zu Datenvariationen passt oder sie erklärt, wodurch es bei Vorhersagen genauer wird. Es reduziert Underfitting (fehlende Schlüsselbeziehungen) und Overfitting (was bedeutungsloses Rauschen erzeugt). Es hilft, genau die richtigen Variablen auszuwählen und solche zu vermeiden, die Verzerrungen oder verschwenderische Redundanz in ein Modell bringen. Das Ziel ist ein effizientes Modell, das genaue Ergebnisse liefert und bessere Vorhersagen unterstützt.
Erfahren Sie mehr im Bias-Variance Tradeoff im maschinellen Lernen.
Das Betrachten von Beispielen erweckt diese Konzepte zum Leben zum besseren Verständnis. Verwenden wir den Code aus unserem letzten Blogbeitrag und fügen zusätzliche Logik hinzu. Im letzten Blogbeitrag haben wir die unabhängige y und die abhängige Variable x korreliert, um die Grundlagen der linearen Regression mit scikit-learn zu veranschaulichen. Diesmal führen wir etwas Zufälligkeit in die abhängige Variable (y) ein, sodass es einen Fehler in unseren Vorhersagen gibt.
Der Einstieg mit AIOps ist einfach. Erfahren Sie , wie Sie die steigende IT-Komplexität problemlos bewältigen können! ›
Was ist Varianz?
In Bezug auf lineare Regression ist die Varianz ein Maß dafür, wie stark beobachtete Werte vom Durchschnitt der vorhergesagten Werte abweichen (d. h. ihre Differenz vom vorhergesagten Wertmittelwert). Das Ziel ist es, einen niedrigen Wert zu erreichen, wie durch den R2-Wert (unten erklärt) quantifiziert.
Im untenstehenden Code ist dies np.var(err), wobei err ein Array der Unterschiede zwischen beobachteten und vorhergesagten Werten ist und np.var() die numpy-Array-Varianzfunktion.
Wie hoch ist der R2-Wert?
Der R2-Wert ist "... der Anteil der Varianz in der abhängigen Variablen, der aus den unabhängigen Variablen vorhersehbar ist", laut Wikipedia. Eine mathematische Definition lautet "(Gesamtvarianz vom Modell erklärt) / Gesamtvarianz." Wenn sie also 100 % beträgt, sind die beiden Variablen perfekt korreliert (d. h. überhaupt keine Varianz).
Der R2-Wert variiert zwischen 0 % und 100 %. Er ist eng mit dem MSE verwandt (siehe unten), aber nicht dasselbe.
In den meisten Fällen zeigt ein niedriger Wert ein geringes Korrelationsniveau, was bedeutet, dass ein Regressionsmodell nicht gültig ist.
Beim Lesen des folgenden Codes führen wir diese Berechnung in drei Schritten durch, um das Verständnis zu erleichtern. Erstens g ist die Summe der quadratischen Unterschiede zwischen den vorhergesagten und den tatsächlich beobachteten Werten: (ytest[i] – preds[i])². Separat wird die Gesamtsumme der Quadrate anhand der quadratischen Differenz zwischen jedem beobachteten Wert und dem Mittelwert der beobachteten Werte berechnet: (ytest[i] – np.mean(ytest))². Die Ergebnisse werden dann wie folgt gedruckt:
g
ist die Summe der quadratischen Unterschiede zwischen den vorhergesagten und den tatsächlich beobachteten Werten: (ytest[i] – preds[i])². Separat wird die Gesamtsumme der Quadrate unter Verwendung der quadrierten Differenz zwischen jedem beobachteten Wert und dem Mittelwert der beobachteten Werte berechnet: (ytest[i] – np.mean(ytest))². Die Ergebnisse werden dann wie folgt gedruckt:
    print ("total sum of squares", y)
print ("ẗotal sum of residuals ", g)
print ("r2 calculated", 1 - (g / y))
Unser Ziel hier ist es, das zu erklären. Wir können natürlich scikit-lernen lassen, dies mit der r2_score()-Methode zu erreichen:
print("R2 score : %.2f" % r2_score(ytest,preds))
Was ist der mittlere Quadratfehler (MSE)?
Der mittlere Quadratfehler (MSE) ist der Durchschnitt des Quadrats der Fehler. Je größer die Zahl, desto größer der Fehler. Fehler bedeutet in diesem Fall die Differenz zwischen den beobachteten Werten y1, y2, y3, ... und den vorhergesagten pred(y1), pred(y2), pred(y3), ... Wir quadrieren jede Differenz (pred(yn) – yn)) ** 2, sodass negative und positive Werte sich nicht gegenseitig aufheben.
Wie man MSE in Python berechnet
Hier ist also der vollständige Code zur Berechnung des MSE:
Ergebnisse in:
    import matplotlib.pyplot as plt

from sklearn import linear_model

import numpy as np

from sklearn.metrics import mean_squared_error, r2_score

reg = linear_model.LinearRegression()

ar = np.array([[[1],[2],[3]], [[2.01],[4.03],[6.04]]])

y = ar[1,:]

x = ar[0,:]

reg.fit(x,y)

print('Coefficients: n', reg.coef_)

xTest = np.array([[4],[5],[6]])

ytest =  np.array([[9],[8.5],[14]])

preds = reg.predict(xTest)

print("R2 score : %.2f" % r2_score(ytest,preds))

print("Mean squared error: %.2f" % mean_squared_error(ytest,preds))

er = []

g = 0

for i in range(len(ytest)):

print( "actual=", ytest[i], " observed=", preds[i])

x = (ytest[i] - preds[i]) **2

er.append(x)

g = g + x

x = 0

for i in range(len(er)):

x = x + er[i]

print ("MSE", x / len(er))

v = np.var(er)

print ("variance", v)

print ("average of errors ", np.mean(er))

m = np.mean(ytest)

print ("average of observed values", m)

y = 0

for i in range(len(ytest)):

y = y + ((ytest[i] - m) ** 2)

print ("total sum of squares", y)

print ("ẗotal sum of residuals ", g)

print ("r2 calculated", 1 - (g / y))
Ergebnisse in:
    Coefficients:

[[2.015]]

R2 score : 0.62

Mean squared error: 2.34

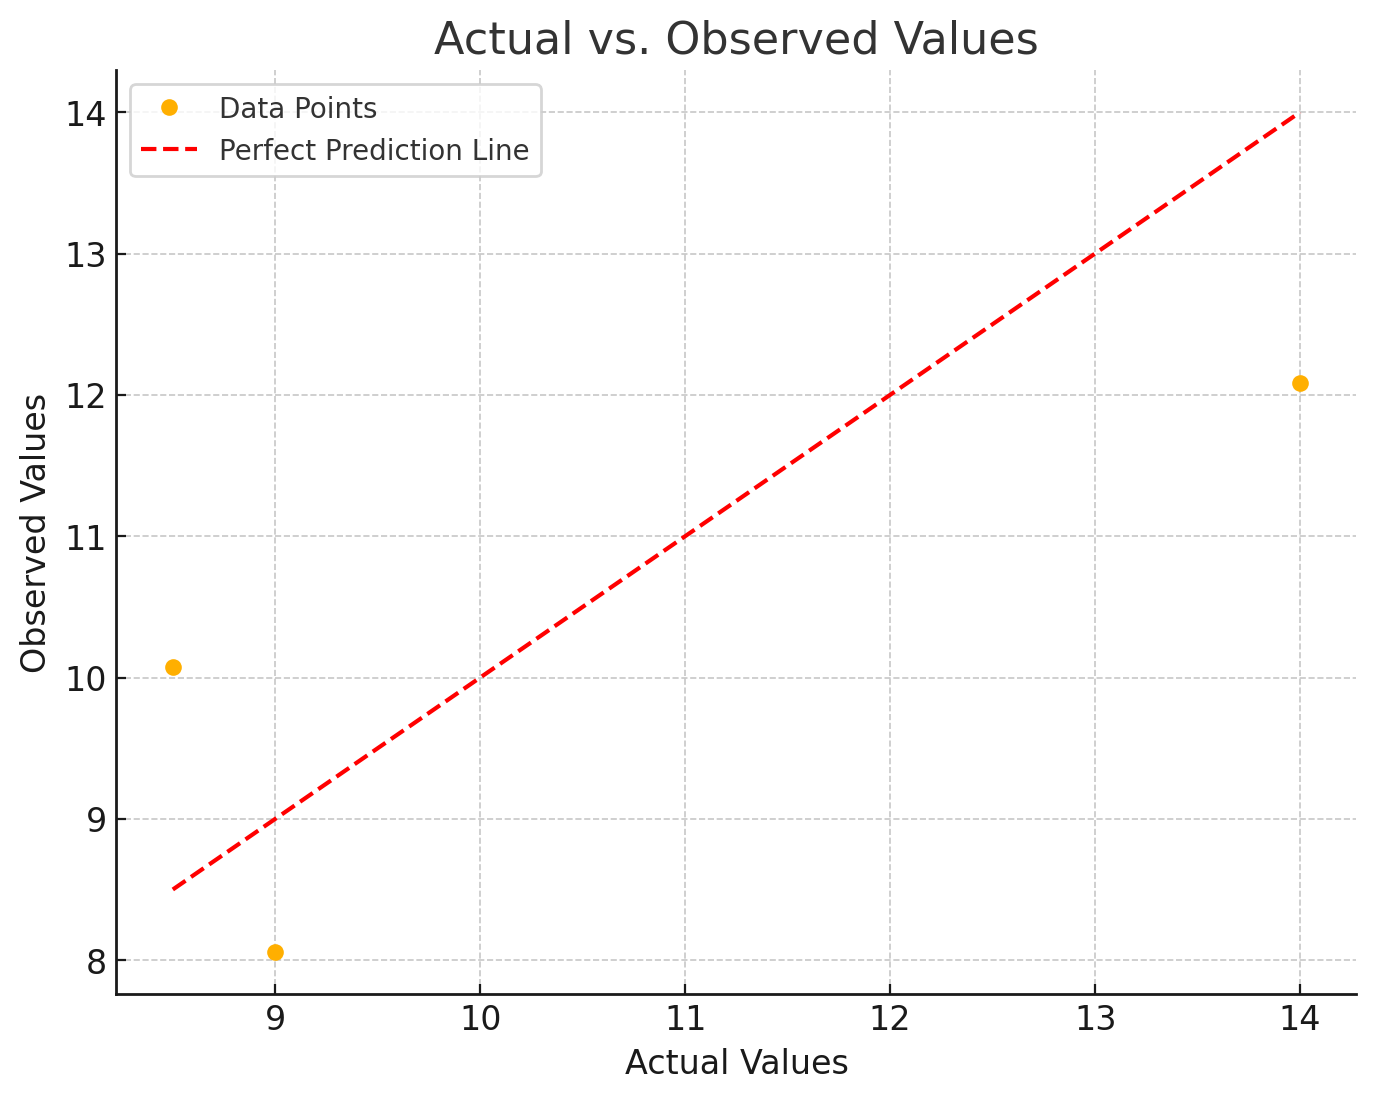
actual= [9.] observed= [8.05666667]

actual= [8.5] observed= [10.07166667]

actual= [14.] observed= [12.08666667]

MSE [2.34028611]

variance 1.2881398892129619

average of errors 2.3402861111111117

average of observed values 10.5

total sum of squares [18.5]

ẗotal sum of residuals [7.02085833]

r2 calculated [0.62049414]
Man sieht anhand der Daten np.array([[[1],[2],[3]], [[2.01],[4.03],[6.04]]]), dass jede abhängige Variable ungefähr doppelt so groß ist wie die unabhängige Variable. Das wird bestätigt, da der berechnete Koeffizient reg.coef_ 2,015 beträgt.
Was ist ein guter Mean Squared Error (MSE)?
Es gibt keinen korrekten Wert für MSE. Einfach gesagt: Je niedriger der Wert, desto besser, und 0 bedeutet, dass das Modell perfekt ist. Da es keine richtige Antwort gibt, liegt der Grundwert des MSE darin, ein Vorhersagemodell gegenüber einem anderen auszuwählen.
Ebenso gibt es auch keine richtige Antwort darauf, was R2 sein sollte. 100 % bedeutet perfekte Korrelation. Dennoch gibt es Modelle mit niedrigem R2, die dennoch gute Modelle sind.
R2 und MSE zusammen interpretieren
Unsere wichtigste Botschaft ist, dass man diese Kennzahlen bei der Modellanalyse nicht isoliert betrachten kann. Man muss sich auch andere Kennzahlen anschauen und die zugrundeliegende Mathematik verstehen. Darauf werden wir in den folgenden Blogbeiträgen eingehen.
Zusätzliche Ressourcen
Erweiterung des R-Quadrats über die lineare Regression der gewöhnlichen kleinsten Quadrate hinaus aus pcdjohnson
scikit Lernleitfaden
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.