




Auf einen Blick: MongoDB-Sharding verteilt große Datensätze auf mehrere Server, um Leistung und Skalierbarkeit zu verbessern. Es besteht aus Shards, Abfrageroutern und Konfigurationsservern, was ein effizientes Datenmanagement in Hochdurchsatzanwendungen ermöglicht.
- Sharding ermöglicht horizontale Skalierung, reduziert die Hardwarebelastung und verbessert die Abfrageleistung.
- Wichtige Komponenten sind Shards, Mongos und Konfigurationsserver, die jeweils eine spezifische Rolle in der Datenverteilung haben.
Dieser umfassende Artikel untersucht Sharding in MongoDB. Wir teilen den Artikel in zwei Abschnitte auf:
- Konzepte, Komponenten, Vor- und Nachteile
- Ein Schritt-für-Schritt-Tutorial zum Einrichten von Sharding
Was ist Sharding?
Sharding ist der Prozess, Daten über mehrere Hosts verteilt zu haben. In MongoDB wird Sharding erreicht, indem große Datensätze in kleine Datensätze über mehrere MongoDB-Instanzen verteilt werden.
Wie Sharding funktioniert
Bei Anwendungen mit hoher Durchsatzrate oder sehr großen Datenbanken wird die zugrunde liegende Hardware zur Hauptbegrenzung. Hohe Abfrageraten können CPU, RAM und I/O-Kapazität von Festplatten belasten, was zu einem schlechten Endnutzererlebnis führt. Um dieses Problem zu mildern, gibt es zwei Arten von Skalierungsmethoden.
Vertikale Skalierung
Vertikale Skalierung ist die traditionelle Methode, um die Hardwarekapazitäten eines einzelnen Servers zu erhöhen. Der Prozess beinhaltet die Aufrüstung von CPU, RAM und Speicherkapazität. Allerdings wird das Aufrüsten eines einzelnen Servers oft durch technologische Einschränkungen und Kostenbeschränkungen herausgefordert.
Horizontale Skalierung
Diese Methode teilt den Datensatz in mehrere Server auf und verteilt die Datenbanklast auf jede Serverinstanz. Die Verteilung der Last verringert die Belastung der benötigten Hardwareressourcen und sorgt für Redundanz im Falle eines Ausfalls. Horizontale Skalierung erhöht jedoch die Komplexität der zugrunde liegenden Architektur. MongoDB unterstützt horizontale Skalierung durch Sharding – einer seiner Hauptvorteile, wie wir unten sehen werden.
Basics des MongoDB-Shardings
MongoDB-Sharding funktioniert, indem ein Cluster von MongoDB-Instanzen mit mindestens drei Servern erstellt wird. Das bedeutet, dass Sharded-Cluster aus drei Hauptkomponenten bestehen:
- Der Splitter
- Mongos
- Konfigurationsserver
Splitter
Ein Shard ist eine einzelne MongoDB-Instanz, die eine Teilmenge der Sharded-Daten enthält. Shards können als Replikasets bereitgestellt werden, um die Verfügbarkeit zu erhöhen und Redundanz zu gewährleisten. Die Kombination mehrerer Shards erzeugt einen vollständigen Datensatz. Zum Beispiel kann ein 2-TB-Datensatz in vier Shards unterteilt werden, die jeweils 500 GB Daten aus dem ursprünglichen Datensatz enthalten.
Mongos
Mongos fungieren als Abfragerouter und bieten eine stabile Schnittstelle zwischen der Anwendung und dem Sharded-Cluster. Diese MongoDB-Instanz ist dafür verantwortlich, die Client-Anfragen an den richtigen Shard zu leiten.
Konfigurationsserver
Konfigurationsserver speichern die Metadaten und die Konfigurationseinstellungen für den gesamten Cluster.
Abgebildete Komponenten
Das folgende Diagramm aus den offiziellen MongoDB-Dokumenten erklärt die Beziehung zwischen den einzelnen Komponenten:
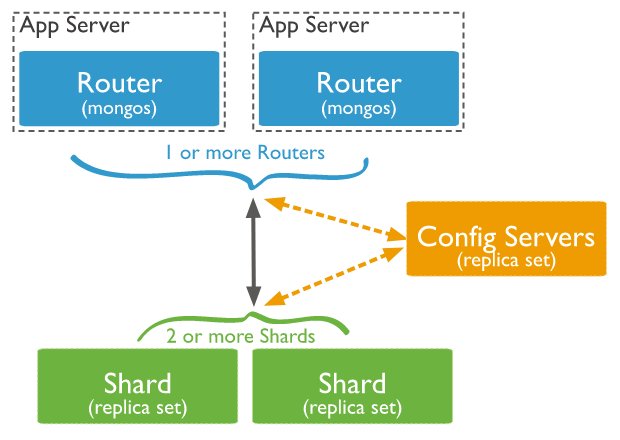
- Die Anwendung kommuniziert mit den Routern (Mongos) über die auszuführende Abfrage.
- Die Mongos-Instanz konsultiert die Konfigurationsserver, um zu überprüfen, welcher Shard den erforderlichen Datensatz enthält, um die Abfrage an diesen Shard zu senden.
- Schließlich wird das Ergebnis der Abfrage an die Anwendung zurückgegeben.
Es ist wichtig zu bedenken, dass die Konfigurationsserver auch als Replica-Sets funktionieren.
Shard-Schlüssel
Beim Sharden einer MongoDB-Sammlung wird als einer der ersten Schritte ein Shard-Schlüssel erstellt. Der "Shard-Schlüssel" wird verwendet, um die Dokumente der MongoDB-Sammlung über alle Shards zu verteilen. Der Schlüssel besteht aus einem einzelnen Feld oder mehreren Feldern in jedem Dokument. Der Sharded-Schlüssel ist unveränderlich und kann nach dem Sharding nicht mehr geändert werden. Eine Sharded-Sammlung enthält nur einen einzelnen Shard-Schlüssel. Beim Sharden einer befüllten Sammlung muss die Sammlung einen Index haben, der mit dem Shard-Schlüssel beginnt. Für leere Sammlungen, die keinen passenden Index besitzen, erstellt MongoDB einen Index für den angegebenen Shard-Schlüssel. Der Shard-Schlüssel kann direkt die Leistung des Clusters beeinflussen. Daher kann es zu Engpässen in Anwendungen führen, die mit dem Cluster verbunden sind. Um dies zu verhindern, muss der Shard-Schlüssel vor dem Sharding der Sammlung basierend auf:
- Das Schema des Datensatzes
- Wie der Datensatz abgefragt wird
Chunks
Chunks sind Teilmengen der geteilten Daten. MongoDB trennt die Sharded-Daten in Chunks, die über die Shards im gemeinsamen Cluster verteilt sind. Jeder Chunk hat einen inklusiven unteren und einen exklusiven oberen Bereich basierend auf dem Shard-Schlüssel. Ein für jeden Cluster spezifischer Balancer verwaltet die Chunk-Verteilung. Der Balancer läuft als Hintergrundjob und verteilt die Chunks nach Bedarf, um ein gleichmäßiges Gleichgewicht der Chunks über alle Shards zu erreichen. Dieser Prozess wird als Even Chuck-Verteilung bezeichnet.
Vorteile und Einschränkungen des Shardings
Jetzt, wo wir das Konzept verstanden haben, schauen wir uns die Vorteile und Grenzen des Shardings in MongoDB an:
Vorteile
- In traditionellen Replikationsszenarien übernimmt der primäre Knoten den Großteil der Schreiboperationen, während die sekundären Server auf Schreib-nur-Operationen oder die Pflege des Backups des Datensatzes beschränkt sind. Da Sharding jedoch Shards mit Replica-Sets verwendet, werden alle Abfragen auf alle Knoten im Cluster verteilt.
- Da jeder Shard aus einer Teilmenge des vollständigen Datensatzes besteht, erhöht das einfache Hinzufügen zusätzlicher Shards die Speicherkapazität des Clusters, ohne dass komplexe Hardware-Umstrukturierungen erforderlich sind.
- Replikation erfordert vertikale Skalierung bei der Verarbeitung großer Datensätze. Diese Anforderung kann zu Hardwarebeschränkungen und unerschwinglichen Kosten im Vergleich zum horizontalen Skalierungsansatz führen. Da MongoDB jedoch horizontale Skalierung nutzt, ist die Arbeitslast verteilt. Wenn der Bedarf entsteht, können zusätzliche Server zu einem Cluster hinzugefügt werden.
- Beim Sharding korrelieren sowohl die Lese- als auch die Schreibleistung direkt mit der Anzahl der Serverknoten im Cluster. Dieser Prozess bietet eine schnelle Methode, um die Leistung des Clusters zu steigern, indem einfach zusätzliche Knoten hinzugefügt werden.
- Ein Sharded-Cluster kann auch dann weiterfunktionieren, wenn ein einzelner oder mehrere Shards nicht verfügbar sind. Auch wenn die Daten auf diesen Shards nicht verfügbar sind, kann die Client-Anwendung dennoch auf alle anderen verfügbaren Shards im Cluster zugreifen, ohne dass es zu Ausfallzeiten kommt. In Produktionsumgebungen werden alle einzelnen Shards als Replik-Sets bereitgestellt, was die Verfügbarkeit des Clusters weiter erhöht.
Einschränkungen
- Sharding erfordert sorgfältige Planung und Wartung, um einen Sharded-Cluster aufrechtzuerhalten – wegen der damit verbundenen Komplexität.
- Wenn du eine MongoDB-Sammlung shardst, gibt es keine Möglichkeit, die Sharded-Sammlung zu entsplittern.
- Der Shard-Schlüssel wirkt sich direkt auf die Gesamtleistung des zugrunde liegenden Clusters aus, da er zur Identifikation aller Dokumente innerhalb der Sammlungen verwendet wird.
- Es gibt einige betriebliche Einschränkungen innerhalb einer MongoDB-Sharded-Umgebung. Zum Beispiel wird der geoSearch-Befehl in einer Sharded-Umgebung nicht unterstützt.
- In einem Fall, in dem kein Shard-Schlüssel oder ein Präfix des zusammengesetzten Shard-Schlüssels vorhanden ist, führt Mongo eine Broadcast-Operation durch, die alle Shards im Cluster abfragt, was zu langlaufenden Abfrageaufgaben führen kann.
Wie man ein MongoDB-Sharding einrichtet
Jetzt, da wir die Konzepte des Shardings verstanden haben, beginnen wir mit einigen Tutorials. Die folgenden Schritte zeigen, wie man einen Sharded-Cluster auf drei Servern einrichtet. Ubuntu 20.04 LTS und MongoDB 4.4.1 sind auf allen drei Servern installiert. Wir können Server wie folgt definieren:
- mongodb01 - 10.10.10.56 - Konfigurationsserver
- mongodb02 - 10.10.10.57 - Abfragerouter (mongos)
- mongodb03 - 10.10.10.58 – Shard
Jetzt führen wir Sie durch mehrere Schritte, unter anderem, wie Sie:
- Konfiguration des Konfigurationsservers
- Konfigurieren Sie den Abfragerouter
- Konfigurieren Sie einen Shard
- Shard zum Cluster hinzufügen
- Sharding aktivieren
- Erstellen Sie den Sharding-Datensatz
- Sharding in einer Sammlung aktivieren
Konfiguration des Konfigurationsservers
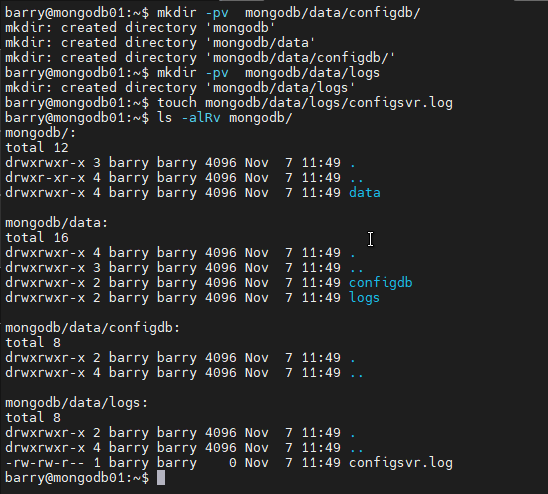
Erstelle die Verzeichnisstruktur für die Datenbank und die Logdatei.
    mkdir -pv  mongodb/data/configdb/
mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/configsvr.log
ls -alRv mongodb/
Erstelle die Konfigurationsdatei. Wenn du die obigen Befehle ausführst, wird zusammen mit diesen Verzeichnissen eine Konfigurationsdatei erstellt. Öffne als Nächstes die Konfigurationsdatei und weise den Port sowie die IP-Adresse des Servers zu. Vergiss außerdem nicht, die Cluster-Rolle als configsvr zu setzen.
sudo nano /etc/mongodConfig.conf
Datei - mongodConfig.conf
    storage:
  dbPath: /home/barry/mongodb/data/configdb
  journal:
  enabled: true

systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/configsvr.log

net:
  port: 27019
  bindIp: 10.10.10.56

sharding:
  clusterRole: configsvr

replication:
  replSetName: ConfigReplSet
Starte den Konfigurationsserver. Jetzt kannst du den Konfigurationsserver mit folgendem Befehl starten.
mongod --config /etc/mongodConfig.conf&
Überprüfen Sie die Protokolle, um zu überprüfen, ob der Server läuft.
tail -100 mongodb/data/logs/configsvr.log

Verbinde dich mit dem Konfigurationsserver.
mongo 10.10.10.56:27019
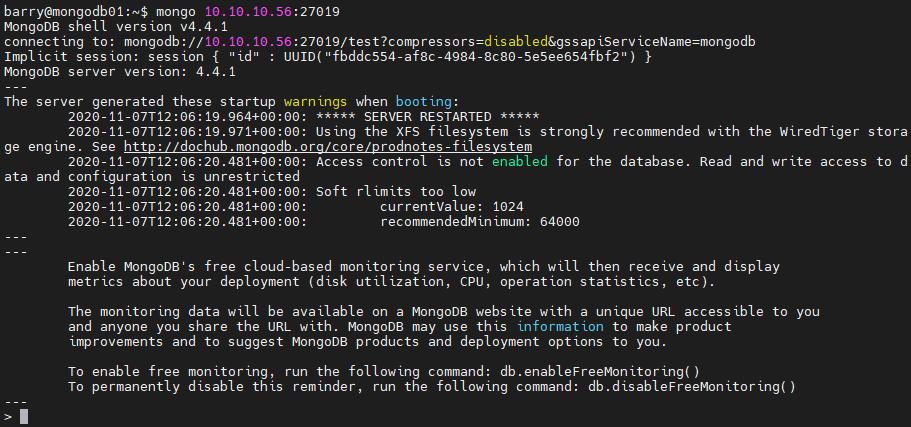
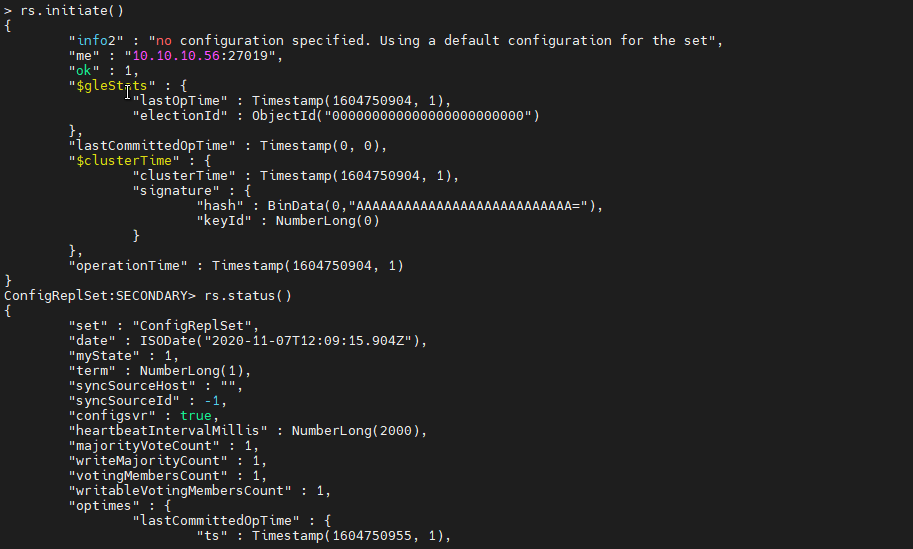
Initiiere den Konfigurationsserver. Du kannst die Initiate()- Funktion verwenden, um den Konfigurationsserver mit der Standardkonfiguration zu starten. Dann überprüfst du den Status des Servers mit der Status() -Funktion.
    rs.initiate()
rs.status()
Konfiguration des Abfragerouters
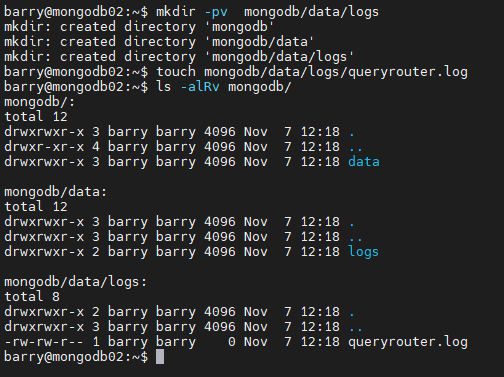
Erstelle die Verzeichnisstruktur und eine leere Logdatei.
    mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/mongorouter.log
ls -alRv mongodb/
Erstellen Sie die Konfigurationsdatei. Um den Abfragerouter zu erstellen, geben wir den Logstandort, die IP und den Port der Serverinstanz an. Außerdem müssen wir den Konfigurationsserver definieren, zu dem dieser Abfragerouter gehört.
sudo nano /etc/mongoRouter.conf
Datei - mongoRouter.conf
    systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/queryrouter.log

net:
  port: 27017
  bindIp: 10.10.10.57

sharding:
  configDB: ConfigReplSet/10.10.10.56:27019
Starte den Abfragerouter mit dem Mongos-Befehl.
mongos --config /etc/mongoRouter.conf&
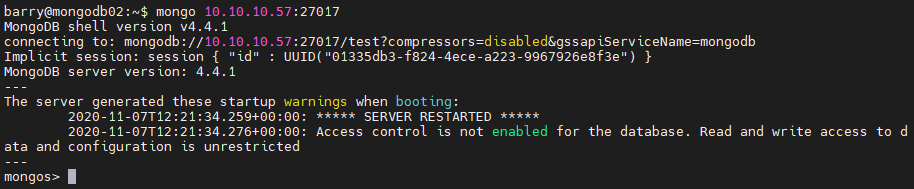
Überprüfen Sie, ob die Abfragerouter-Instanz erreichbar ist.
mongo 10.10.10.57:27017
Konfiguration eines Shards
Erstelle die Verzeichnisstruktur und die Logdatei.
    mkdir -pv  mongodb/data/sharddb/
mkdir -pv  mongodb/data/logs
touch mongodb/data/logs/shard.log
ls -alRv mongodb/

Erstellen Sie die Konfigurationsdatei. Die Konfigurationsdatei des Shards enthält die Pfade für den Datenbankspeicher, Logs und die Sharding-Cluster-Rolle, die auf shardsvr gesetzt ist. Sie enthält auch die Netzwerkeinstellungen zur Serverinstanz. Schließlich haben wir replSetName gesetzt, sodass die Daten repliziert werden können.
sudo nano /etc/mongodShard.conf
Datei - mongoShard.conf
    storage:
  dbPath: /home/barry/mongodb/data/sharddb
  journal:
    enabled: true

systemLog:
  destination: file
  logAppend: true
  path: /home/barry/mongodb/data/logs/shard.log

net:
  port: 27018
  bindIp: 10.10.10.58

sharding:
  clusterRole: shardsvr

replication:
  replSetName: ShardReplSet
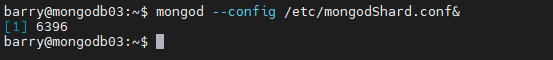
Starte den Shard-Server.
mongod --config /etc/mongodShard.conf&
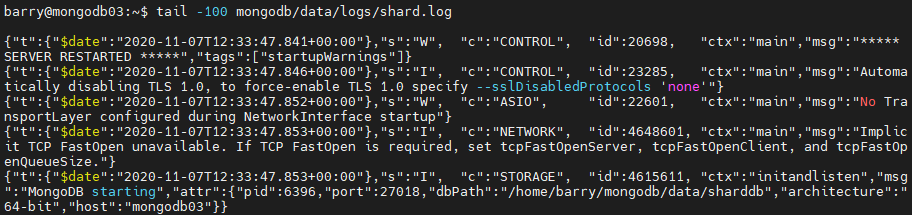
Überprüfen Sie die Protokolle, um zu überprüfen, ob der Server läuft.
tail -100 mongodb/data/logs/shard.log
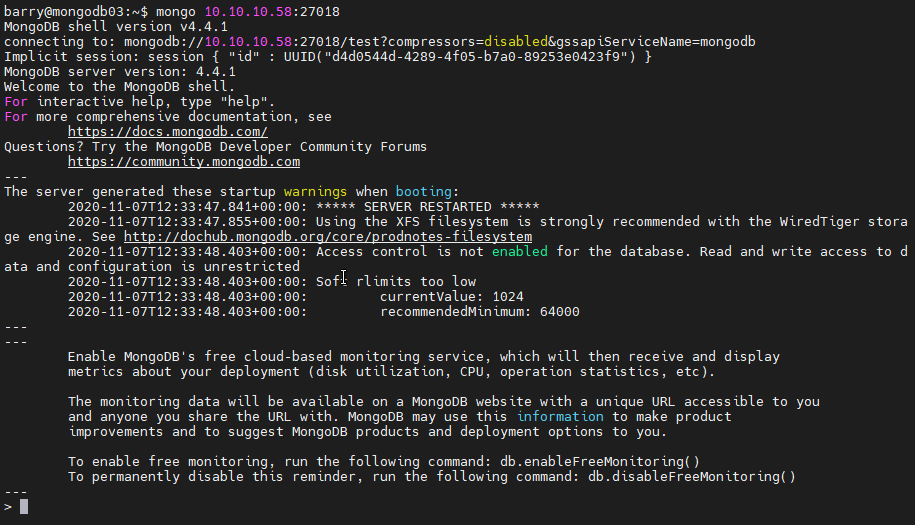
Melde dich beim Shard-Server an.
mongo 10.10.10.58:27018
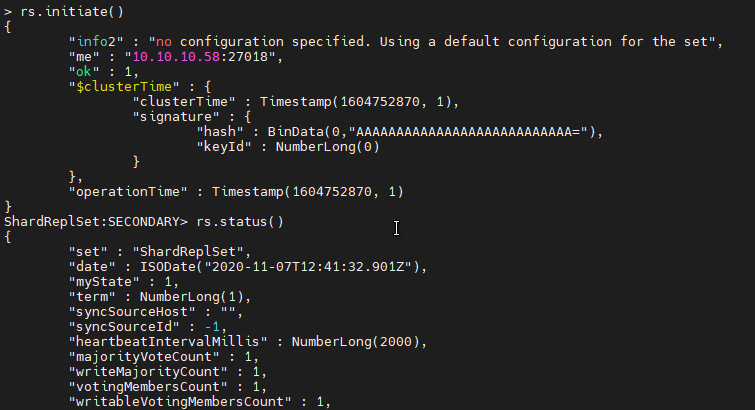
Initiiere den Shard-Server. Die Replikation mit der Standardkonfiguration wird mit der Funktion initiate() aktiviert. Dann überprüfe den Status der Initialisierung mit der Status() -Funktion.
    rs.initiate()
rs.status()
Hinzufügen des Splitters zum Cluster
Verbinden Sie sich mit dem Abfragerouter.
mongo 10.10.10.57:27017
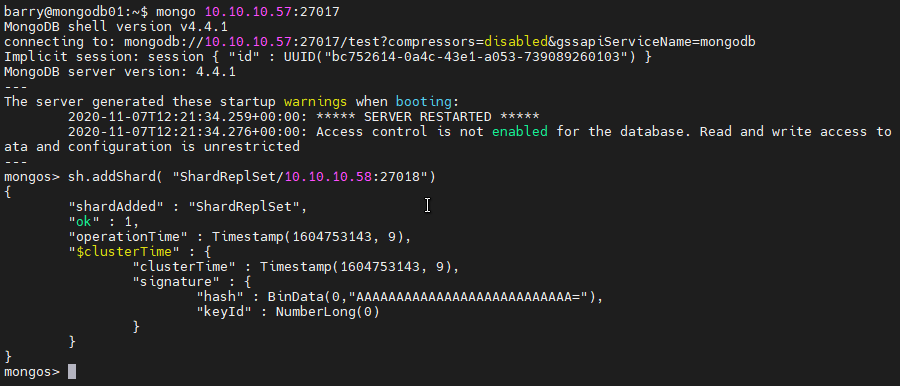
Füge den Shard zum Clustet hinzu. Mit dem Befehl addShard() stellen wir replSetName die IP-Adresse und den Port der Shard-Instanz zur Verfügung.
sh.addShard( "ShardReplSet/10.10.10.58:27018")
Ermöglichung des Shardings
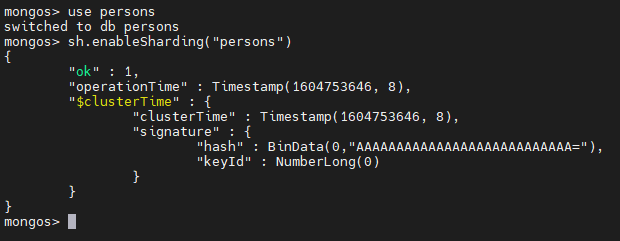
Erstellen Sie die Datenbank. Eine Datenbank mit dem Namen "Personen" wird mit dem Abfragerouter erstellt. Diese Datenbank wird für die Sharding-Operation verwendet. Hier die notwendigen Schritte zur Aktivierung des Shardings:
    use persons
sh.enableSharding("persons")
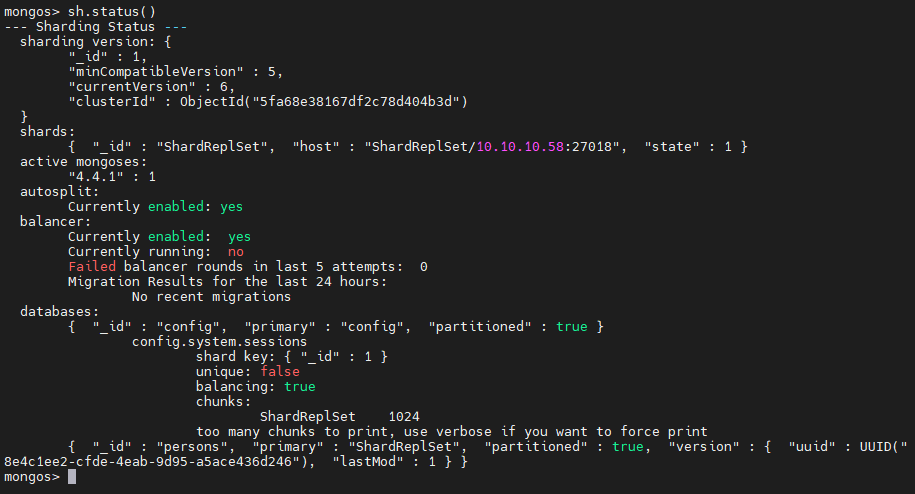
Überprüfen Sie den Sharding-Status. Mit dem Befehl status() prüfen wir, ob das Sharding in der Datenbank aktiviert ist. Wie unten gezeigt, ist das Sharding in der "Personen"-Datenbank aktiviert.
sh.status()
Erstellung des Sharding-Datensatzes
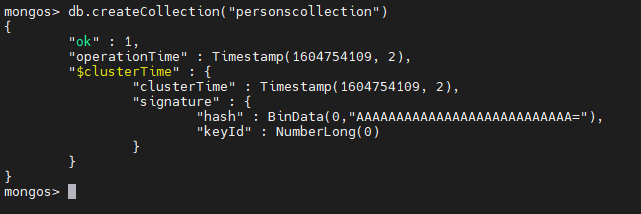
In diesem Abschnitt erstellen wir eine MongoDB-Sammlung und einen Index namens person_id , der als Shard-Schlüssel verwendet wird. Die Daten in der Sammlung werden mit der Sammlung und dem Shard-Schlüssel gesplittet. Erstellen Sie die Sammlung.
db.createCollection("personscollection")
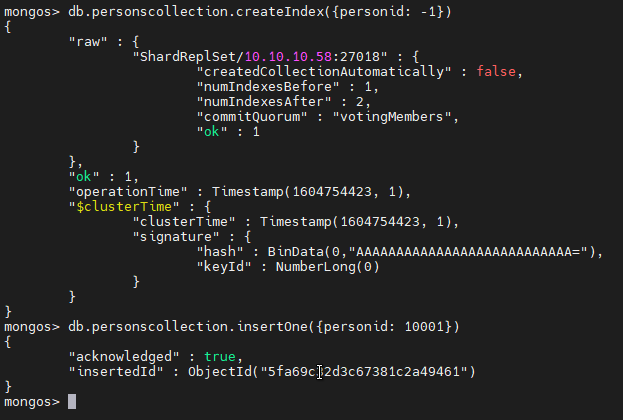
Erstellen Sie den Index und fügen Sie einen Datensatz hinzu. Erstellen Sie den Index mit personid als Feld in absteigender Reihenfolge.
db.personscollection.createIndex({personid: -1})
Füge eine Personid mit dem Wert 10001 hinzu.
db.personscollection.insertOne({personid: 10001})
Sharding für die "personscollection" aktivieren
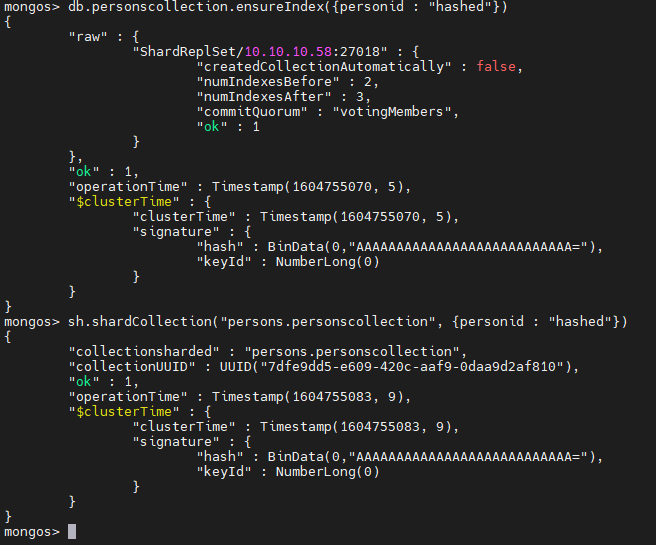
Der erste Schritt besteht darin, sicherzustellen, dass die Index-Personid gehasht wird. Wenn nicht, führt dies zu einem Fehler und das Sharding scheitert. Um dies zu erreichen, verwenden wir die Funktion ensureIndex() innerhalb von MongoDB.
db.personscollection.ensureIndex({personid : "hashed"})
Wenn der Index korrekt verwendet wird, können wir Sharding mit "personid" als Shard-Schlüssel aktivieren.
sh.shardCollection("persons.personscollection", {personid : "hashed"})
Ist die Operation erfolgreich, wird folgende Ausgabe angezeigt.
Überprüfen Sie, ob das Sharding wie vorgesehen funktioniert. Verwenden Sie den Befehl getShardDistribution(), um den Status der Sharding-Operation zu überprüfen.
db.personscollection.getShardDistribution()

Die obige Ausgabe beschreibt, dass die Personcollection im ShardRepSet auf dem Shard-Server (10.10.10.58) gesplittert ist. Sie besteht aus einem einzelnen Dokument in einem einzigen Chunk. Das verfügbare Dokument ist der einzelne Datensatz, den wir in die Sammlung eingegeben haben.
Zusammenfassung des MongoDB-Shardings
MongoDB-Sharding ist eine Methode, große Datensätze effizient zu verwalten, indem die Arbeitslast auf viele Server verteilt wird, ohne die Gesamtleistung der Datenbank zu beeinträchtigen. Außerdem ermöglicht Sharding die Möglichkeit, den Cluster effizient für zukünftige Anforderungen zu skalieren, ohne die zugrunde liegende Hardware-Infrastruktur komplex umzustrukturieren.
Verwandte Literatur
- BMC Machine Learning & Big Data Blog
- MongoDB Guide, eine Reihe von Artikeln und Tutorials
- MongoDB: Die Mongo-Shell & Grundbefehle
- Datenspeicher erklärt: Data Lake vs. Warehouse vs. Datenbank
MongoDB-Leitfaden
- MongoDB-Überblick: Einstieg mit MongoDB
- Wie man MongoDB auf Ubuntu und Mac installiert
- Erstellung einer Datenbank in MongoDB
- MongoDB Shell Grundbefehle
- MongoDB Compass: Nutzung der Mongo GUI
- MongoDB rollenbasierte Zugriffskontrolle (RBAC) erklärt
- MongoDB-Projektion und Projektionsoperatoren erklärt
- MongoDB-Aggregatfunktionen erklärt
- MongoDB-Sortierung: sort()-Methode & Beispiele
- Verwendung von Push-and-Pull-Operatoren in MongoDB
- Wie man MongoDB $unwind
- 23 Gängige MongoDB-Abfrageoperatoren und deren Verwendung
- MongoDB GeoLocation-Abfragebeispiele
- Einführung in MongoDB-Transaktionen
- MongoDB-Indizes: Top-Indextypen und deren Verwaltung
- Die wichtigsten MongoDB-Befehle, die du kennen solltest
- MongoDB-Replikation: Eine vollständige Einführung
- Wie man einen MongoDB-Cluster einrichtet
- MongoDB Sharding: Konzepte, Beispiele & Tutorials
- MongoDB Atlas: Einrichtung und Nutzung von verwaltetem MongoDB
- Wie man MongoDB als Docker-Container ausführt
- MongoDB-Speichernutzung, Verwaltung und Anforderungen
- Wie man Mongodump für MongoDB-Backups verwendet
- Mongorestore-Beispiele zur Wiederherstellung von MongoDB-Backups
- Wie man PyMongo benutzt
- Wie man Mongoose für MongoDB und NodeJS verwendet
- MongoDB Spickzettel
- MongoDB vs Cassandra: NoSQL-Datenbanken im Vergleich
- PostgreSQL vs MongoDB: Vergleich von Datenbanken
- MySQL vs. MongoDB: Vergleich von Datenbanken
- MongoDB-Zertifizierungen: Eine Einführung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.