




Auf einen Blick: Die MongoDB-Replikation erhöht die Datenresilienz, indem sie Replica-Sets nutzt, um mehrere Kopien über Server hinweg zu erstellen und so Verfügbarkeit und automatisches Failover sicherzustellen. Sie umfasst einen primären Knoten für Schreiboperationen und sekundäre Knoten für die Datenreplikation.
- Für eine effektive Konfiguration benötigt die Replikation mindestens drei Knoten.
- Heartbeat-Prozesse überwachen den Knotenstatus und ermöglichen ein automatisches Failover.
Die Replikation mit Replica-Sets ist eine robuste Methode, um die Datenelastizität Ihrer gesamten MongoDB-Datenbank zu erhöhen.
In diesem Artikel führe ich Sie durch:
- Das Replikationskonzept
- Hauptkomponenten der Replikation
- Konfigurationsanforderungen (vs. Cluster)
- Möglichkeiten, ein Replica-Set in einer MongoDB-Umgebung zu konfigurieren und zu verwalten
Fangen wir an.
Was ist MongoDB-Replikation?
Einfach ausgedrückt ist MongoDB-Replikation der Prozess, bei dem eine Kopie desselben Datensatzes auf mehr als einem MongoDB-Server erstellt wird. Dies kann durch die Verwendung eines Replica-Sets erreicht werden. Ein Replica-Set ist eine Gruppe von MongoDB-Instanzen, die denselben Datensatz pflegen und sich auf jeden Mongod-Prozess beziehen.
Replikation ermöglicht es Datenbankadministratoren, Folgendes bereitzustellen:
- Datenredundanz
- Hohe Datenverfügbarkeit
Die Pflege mehrerer MongoDB-Server mit denselben Daten ermöglicht einen verteilten Zugriff auf die Daten und erhöht die Fehlertoleranz der Datenbank durch Backups.
Zusätzlich kann Replikation auch als Teil der Lastverteilung verwendet werden, bei der Lese- und Schreiboperationen je nach Anwendungsfall auf alle Instanzen verteilt werden können.
Wie MongoDB-Replikation funktioniert
MongoDB übernimmt die Replikation über ein Replica Set, das aus mehreren MongoDB-Knoten besteht, die als Einheit gruppiert sind.
Ein Replica Set benötigt mindestens drei MongoDB-Knoten:
- Einer der Knoten gilt als der primäre Knoten, der alle Schreiboperationen empfängt.
- Die anderen gelten als sekundäre Knoten. Diese sekundären Knoten replizieren die Daten vom primären Knoten.
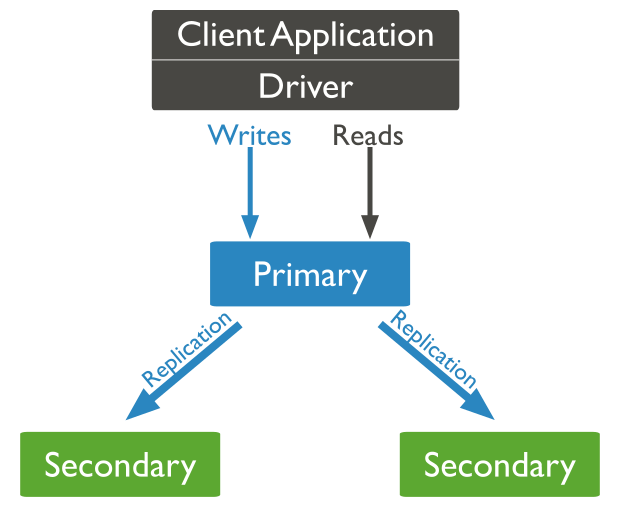
Während der primäre Knoten die einzige Instanz ist, die Schreiboperationen akzeptiert, kann jeder andere Knoten innerhalb eines Replica-Sets Leseoperationen akzeptieren. Diese können über einen unterstützten MongoDB-Client konfiguriert werden.
Wenn der primäre Knoten nicht verfügbar oder nicht funktionsfähig ist, übernimmt ein sekundärer Knoten die Rolle des primären Knotens, um eine kontinuierliche Datenverfügbarkeit zu gewährleisten. In einem solchen Fall erfolgt die Auswahl des primären Knotens durch einen Prozess namens Replica Set Elections, bei dem der geeignetste sekundäre Knoten als neuer primärer Knoten ausgewählt wird.
Der Heartbeat-Prozess
Heartbeat ist der Prozess, der den aktuellen Status eines MongoDB-Knotens in einem Replica-Set identifiziert. Dort senden die Replik-Set-Knoten alle zwei Sekunden Pings miteinander (daher der Name). Wenn ein Knoten nicht innerhalb von 10 Sekunden zurückpingt, markieren die anderen Knoten im Replica-Set ihn als unzugänglich.
Diese Funktionalität ist entscheidend für den automatischen Failover-Prozess, bei dem der primäre Knoten nicht erreichbar ist und die sekundären Knoten innerhalb des zugewiesenen Zeitrahmens keinen Herzschlag erhalten. Anschließend weist MongoDB automatisch einen sekundären Server als primären Server zu.
Repliken-Set-Wahlen
Die Wahlen in Replikationssätzen werden verwendet , um zu bestimmen , welcher MongoDB-Knoten der primäre Knoten werden soll. Diese Wahlen können in folgenden Fällen stattfinden:
- Verlust der Verbindung zum primären Knoten (durch Herzschläge erkannt)
- Initialisierung einer Replikenmenge
- Hinzufügen eines neuen Knotens zu einem bestehenden Replikensatz
- Wartung eines Replica-Sets mittels stepDown- oder rs.reconfig-Methoden
Im Prozess einer Wahl hisst zunächst einer der Knoten eine Flagge, die eine Wahl anfordert, und alle anderen Knoten stimmen ab, diesen Knoten als primären Knoten zu wählen. Die durchschnittliche Zeit für den Abschluss eines Wahlprozesses beträgt 12 Sekunden, vorausgesetzt, die Replik-Konfigurationseinstellungen sind in ihren Standardwerten angegeben. Ein wesentlicher Faktor, der die Zeit bis zum Abschluss einer Wahl beeinflussen kann, ist die Netzwerklatenz, und sie kann Verzögerungen verursachen, wenn die Replik mit dem neuen primären Knoten wieder in Betrieb genommen wird.
Das Replikatset kann keine Schreiboperationen verarbeiten, bis die Wahl abgeschlossen ist. Leseoperationen können jedoch ausgeführt werden, wenn Leseabfragen so konfiguriert sind, dass sie auf sekundären Knoten verarbeitet werden. MongoDB 3.6 unterstützt kompatible Konnektivitätstreiber, die so konfiguriert werden, dass sie kompatible Schreiboperationen erneut versuchen.
MongoDB Replica Set vs MongoDB Cluster
Ein Replikatset erstellt mehrere Kopien desselben Datensatzes über die Replikationsset-Knoten. Das grundlegende Ziel eines Replikatsets ist es:
- Erhöhung der Datenverfügbarkeit
- Bereitstellung einer integrierten Backup-Lösung
Cluster funktionieren unterschiedlich. Der MongoDB-Cluster verteilt die Daten über mehrere Knoten mit einem Shard-Key. Dieser Prozess zerlegt die Daten in mehrere Teile, sogenannte Shards , und kopiert dann jeden Shard auf einen separaten Knoten.
Der Hauptzweck eines Clusters ist es, extrem große Datensätze und hohe Durchsatzoperationen zu unterstützen, indem die Arbeitslast horizontal skaliert wird.
Der Hauptunterschied zwischen einem Replikatset und einem Cluster ist:
- Eine Replikationsmenge kopiert den Datensatz als Ganzes.
- Ein Cluster verteilt die Arbeitslast und speichert Datenstücke (Shards) über mehrere Server hinweg.
MongoDB ermöglicht es Nutzern, diese beiden Funktionen zu kombinieren, indem ein Sharded Cluster erstellt wird, bei dem jeder Shard auf einen sekundären Server repliziert wird, um eine hohe Datenverfügbarkeit und Redundanz zu gewährleisten.
Umgang mit der Replikationsverzögerung
Ein großes Problem bei der Konfiguration der Replikation ist die Replikationsverzögerung (Lag). Dies bezieht sich auf die Verzögerung im Replikationsprozess zu einem sekundären Knoten nach einem Update des primären Knotens im Replikationsset.
Eine gewisse Replikationsverzögerung beim Replizieren großer Datensätze ist normal. Dennoch können folgende Faktoren die Replikationsverzögerung erhöhen und die Vorteile einer aktuellen Replikation aufheben:
- Netzwerklatenz. Da Sie es mit mehreren MongoDB-Instanzen zu tun haben, die sich während der Replikation auf verschiedenen Servern befinden, ist die primäre Kommunikationsmethode das Netzwerk. Wenn das Netzwerk nicht ausreicht, um den Anforderungen des Replikationsprozesses gerecht zu werden, kommt es zu Verzögerungen bei der Datenreplizierung im gesamten Replica-Satz. Daher ist es besser, Ihren Datenverkehr immer in einem stabilen Netzwerk mit ausreichender Bandbreite zu routen.
- Festplattendurchsatz. Wenn die Replikationsknoten unterschiedliche Festplattentypen verwenden (z. B. verwendet der primäre Knoten SSD, während sekundäre Knoten HDD als Festplatten verwenden), gibt es eine Verzögerung bei der Replikation, da die sekundären Knoten die Schreibanfragen im Vergleich zum primären Knoten langsamer bearbeiten. Dies ist ein häufiges Problem bei Mehrbenutzer- und groß angelegten Deployments.
- Schwere Arbeitslasten. Das ausführen schwerer und langlaufender Schreiboperationen am primären Knoten führt ebenfalls zu Verzögerungen im Replikationsprozess. Daher ist es am besten, die MongoDB Write Concern korrekt zu konfigurieren, damit der Replikationsprozess mit der Arbeitslast Schritt halten kann, ohne die Gesamtleistung des Replikierungssets zu beeinträchtigen.
- Hintergrund-Aufgaben. Ein weiterer wichtiger Schritt ist es, die Hintergrundaufgaben wie Server-Updates, Cron-Jobs und Sicherheitschecks zu identifizieren, die unerwartete Auswirkungen auf die Netzwerk- oder Festplattennutzung haben und Verzögerungen im Replikationsprozess verursachen können.
- Datenbankoperationen. - Einige Datenbankabfragen können langsam ausgeführt werden, während andere eine beträchtliche Zeit benötigen. Mit einem Datenbankprofiler können Sie solche Abfragen identifizieren und versuchen, sie entsprechend zu optimieren.
Konfiguration des Replica-Satzes
Die obigen Abschnitte behandeln alle wichtigen Theorien zur Replikation. Als Nächstes konfigurieren wir ein Replica-Set mit MongoDB-Instanzen, die auf drei Ubuntu-Servern installiert sind.
Einrichtung der Umgebung
Jeder Ubuntu-Server verfügt über eine eigene MongoDB-Instanz mit dem Standard-MongoDB-Port 27017, der über die Firewall zugänglich ist. MongoDB empfiehlt, bei der Konfiguration von Replica-Sets in Produktionsumgebungen logische DNS-Hostnamen anstelle von IP-Adressen zu verwenden. Dies dient dazu, Kommunikationsstörungen innerhalb des Replica-Sets durch Änderungen der IP-Adresse zu vermeiden.
Man kann die /etc/hosts-Datei aktualisieren, um jedem Server in einer Testumgebung Hostnamen zuzuweisen. Dort muss man die unten genannten Hostnamen als Hosts hinzufügen, die jeden Knoten anzeigen, und jeden Server neu starten, um die neue Konfiguration zu laden.
/etc/hosts
    10.10.10.56 mongodb-node-01
10.10.10.57 mongodb-node-02
10.10.10.58 mongodb-node-03
Start der MongoDB-Instanz
Bevor Sie die MongoDB-Instanz starten, müssen Sie die Konfigurationsdatei in jedem Server so anpassen, dass sie die IP-Adresse widerspiegelt und das Replica-Set angibt. Lassen Sie uns die folgenden Änderungen in jeder mongod.conf-Datei vornehmen.
Mongodb-Node-01
Mongodb-Node-02
mongodb-node-03
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1,mongodb-node-01# replica set
replication:
replSetName: replicasetMain
Mongodb-Node-02
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1,mongodb-node-02# replica set
replication:
replSetName: replicasetMain
mongodb-node-03
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1,mongodb-node-03# replica set
replication:
replSetName: replicasetMain
Nach Abschluss der Updates wird der Mongod-Dienst in jeder Instanz neu gestartet, um die Konfigurationen neu zu laden.
sudo systemctl restart mongod
Initialisierung des Replica-Sets
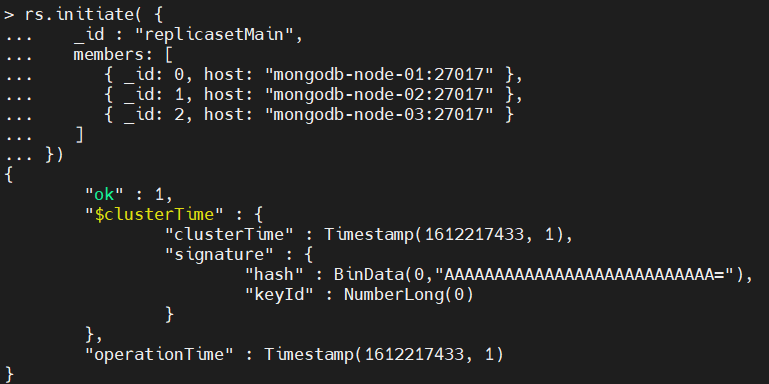
Sie können ein Replica-Set mit der rs.initiate() -Methode initialisieren. Diese Methode muss nur auf einer einzigen MongoDB-Instanz im Replica-Set ausgeführt werden. Innerhalb der Initiate-Methode können Sie den Namen und das Mitglied des Replica-Sets angeben. Diese Details müssen mit den Konfigurationen übereinstimmen, die Sie in jeder Konfigurationsdatei im vorherigen Schritt erstellt haben.
Ergebnis:
    rs.initiate( {
_id : "replicasetMain",
members: [
{ _id: 0, host: "mongodb-node-01:27017" },
{ _id: 1, host: "mongodb-node-02:27017" },
{ _id: 2, host: "mongodb-node-03:27017" }
]
})
Ergebnis:
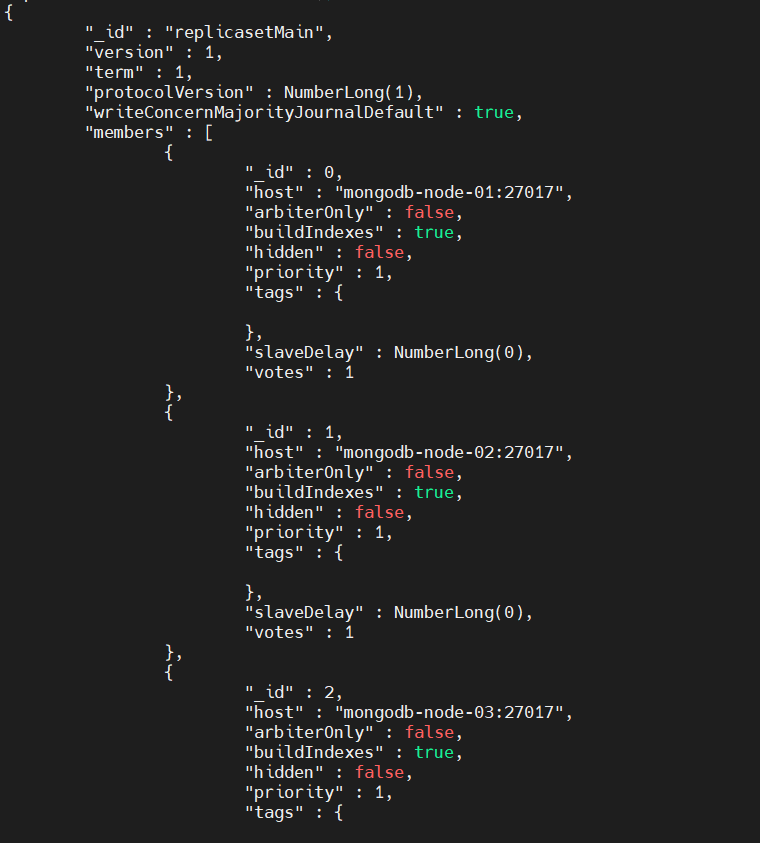
Mit dem Befehl rs.conf() können Sie die Konfiguration des Replica-Sets wie unten gezeigt ansehen.
Ergebnis:
rs.conf()
Ergebnis:
Datenreplikation validieren
Jetzt, da Sie das Replikationsset konfiguriert haben, ist der nächste Schritt die Validierung des Replikationsprozesses. Dazu melden Sie sich zuerst beim primären MongoDB-Knoten im Replica-Set an.
Dann musst du eine Sammlung mit einigen Beispieldaten mit folgenden Befehlen erstellen:
Ergebnis:
    use replicatestdata
db.createCollection("replicatestCollection01")
db.replicatestCollection01.insertMany([
{name: "test_record_one", description: "testing replica set", record: 1},
{name: "test_record_two", description: "testing replica set", record: 2},
{name: "test_record_three", description: "testing replica set", record: 3}
])
Ergebnis:
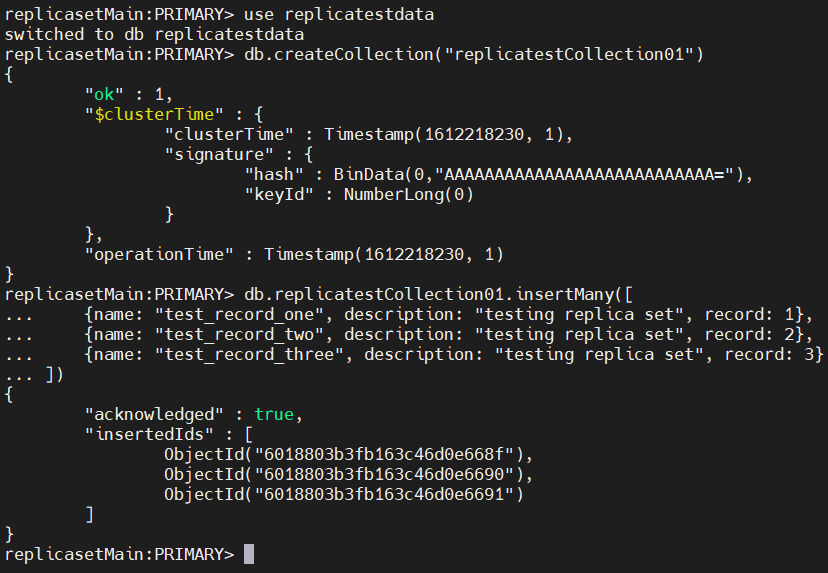
Melden Sie sich als Nächstes an einem sekundären Knoten an und prüfen, ob die Daten repliziert sind. Ein wichtiger Punkt ist, dass Leseabfragen standardmäßig in sekundären Knoten deaktiviert sind. Sie müssen sie also mit folgendem Befehl aktivieren.
db.getMongo().setSecondaryOk()
Danach kannst du nach den Daten suchen und überprüfen, ob sie gut auf den sekundären Knoten repliziert sind.
Ergebnis:
    show dbs
use replicatestdata
show collections
db.replicatestCollection01.find().sort({record: 1}).pretty()
Ergebnis:
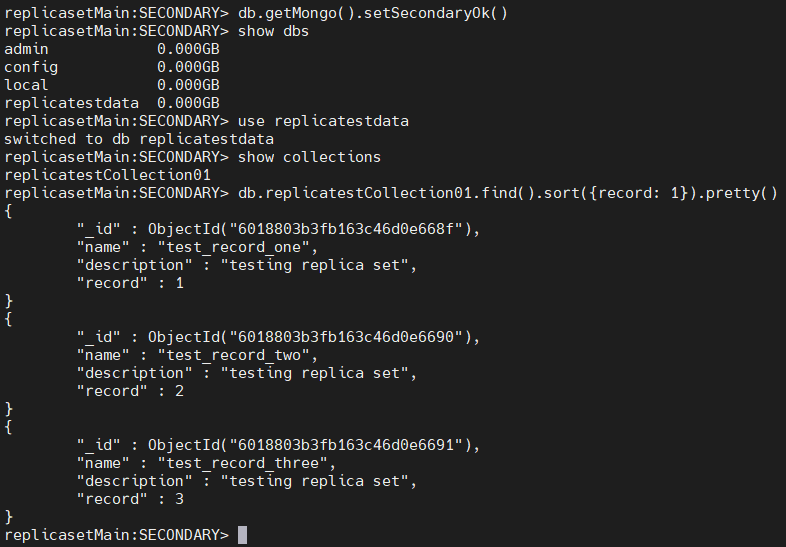
Das obige Ergebnis zeigt, dass die Daten des primären Knotens erfolgreich auf die sekundären Instanzen repliziert wurden.
Hinzufügen eines neuen Knotens zum Replica-Set
Mit dem Befehl rs.add() können Sie einen neuen Knoten zu einem bestehenden Replikensatz hinzufügen.
Bevor du einen neuen Knoten hinzufügst, musst du ihn konfigurieren. Dafür ändere die mongd.conf-Datei so, dass sie das Replica-Set anzeigt, und starte den Mongod-Dienst neu.
Mongodb-Node-04
    # network interfaces
net:
port: 27017
bindIp: 127.0.0.1, mongodb-node-04# replica set
replication:
replSetName: replicasetMain
Gehe dann zum primären Knoten des Replikensets und führe den Befehl add() mit den unten aufgeführten Parametern aus.
- host bezieht sich auf die IP-Adresse oder den Hostnamen des neuen Knotens.
- Priorität gibt die relative Eignung des neuen Knotens an, der primäre Knoten zu werden. (Priorität 0 bedeutet, dass der Knoten unter keinen Umständen der primäre Knoten werden kann.)
- Vote zeigt an, ob der Knoten in der Lage ist, bei Wahlen zur Auswahl des primären Knotens abzustimmen.
Ergebnis:
rs.add( { host: "mongodb-node-04:27017", priority: 0, votes: 1 } )
Ergebnis:
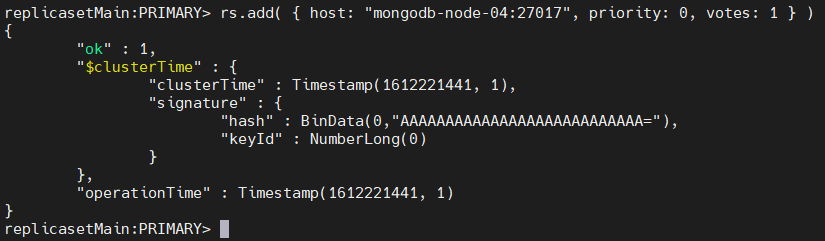
Der obige Befehl fügt dem Replica-Set einen neuen Knoten hinzu. Sie können überprüfen, ob der neue Knoten hinzugefügt wurde, indem Sie den Befehl rs.status() verwenden, der die Details des neuen Knotens anzeigt.
Ergebnis:
rs.status()
Ergebnis:
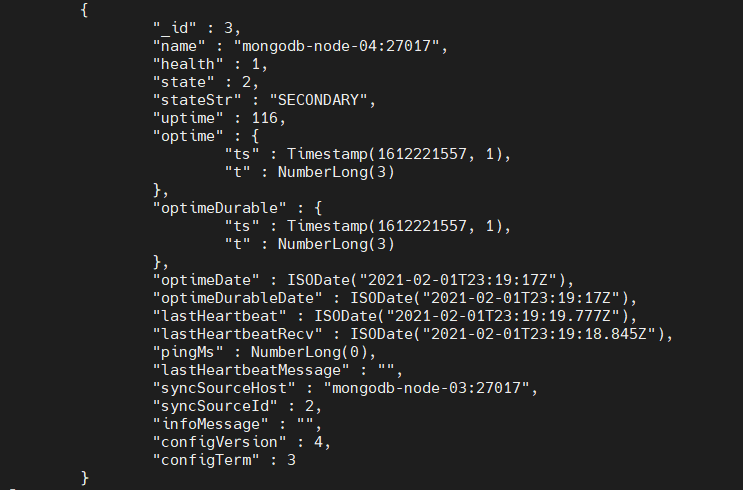
Schließlich werden die Daten in den anderen Knoten automatisch auf den neuen Knoten repliziert.
Entfernung eines Knotens aus dem Replica-Set
Der Befehl rs.remove() kann verwendet werden, um einen Knoten aus dem Replica-Set zu entfernen. Sie müssen die Serverinstanz herunterfahren, bevor Sie versuchen, einen Knoten zu entfernen. Beim Entfernen können Sie angeben, welcher Knoten entfernt werden soll, indem Sie den Namen dieses Knotens verwenden.
Ergebnis:
rs.remove("mongodb-node-04:27017")
Ergebnis:
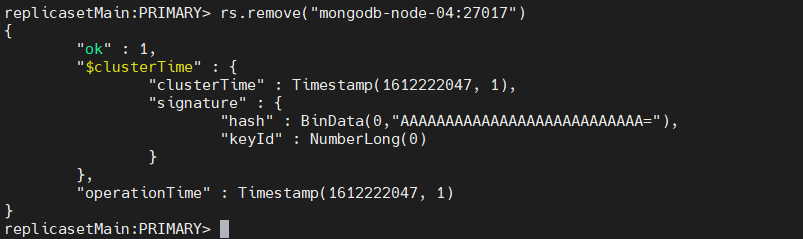
Dieses Ergebnis zeigt an, dass der Knoten erfolgreich aus dem Replikationsset entfernt wurde.
Verwandte Literatur
MongoDB-Leitfaden
- MongoDB-Überblick: Einstieg mit MongoDB
- Wie man MongoDB auf Ubuntu und Mac installiert
- Erstellung einer Datenbank in MongoDB
- MongoDB Shell Grundbefehle
- MongoDB Compass: Nutzung der Mongo GUI
- MongoDB rollenbasierte Zugriffskontrolle (RBAC) erklärt
- MongoDB-Projektion und Projektionsoperatoren erklärt
- MongoDB-Aggregatfunktionen erklärt
- MongoDB-Sortierung: sort()-Methode & Beispiele
- Verwendung von Push-and-Pull-Operatoren in MongoDB
- Wie man MongoDB $unwind
- 23 Gängige MongoDB-Abfrageoperatoren und deren Verwendung
- MongoDB GeoLocation-Abfragebeispiele
- Einführung in MongoDB-Transaktionen
- MongoDB-Indizes: Top-Indextypen und deren Verwaltung
- Die wichtigsten MongoDB-Befehle, die du kennen solltest
- MongoDB-Replikation: Eine vollständige Einführung
- Wie man einen MongoDB-Cluster einrichtet
- MongoDB Sharding: Konzepte, Beispiele & Tutorials
- MongoDB Atlas: Einrichtung und Nutzung von verwaltetem MongoDB
- Wie man MongoDB als Docker-Container ausführt
- MongoDB-Speichernutzung, Verwaltung und Anforderungen
- Wie man Mongodump für MongoDB-Backups verwendet
- Mongorestore-Beispiele zur Wiederherstellung von MongoDB-Backups
- Wie man PyMongo benutzt
- Wie man Mongoose für MongoDB und NodeJS verwendet
- MongoDB Spickzettel
- MongoDB vs Cassandra: NoSQL-Datenbanken im Vergleich
- PostgreSQL vs MongoDB: Vergleich von Datenbanken
- MySQL vs. MongoDB: Vergleich von Datenbanken
- MongoDB-Zertifizierungen: Eine Einführung
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.