




Auf einen Blick: Das Erstellen eines Pandas DataFrame aus einem Wörterbuch ist unkompliziert und verwendet Methoden wie den DataFrame Constructor und from_dict(). Diese Ansätze ermöglichen es Nutzern, DataFrames mit bestimmten Spaltennamen und unterschiedlichen Orientierungen zu erstellen.
- Zwei Methoden zur Erstellung von DataFrames aus Wörterbüchern werden beschrieben.
- Die Kompatibilität mit den entsprechenden Python- und Pandas-Versionen ist entscheidend.
Hier ist ein weiteres Beispiel dafür, wie nützlich und leistungsfähig Pandas ist. Pandas können Datenframes aus vielen Arten von Datenstrukturen erstellen – ohne dass man viel umfangreichen Code schreiben muss. Eine dieser Datenstrukturen ist ein Wörterbuch. In diesem Tutorial zeigen wir Ihnen zwei Ansätze dafür.
Ein Wort zu Pandas-Versionen
Bevor du anfängst, aktualisiere Python auf mindestens 3.7. Mit Python 3.4 ist die höchste verfügbare Version von Pandas 0.22, die in allen Fällen nicht die Angabe von Spaltennamen beim Erstellen eines Wörterbuchs unterstützt. Wenn du virtualenv benutzt, erstelle eine neue Python-Umgebung und installiere Pandas so:
    virtualenv py37  --python=python3.7
pip install pandas
Du kannst die Pandas-Version überprüfen mit:
    import pandas as pd
pd.__version__
Erstellen Sie einen Dataframe mit dem Pandas DataFrame-Konstruktor
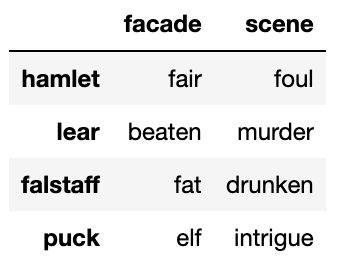
Hier konstruieren wir einen Pandas-Datenrahmen aus einem Wörterbuch. Wir verwenden den Pandas-Konstruktor, da er verschiedene Arten von Datenstrukturen verarbeiten kann. Das untenstehende Wörterbuch hat zwei Schlüssel, Szene und Fassade. Jeder Wert hat ein Array aus vier Elementen, sodass er natürlich in eine Tabelle mit 2 Spalten und 4 Zeilen passt. Pandas ist dafür konzipiert, mit Zeilen- und Spaltendaten zu arbeiten. Jede Zeile hat einen Zeilenindex. Standardmäßig sind es die Zahlen 0, 1, 2, 3, ... Aber es erlaubt auch die Verwendung von Titeln. Verwenden wir das Gleiche im Array idx.
    import pandas as pd

dict =  {'scene': ["foul", "murder", "drunken", "intrigue"],

'facade': ["fair", "beaten", "fat", "elf"]}

idx = ['hamlet', 'lear', 'falstaff','puck']

dp = pd.DataFrame(dict,index=idx)
Hier ist der resultierende Datenrahmen:
Erstellen Sie einen Dataframe mit der Pandas from_dict()-Methode
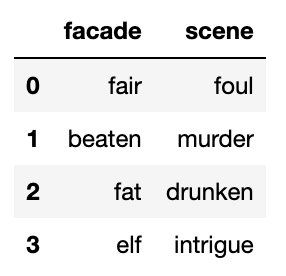
Pandas hat außerdem eine Pandas.DataFrame.from_dict()- Methode. Falls das sich wiederholt, da der reguläre Konstruktor mit Wörterbüchern arbeitet, sieht man im untenstehenden Beispiel, dass die from_dict()- Methode Parameter unterstützt, die einzigartig für Wörterbücher sind. Im Code sind die Schlüssel des Wörterbuchs Spalten. Die Zeilenindizes sind Zahlen. Das ist die Standardorientierung, was orient='Spalten' bedeutet, dass man die Wörterbuchschlüssel als Spalten nimmt und die Werte in Zeilen legt.
pd.DataFrame.from_dict(dict)
Jetzt drehen wir das auf die Seite. Wir machen die Zeilen zu den Wörterbuchtasten.
pd.DataFrame.from_dict(dict,orient='index')
Beachten Sie, dass die Spalten keine Namen haben, sondern nur Zahlen. Das ist nicht sehr nützlich, daher verwenden wir unten den Parameter Columns, der in Pandas 0.23 eingeführt wurde.
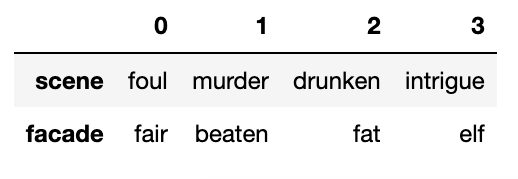
Es ist so einfach, die Spaltennamen in ein Array einzufügen und es als Spaltenparameter zu geben. Man fragt sich, warum die früheren Versionen von Pandas das nicht hatten.
    pd.DataFrame.from_dict(dict,orient='index',columns=idx)

hamlet    lear falstaff      puck

scene    foul  murder  drunken  intrigue

facade   fair  beaten      fat       elf
Verwandte Literatur
- BMC Machine Learning & Big Data Blog
- Pandas: Wie man CSV- und JSON-Dateien liest
- Apache Spark Guide, eine Reihe von Tutorials
- Schneeflocken-Leitfaden
- Erstellung der benutzerdefinierten Redshift-Funktion (UDF) in Python
Pandas Guide
- Pandas-Einführung & Tutorials für Anfänger
- Pandas: Wie man CSV- und JSON-Dateien liest
- Wie man ein Pandas-Dataframe aus einem Wörterbuch erstellt
- Wie man Daten in Pandas gruppiert, verkettet und zusammenführt
- Pandas-Datentypen
- Umgang mit fehlenden Daten in Pandas: NaN-Werte erklärt
- NumPy-Einführung mit Beispielen
- Verwendung von StringIO, um getrennte Textdateien in NumPy zu lesen
- Verwendung der NumPy-Bincount-Statistikfunktion
- Top NumPy Statistische Funktionen & Verteilungen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.