




Auf einen Blick: Der Umgang mit fehlenden Daten in Pandas erfordert das Verständnis von NaN-Werten und die Nutzung von Funktionen wie fillna(), dropna() und interpolate() für ein effektives Management.
- NaN steht für fehlende Daten, die sich von None unterscheiden.
- Methoden umfassen das Weglassen von Zeilen/Spalten oder das entsprechende Ausfüllen von Werten.
In der angewandten Datenwissenschaft fehlen in der Regel Daten. Zum Beispiel fehlt in einer industriellen Anwendung mit Sensoren an bestimmten Tagen Sensordaten.
Sie haben ein paar Alternativen, um mit fehlenden Daten umzugehen. Sie können:
- Lass die ganze Reihe fallen
- Fülle die Zeilen-Spalten-Kombination mit einem bestimmten Wert aus
Es würde keinen Sinn machen, die Spalte wegzulassen, da das diese Metrik für alle Zeilen wegwerfen würde. Schauen wir uns also an, wie man mit diesen Szenarien umgeht.
NaN bedeutet fehlende Daten
Fehlende Daten werden als NaN bezeichnet.
Beachte, dass np.nan nicht gleich Python None ist. Beachte auch, dass np.nan nicht einmal np.nan ist, da np.nan im Grunde undefiniert bedeutet.
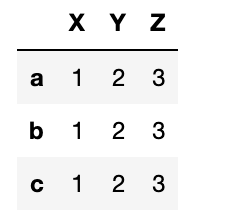
Hier erstellen Sie einen Dataframe mit 3 Spalten und 3 Zeilen. Das Array np.arange(1,4) wird in jede Zeile kopiert.
Ergebnisse:
nat
    import pandas as pd
import numpy as np
df = pd.DataFrame([np.arange(1,4)],index=['a','b','c'],
columns=["X","Y","Z"])
Ergebnisse:
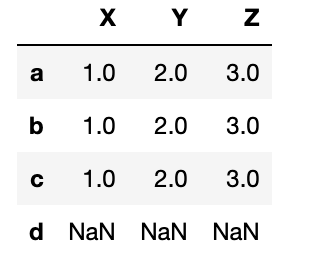
Jetzt indexiert dieses Array neu und fügt einen Index d hinzu. Da d keinen Wert hat, wird es mit NaN gefüllt.
df.reindex(index=['a','b','c','d'])
Isna
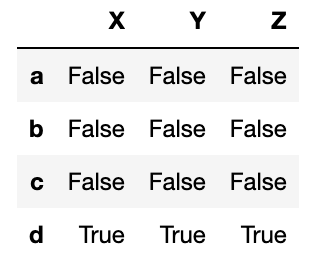
Jetzt benutze isna, um nach fehlenden Werten zu suchen.
pd.isna(df)
notna
Die umgekehrte Kontrolle – die Suche nach tatsächlichen Werten – ist notna().
pd.notna(df)

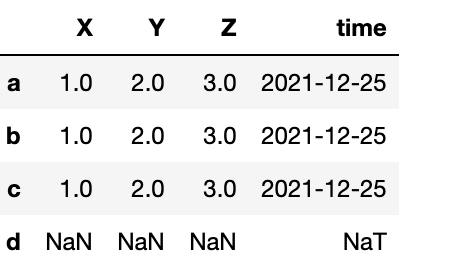
Nat bedeutet ein fehlendes Datum.
    df['time'] = pd.Timestamp('20211225')
df.loc['d'] = np.nan
Fillna
Hier können wir NaN-Werte mit der ganzen Zahl 1 mit fillna(1) füllen. Die Datumsspalte wird nicht geändert, da die ganze Zahl 1 kein Datum ist.
df=df.fillna(1)
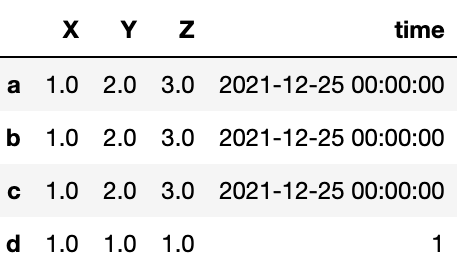
Um das zu beheben, füllen Sie leere Zeitwerte mit:
df['time'].fillna(pd.Timestamp('20221225'))
dropna()
dropna() bedeutet, Zeilen oder Spalten wegzulassen, deren Wert leer ist. Eine andere Möglichkeit, das zu sagen, ist, nur Zeilen oder Spalten anzuzeigen, die nicht leer sind.
Hier füllen wir Zeile c mit NaN:
    df = pd.DataFrame([np.arange(1,4)],index=['a','b','c'],
columns=["X","Y","Z"])
df.loc['c']=np.NaN
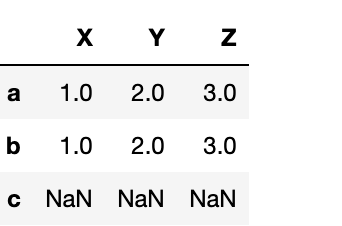
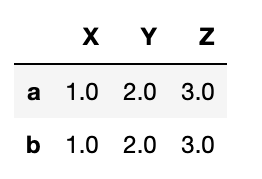
Dann führt man Dropna über die Zeile (Achse = 0) aus.
df.dropna()
Du könntest auch schreiben:
df.dropna(axis=0)
Alle Reihen außer c wurden gestrichen:
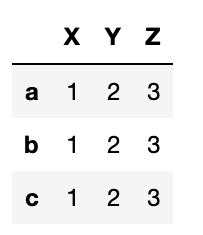
Um die Spalte fallen zu lassen:
Um die Spalte fallen zu lassen:
    df = pd.DataFrame([np.arange(1,4)],index=['a','b','c'],
columns=["X","Y","Z"])
df['V']=np.NaN
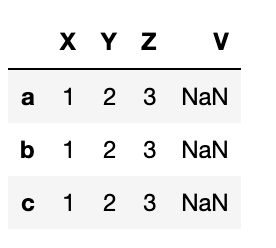
df.dropna(axis=1)
Ein weiteres Merkmal von Pandas ist, dass fehlende Werte mit logischen Zwecken ausgefüllt werden.
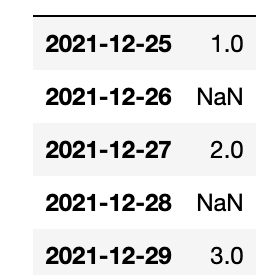
Betrachten wir eine Zeitreihe – nehmen wir an, Sie überwachen eine Maschine und an bestimmten Tagen meldet sie nicht. Darunter meldet sie Weihnachten und an jedem anderen Tag der Woche. Dann indexieren wir die Pandas-Serie neu, wodurch Lücken in unserer Zeitleiste entstehen.
    import pandas as pd
import numpy as np
arr=np.array([1,2,3])
idx=np.array([pd.Timestamp('20211225'),
pd.Timestamp('20211227'),
pd.Timestamp('20211229')])
df = pd.DataFrame(arr,index=idx)
idx=[pd.Timestamp('20211225'),
pd.Timestamp('20211226'),
pd.Timestamp('20211227'),
pd.Timestamp('20211228'),
pd.Timestamp('20211229')]
df=df.reindex(index=idx)
Interpolieren
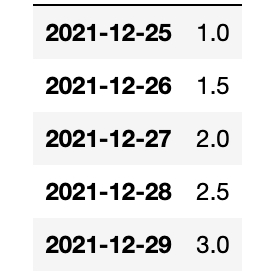
Wir verwenden die Interpolate()- Funktion. Pandas füllt sie schön aus, indem man die Mittelpunkte zwischen den Punkten verwendet. Natürlich, wenn das kurvilinear wäre, würde es eine Funktion darauf anpassen und den Mittelwert auf eine andere Weise finden.
df=df.interpolate()
Damit ist dieses Tutorial beendet.
Verwandte Literatur
Pandas Guide
- Pandas-Einführung & Tutorials für Anfänger
- Pandas: Wie man CSV- und JSON-Dateien liest
- Wie man ein Pandas-Dataframe aus einem Wörterbuch erstellt
- Wie man Daten in Pandas gruppiert, verkettet und zusammenführt
- Pandas-Datentypen
- Umgang mit fehlenden Daten in Pandas: NaN-Werte erklärt
- NumPy-Einführung mit Beispielen
- Verwendung von StringIO, um getrennte Textdateien in NumPy zu lesen
- Verwendung der NumPy-Bincount-Statistikfunktion
- Top NumPy Statistische Funktionen & Verteilungen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.