




Auf einen Blick: Big Data, Datenanalyse und Data Science sind entscheidend, um Erkenntnisse aus großen Datensätzen zu gewinnen, die jeweils unterschiedliche Funktionen erfüllen. Big Data verarbeitet riesige Volumen, Datenanalyse interpretiert Daten für fundierte Entscheidungen, und Data Science integriert mehrere Disziplinen für tiefere Einblicke.
- Big Data verwaltet komplexe Datensätze und übertrifft traditionelle Datentools.
- Datenanalyse konzentriert sich darauf, sinnvolle Informationen für Entscheidungsfindung zu extrahieren.
- Data Science kombiniert verschiedene Fachgebiete für umfassende Analysen und Erkenntnisse.
Daten sind heute der wichtigste Faktor im Geschäft. Infolgedessen wurden verschiedene Technologien, Methoden und Systeme entwickelt, um Daten in dieser datengetriebenen Welt zu verarbeiten, zu transformieren, zu analysieren und zu speichern.
Dennoch herrscht weiterhin viel Verwirrung bezüglich der Schlüsselbereiche Big Data, Data Analytics und Data Science. In diesem Beitrag werden wir diese Konzepte entmystifizieren, um jede Technologie und ihre Beziehung besser zu verstehen.
Daten TL:DR
- Big Data bezeichnet jede große und komplexe Datensammlung.
- Datenanalyse ist der Prozess, bedeutungsvolle Informationen aus Daten zu extrahieren.
- Data Science ist ein multidisziplinäres Fachgebiet, das darauf abzielt, breitere Erkenntnisse zu liefern.
Jede dieser Technologien ergänzt die jeweils andere, kann aber als eigenständige Einheiten verwendet werden. Zum Beispiel können Big Data genutzt werden, um große Datensätze zu speichern, und Datenanalysetechniken können Informationen aus einfacheren Datensätzen extrahieren.
Lesen Sie weiter für weitere Details.
Was ist Big Data?
Wie der Name schon sagt, bezieht sich Big Data einfach auf extrem große Datensätze. Diese Größe, kombiniert mit der Komplexität und der sich wandelnden Natur dieser Datensätze, hat es ihnen ermöglicht, die Fähigkeiten traditioneller Datenmanagement-Tools zu übertreffen. So haben sich Data Warehouses und Data Lakes als bevorzugte Lösungen für den Umgang mit Big Data etabliert und übertreffen damit die Leistungsfähigkeit traditioneller Datenbanken bei weitem.
Einige Datensätze, die wir als wirklich Big Data betrachten können, sind:
- Börsendaten
- Soziale Medien
- Sportveranstaltungen und Spiele
- Wissenschaftliche und Forschungsdaten
(Lesen Sie unsere vollständige Einführung in Big Data.)
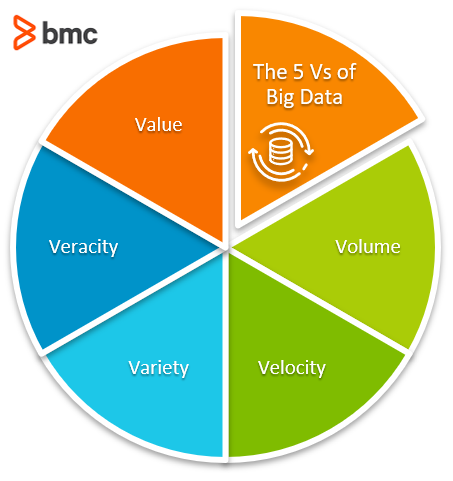
Eigenschaften von Big Data
- Volumen. Big Data ist enorm und übertrifft bei weitem die Fähigkeiten normaler Datenspeicherungs- und -verarbeitungsmethoden. Das Datenvolumen bestimmt, ob es als Big Data kategorisiert werden kann.
- Vielfalt. Große Datensätze sind nicht auf eine einzige Art von Daten beschränkt – sie bestehen stattdessen aus verschiedenen Arten von Daten. Big Data besteht aus verschiedenen Arten von Daten, von tabellarischen Datenbanken bis hin zu Bildern und Audiodaten, unabhängig von der Datenstruktur.
- Geschwindigkeit. Die Geschwindigkeit, mit der Daten erzeugt werden. Im Bereich Big Data werden ständig neue Daten generiert und häufig zu den Datensätzen hinzugefügt. Dies ist besonders häufig im Umgang mit sich ständig weiterentwickelnden Daten wie sozialen Medien, IoT-Geräten und Überwachungsdiensten.
- Wahrhaftigkeit oder Variabilität. Es wird zwangsläufig einige Inkonsistenzen in den Datensätzen aufgrund der Größe und Komplexität von Big Data geben. Daher müssen Sie Variabilität berücksichtigen, um Big Data richtig zu verwalten und zu verarbeiten.
- Wert. Der Nutzen von Big-Data-Ressourcen. Die Qualität der Ergebnisse von Big-Data-Analysen kann subjektiv sein und wird anhand einzigartiger Geschäftsziele bewertet.
Arten von Big Data
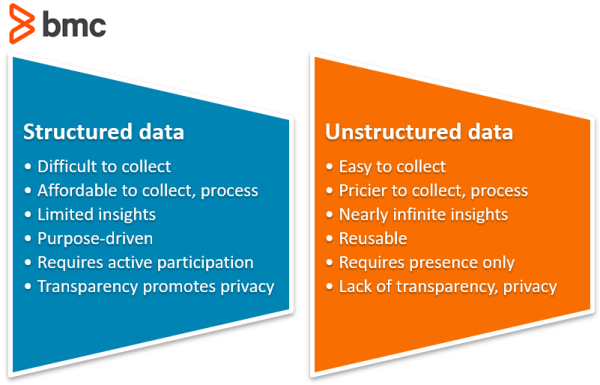
- Strukturierte Daten. Jeder Datensatz, der einer bestimmten Struktur folgt, kann als strukturierte Daten bezeichnet werden. Diese strukturierten Datensätze können im Vergleich zu anderen Datentypen relativ einfach verarbeitet werden, da Nutzer die Struktur der Daten genau identifizieren können. Ein gutes Beispiel für strukturierte Daten ist ein verteiltes RDBMS, das Daten in organisierten Tabellenstrukturen enthält.
- Halbstrukturierte Daten. Diese Art von Daten hält sich nicht an eine bestimmte Struktur, behält aber eine Art beobachtbare Struktur wie eine Gruppierung oder eine organisierte Hierarchie bei. Beispiele für halbstrukturierte Daten sind Markup-Sprachen (XML), Webseiten, E-Mails usw.
- Unstrukturierte Daten. Diese Art von Daten besteht aus Daten, die weder einem Schema noch einer vorgefertigten Struktur entsprechen. Sie sind die am häufigsten verwendete Datenart bei Big Data – Dinge wie Text, Bilder, Video und Audio kommen alle unter diesen Typ vor.
(Erhalte ein tieferes Verständnis für strukturierte und unstrukturierte Datentypen. )
Big-Data-Systeme und -Werkzeuge
Wenn es um die Verwaltung von Big Data geht, stehen viele Lösungen zur Verfügung, um Datensätze zu speichern und zu verarbeiten. Cloud-Anbieter wie AWS, Azure und GCP bieten eigene Data Warehousing- und Data-Lake-Implementierungen an, wie zum Beispiel:
- AWS Redshift
- GCP BigQuery
- Azure SQL Data Warehouse
- Azure Synapse Analytics
- Azure Data Lake
Darüber hinaus gibt es spezialisierte Anbieter wie Snowflake, Databriks und sogar Open-Source-Lösungen wie Apache Hadoop, Apache Storm, Openrefine usw., die robuste Big-Data-Lösungen auf jeder Art von Hardware anbieten, einschließlich Standardhardware.
Was ist Datenanalyse?
Data Analytics ist der Prozess der Datenanalyse, um bedeutungsvolle Daten aus einem gegebenen Datensatz zu extrahieren. Diese Analysetechniken und -methoden werden in den meisten Fällen auf Big Data angewendet, können aber sicherlich auf jeden Datensatz angewendet werden.
(Erfahren Sie mehr über Datenanalyse vs. Datenanalyse)
Das Hauptziel der Datenanalyse ist es, Einzelpersonen oder Organisationen dabei zu helfen, fundierte Entscheidungen auf Basis von Mustern, Verhaltensweisen, Trends, Präferenzen oder jeglicher Art von sinnvollen Daten aus einer Datensammlung zu treffen.
Unternehmen können beispielsweise Analysen nutzen, um ihre Kundenpräferenzen, Kaufgewohnheiten und Markttrends zu identifizieren und dann Strategien zu entwickeln, um diese zu adressieren und sich wandelnde Marktbedingungen zu bewältigen. Im wissenschaftlichen Sinne kann eine medizinische Forschungsorganisation Daten aus medizinischen Studien sammeln und die Wirksamkeit von Medikamenten oder Behandlungen genau bewerten, indem sie diese Forschungsdaten analysiert.
Die Kombination dieser Analysen mit Datenvisualisierungstechniken hilft Ihnen, ein klareres Bild der zugrunde liegenden Daten zu bekommen und sie flexibler und gezielter darzustellen.
Arten von Analytik
Obwohl es mehrere Analysemethoden und -techniken für Datenanalyse gibt, gibt es vier Typen, die auf jeden Datensatz angewendet werden.
- Beschreibend. Dies bezieht sich darauf, zu verstehen, was im Datensatz passiert ist. Als Ausgangspunkt in jedem Analyseprozess hilft die deskriptive Analyse den Nutzern, zu verstehen, was in der Vergangenheit passiert ist.
- Diagnostisch. Der nächste Schritt der deskriptiven Methode ist die Diagnostik, die die deskriptive Analyse berücksichtigt und darauf aufbaut, um zu verstehen, warum etwas passiert ist. Sie ermöglicht es den Nutzern, Wissen über die genauen Informationen über die Ursachen vergangener Ereignisse, Muster usw. zu gewinnen.
- Prädiktiv. Wie der Name schon sagt, wird prädiktive Analytik vorhersagen, was in der Zukunft passieren wird. Dadurch werden Daten aus deskriptiven und diagnostischen Analysen kombiniert und ML- und KI-Techniken eingesetzt, um zukünftige Trends, Muster, Probleme usw. vorherzusagen.
- Präskriptiv. Präskriptive Analytik nimmt Vorhersagen aus prädiktiver Analytik und geht noch einen Schritt weiter, indem sie untersucht, wie die Vorhersagen eintreten werden. Dies gilt als die wichtigste Art der Analyse, da sie es den Nutzern ermöglicht, zukünftige Ereignisse zu verstehen und Strategien auf Vorhersagen effektiv abzuwickeln.
Genauigkeit der Datenanalyse
Das Wichtigste ist, dass die Genauigkeit der Analytik auf dem zugrunde liegenden Datensatz basiert. Wenn es Inkonsistenzen oder Fehler im Datensatz gibt, führt das zu Ineffizienzen oder völlig falschen Analysen.
Jede gute analytische Methode berücksichtigt externe Faktoren wie Datenreinheit , Verzerrung und Varianz in den analytischen Methoden. Datennormalisierung, Reinigung und Transformation von Rohdaten können in diesem Aspekt erheblich helfen.
Datenanalysetools und -technologien
Es gibt sowohl Open-Source- als auch kommerzielle Produkte für Datenanalyse. Diese reichen von einfachen Analysetools wie Microsoft Excels Analysis ToolPak, das mit Microsoft Office geliefert wird, über die SAP BusinessObjects-Suite bis hin zu Open-Source-Tools wie Apache Spark.
Bei Cloud-Anbietern gilt Azure als die beste Plattform für Datenanalyse-Bedürfnisse. Es bietet mit seiner Azure Synapse Analytics Suite, Apache Spark-basierten Databricks, HDInsights, Machine Learning usw. ein komplettes Werkzeugset, um jeden Bedarf zu erfüllen.
AWS und GCP bieten außerdem Tools wie Amazon QuickSight, Amazon Kinesis und GCP Stream Analytics an, um Analysebedürfnisse zu erfüllen.
Darüber hinaus bieten spezialisierte BI-Tools leistungsstarke Analysefunktionen mit relativ einfachen Konfigurationen. Beispiele hierfür sind Microsoft PowerBI, SAS Business Intelligence und Periscope Data. Sogar Programmiersprachen wie Python oder R können verwendet werden, um individuelle Analyseskripte und Visualisierungen für gezieltere und fortgeschrittenere Analysebedürfnisse zu erstellen.
Schließlich können ML-Algorithmen wie TensorFlow und scikit-learn als Teil des Datenanalyse-Werkzeugkastens betrachtet werden – sie sind beliebte Werkzeuge für den Analyseprozess.
Unterschied zwischen Datenanalyse und Big-Data-Analyse
Größe und Umfang sind nicht die einzigen Dinge, die Big Data Analytics von gewöhnlicher Datenanalyse unterscheiden. Das Verständnis der Unterschiede hilft Ihnen, Big-Data-Analytics-Konzepte und die Big Data, die sie antreibt, zu verstehen.
- Skalierung: Datenanalyse kann kleine bis mittelgroße Datensätze verarbeiten, während Big Data Analytics speziell für sehr große und komplexe Datensätze entwickelt wurde.
- Werkzeuge und Infrastruktur: Datenanalyse verwendet typischerweise einfachere Werkzeuge und kann oft auf einer einzigen Maschine durchgeführt werden, während Big-Data-Analysen verteiltes Rechnen und fortschrittlichere, skalierbare Werkzeuge erfordern.
- Datentypen: Datenanalyse beschäftigt sich häufig mit strukturierten Daten (wie relationalen Datenbanken), während Big Data Analytics häufig unstrukturierte oder semistrukturierte Daten (wie Text, Bilder oder Sensordaten) zusätzlich zu strukturierten Daten umfasst.
- Verarbeitung: Big-Data-Analysen erfordern aufgrund der hohen Datengeschwindigkeit oft Echtzeit- oder nahezu Echtzeit-Verarbeitung, während Datenanalyse nicht unbedingt eine solche Geschwindigkeit erfordert.
- Funktionalität: Big-Data-Analysen integrieren fortschrittlichere Funktionen, darunter maschinelles Lernen und künstliche Intelligenz, um eine tiefgehende Analyse zu liefern, die wertvolle Erkenntnisse liefert.
- Sicherheitsherausforderungen: Aufgrund der Größe und Größe von Big Data ist Drittanbieter-Speicher die Norm, was deutlich stärkere Cybersicherheitsschutzmaßnahmen erfordert.
Was ist Data Science?
Jetzt haben wir ein klares Verständnis von Big Data und Datenanalyse. Was genau ist Data Science?
Im Gegensatz zu den ersten beiden kann Data Science nicht auf eine einzelne Funktion oder ein einziges Feld beschränkt werden. Data Science ist ein multidisziplinärer Ansatz, der Informationen aus Daten extrahiert, indem er Folgendes kombiniert:
- Wissenschaftliche Methoden
- Mathematik und Statistik
- Programm
- Fortgeschrittene Analytik
- ML und KI
- Deep Learning
In der Datenanalyse liegt der Hauptfokus darauf, aus den zugrunde liegenden Daten sinnvolle Erkenntnisse zu gewinnen. Der Umfang von Data Science geht weit über diesen Zweck hinaus – Data Science beschäftigt sich mit allem, von der Analyse komplexer Daten über die Entwicklung neuer Analysealgorithmen und Werkzeuge zur Datenverarbeitung und -reinigung bis hin zum Aufbau leistungsstarker, nützlicher Visualisierungen.
Data-Science-Tools und -Technologien
Dazu gehören Programmiersprachen wie R, Python und Julia, die zur Erstellung neuer Algorithmen, ML-Modelle und KI-Prozesse für Big-Data-Plattformen wie Apache Spark und Apache Hadoop verwendet werden können.
Datenverarbeitungs- und Reinigungswerkzeuge wie Winpure, Data Ladder sowie Datenvisualisierungstools wie Microsoft Power Platform, Google Data Studio, Tableau bis hin zu Visualisierungsframeworks wie Matplotlib und Ploty können ebenfalls als Data-Science-Tools betrachtet werden.
Da Data Science alles rund um Daten abdeckt, kann jedes Tool oder jede Technologie, die in Big Data und Data Analytics verwendet wird, irgendwie im Data-Science-Prozess eingesetzt werden.
Big Data vs. Datenanalyse
Big Data ist der Begriff für große Datenmengen, die schnell an Volumen wachsen. Die Daten können verschiedene Formen annehmen, wie strukturiert, unstrukturiert und eine Mischung aus beidem. Um sie zu verarbeiten und zu speichern, benötigen Sie parallele Rechenkapazitäten und fortschrittliche Datenmanagement-Tools. Data Scientists mit Big-Data-Expertise müssen sich gut mit der Programmierung von NoSQL-Datenbanken sowie verteilten Systemen und Frameworks auskennen. Big-Data-Analytik wird routinemäßig im Finanzdienstleistungsbereich, Einzelhandel, Medien, Unterhaltung und Kommunikation eingesetzt.
Datenanalyse ist der Prozess, bei dem Erkenntnisse aus der Analyse von Rohdaten gewonnen werden, wobei Techniken von deskriptiv über diagnostisch, prädiktiv bis präskriptiv reichen. Während Data Scientists hilfreich sein können, sind erfahrene Datenanalysten mit Hintergrund in Programmierung, Statistik und Mathematik gut in der Lage, die Herausforderungen zu meistern. Datenanalysetechniken werden eingesetzt, um Risiken zu identifizieren und zu managen – im Energiemanagement sowie im Bereich Gaming, Gesundheitswesen, Reisen und Wissenschaft.
Big Data vs. Data Science
- Datenmanagement: Big Data beschäftigt sich mit der Speicherung und Verarbeitung großer Datenmengen, während Data Science bereits bereinigte und verarbeitete Daten verwendet.
- Datentypen: Big Data umfasst viele Arten von Daten in strukturierten, unstrukturierten und semistrukturierten Formen. Data Science konstruiert Modelle und Programme oder Algorithmen, die verschiedene Datentypen verwenden.
- Veränderungsgeschwindigkeit: Big Data wächst schnell im Volumen und Data Science nutzt eine Vielzahl von Werkzeugen und Techniken, um deren Analyse durchzuführen.
- Timing: Big Data unterstützt die Echtzeit-Datenverarbeitung. Data Science wendet statistische Techniken und maschinelles Lernen für Echtzeit- und nahezu Echtzeit-Erkenntnisse und Trendverfolgung an.
- Verteilung: Big Data befinden sich in Repositories, die von Data Scientists abgefragt werden können, typischerweise in einer vernetzten Rechenumgebung.
Datenanalyse vs. Data Science
Sowohl Datenanalyse als auch Data Science sind eng verwandte Bereiche, die sich mit dem Gewinnen von Erkenntnissen, der Verfolgung von Trends und der Nutzung vergangener Daten beschäftigen, um Entscheidungen über die Zukunft zu treffen.
Data Science ist das übergeordnete Konzept, zu dem auch Datenanalyse gehört. Dazu gehören auch Data Engineering, maschinelles Lernen, Statistik, Programmierung prädiktiver Modelle sowie die Entwicklung und Programmierung von Algorithmen.
Datenanalyse konzentriert sich darauf, Antworten und Erkenntnisse zu spezifischen Fragen zu finden, um die Bedürfnisse einer Organisation zu erfüllen. Die Arbeit umfasst die Erstellung spezifischer Datensätze, die Durchführung verschiedener Analysearten, das Gewinnen von Erkenntnissen und die Präsentation der Informationen auf eine für Entscheidungsträger nützliche Weise.
Data Science vs. Big Data vs. Data Analytics vs. Data Analytics
| Aspekt | Datenwissenschaft | Big Data | Datenanalyse |
| Definition | Das interdisziplinäre Feld, das wissenschaftliche Methoden, Prozesse, Algorithmen und Systeme nutzt, um Wissen und Erkenntnisse aus strukturierten und unstrukturierten Daten zu gewinnen. | Die Erfassung, Speicherung und Verarbeitung großer Mengen unterschiedlicher Datentypen, die die traditionellen Verarbeitungsfähigkeiten übersteigen. | Der Prozess der Analyse von Datensätzen, um Schlussfolgerungen zu ziehen, Muster zu erkennen und Entscheidungsfindung zu unterstützen. |
| Ziel | Umsetzbare Erkenntnisse zu gewinnen und prädiktive Modelle zu entwickeln, die Entscheidungen informieren und Innovationen vorantreiben. | Riesige Datensätze effizient und zuverlässig zu speichern, zu verwalten und zu verarbeiten, oft in Echtzeit oder nahezu in Echtzeit. | Sinnvolle Einblicke zu liefern und operative oder strategische Entscheidungen durch Datenanalyse zu unterstützen. |
| Fokus | Datenexploration, Modellbau, Algorithmusentwicklung und Interpretation komplexer Daten. | Bearbeitung der 3V-Daten (Volumen, Geschwindigkeit, Vielfalt) der Daten und Sicherstellung skalierbarer und effizienter Datenpipelines. | Analyse und Berichterstattung von Daten zur Identifizierung von Trends, zur Leistungsmessung und zur Entscheidungsfindung. |
| Hauptaufgaben | Datenerhebung, Reinigung, Erkundung, Modellierung (maschinelles Lernen), Validierung, Visualisierung und Kommunikation von Erkenntnissen. | Erfassung, Speicherung und Verarbeitung von Daten aus unterschiedlichen Quellen; Sicherstellung von Datenqualität, Skalierbarkeit und Integration. | Beschreibende Statistiken, Trendanalysen, Visualisierungen und grundlegende prädiktive Erkenntnisse (oft über Dashboards und Berichte). |
| Werkzeuge/Technologien | Python, R, Jupyter Notebook, TensorFlow, PyTorch, Scikit-Learn, SQL, Spark (für einige ML-Aufgaben). | Hadoop, Spark, HDFS, NoSQL-Datenbanken (z. B. MongoDB, Cassandra), Echtzeit-Streaming-Plattformen (z. B. Kafka). | SQL, Excel, Tableau, Power BI, Google Data Studio, etwas Scripting in Python/R für leichte Analysen. |
| Datentypen | Strukturierte, halbstrukturierte und unstrukturierte Daten, die vorverarbeitet und zur Analyse bereinigt wurden. | Strukturierte, halbstrukturierte und unstrukturierte Daten – oft roh, massiv und in unterschiedlichen Formaten (Text, Bilder, Protokolle usw.). | Hauptsächlich strukturierte und semistrukturierte Daten (oft aus verarbeiteten Big Data oder Data Warehouses bezogen). |
Daten sind die Zukunft
Letztlich helfen Big Data, Datenanalyse und Data Science Einzelpersonen und Organisationen, riesige Datensätze zu bewältigen und wertvolle Informationen daraus zu gewinnen. Da die Bedeutung von Daten exponentiell wächst, werden sie zu wesentlichen Bestandteilen der technologischen Landschaft werden.
Verwandte Literatur
- BMC Machine Learning & Big Data Blog
- DataOps erklärt: Verstehen Sie, wie DataOps Analysen nutzt, um umsetzbare Geschäftserkenntnisse zu liefern
- Was ist eine Datenpipeline?
- Datenbankadministratoren (DBA) Rollen und Verantwortlichkeiten im Big-Data-Zeitalter
- Data Streaming erklärt: Vor- und Nachteile und wie es funktioniert
- Datenethik für Unternehmen
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.