




Auf einen Blick: AWS Glue Crawler automatisiert Datenentdeckung, Katalogisierung und Organisation aus verschiedenen Quellen und verbessert so die Vorbereitung auf Analysen. Der Leitfaden beschreibt, wie man einen Crawler erstellt und konfiguriert, Daten in Amazon S3 verwaltet und einen aktualisierten Datenkatalog generiert.
- Der Crawler scannt Datenquellen wie S3 und JDBC.
- Wichtige Schritte umfassen das Hochladen von Daten, die Konfiguration des Crawlers und die Angabe der Ausgabepositionen.
In diesem Tutorial erläutern wir, was ein Crawler in Amazon Web Services (AWS) ist, und zeigen Ihnen, wie Sie Ihren eigenen Amazon Glue Crawler erstellen.
AWS Glue, ein vollständig verwalteter Dienst von Amazon, übernimmt Datenoperationen wie ETL (extrahieren, transformieren, laden), um die Daten für Analyseaktivitäten vorzubereiten und zu laden. Glue kann Datenquellen von S3, DynamoDB und JDBC crawlen.
Was ist ein Crawler?
Ein Crawler ist eine automatisierte Software-App, die den Inhalt von Webseiten "crawlt" und den Links auf diesen Seiten folgt, um weitere Seiten zu finden und zu crawlen. Diese Softwareprogramme werden manchmal auch Spiders oder Bots genannt und crawlen mit einem bestimmten Zweck. Sie können Webseiten durchsuchen, um Inhalte für Suchmaschinen zu scannen und zu indexieren. Sie können auch große Datensätze für die Inhaltsaggregation, das Erkennen von Trends, die Durchführung von Sentiment-Analysen oder die Überwachung von Funktionen und Preisen extrahieren. Internetarchivierungsseiten verwenden Crawler, um eine historische Aufzeichnung von Webseiten für die spätere Referenz zu erstellen. Crawler sind auch für Link-Checks und SEO-Audits nützlich.
Was ist der AWS Glue Crawler?
Der AWS Glue Crawler ist ein Tool von Amazon, das automatisiert, wie Sie Daten aus verschiedenen Quellen entdecken, katalogisieren und organisieren. Zum Beispiel kann der AWS Glue Crawler verwendet werden, um die Amazon Simple Storage Service (S3) relationale Datenbank oder andere Datenquellen wie DynamoDB, JDBC und MongoDB zu crawlen.
Der Amazon Glue Crawler scannt und katalogisiert Daten, um Änderungen in der Struktur von Daten oder Schemata zu erkennen. Er kann einen aktualisierten Datenkatalog erstellen und Extract, Transform, and Load (ETL)-Operationen für schnelle Verarbeitung und Analysen durchführen. Er integriert sich außerdem mit AWS-Analysediensten. Der AWS Glue Crawler füllt Amazon S3-Buckets – skalierbare, sichere und langlebige Speichercontainer für große Mengen an Dateien und Daten – zusammen mit begleitenden Metadaten.
Erfahren Sie mehr über die Innovation der AWS-Cloud-Datenbanken.
Verständnis der AWS Glue-Architektur und des Arbeitsablaufs
Die AWS Glue-Architektur und der Workflow beginnen damit, sich mit einem Datenspeicher zu verbinden und ihn zu crawlen, der ein Bucket wie Amazon S3 oder eine Datenbank wie Amazon RDS, Amazon Redshift, Amazon DynamoDB oder JDBC sein kann.
Als nächstes bestimmt AWS Glue die Struktur und das Format der Daten mithilfe von Klassifikatoren, also Regelsätzen, die Glue-Datentypen, Schemata, Dateiformate und verschiedene Metadatentypen identifizieren.
Schließlich schreibt AWS Glue die Metadaten in ein zentrales Repository, das als Datenkatalog bezeichnet wird. Dieses enthält Informationen über die Quelle der Daten, das Datenschema und andere Datenbeschreibungen.
Wie man einen Crawler in AWS Glue erstellt
Jetzt, da wir die wichtigsten Komponenten des Amazon Glue-Crawlers verstanden haben – von der Architektur, den Datenspeichern und dem Datenkatalog bis hin zur Interaktion zwischen den einzelnen Komponenten – wollen wir besprechen, wie man einen Crawler in AWS Glue erstellt.
1. Beispiel-JSON-Daten herunterladen
Wir brauchen einige Beispieldaten. Da wir zeigen wollen, wie man Daten in Glue verbindet, brauchen wir zwei Datensätze mit einem gemeinsamen Element.
In unserem AWS-Glue-Crawler-Beispiel verwenden wir Daten aus der IMDB. Wir haben eine kleine Teilmenge (24 Datensätze) dieser Daten ausgewählt und ins JSON-Format gebracht. (Konkret wurden sie so formatiert, dass sie in DynamoDB geladen werden, was wir später tun werden.)
Eine Datei enthält die Beschreibung eines Films oder einer TV-Serie. Die andere enthält Bewertungen für diese Serie oder diesen Film. Da die Daten in zwei Dateien vorliegen, müssen diese Daten kombiniert werden, um die Bewertungen nach Titel zu erhalten. Kleber kann das tun.
Laden Sie diese beiden JSON-Datendateien herunter:
2. Laden Sie die Daten auf Amazon S3 hoch
Erstelle diese Buckets in S3 mit dem Amazon AWS-Befehlszeilen-Client. (Vergiss nicht, AWS auszuführen , um deinen privaten Schlüssel und dein Geheimnis auf deinem Computer zu speichern, damit du auf Amazon AWS zugreifen kannst.)
Unten erstellen wir die Buckets, Titel und Bewertungen in movieswalker. Der Grund dafür ist, dass Glue ein separates Tabellenschema erstellt, wenn wir diese Daten in separate Buckets legen.
(Dein Top-Level-Bucket-Name muss für ganz Amazon einzigartig sein. Das ist eine Amazon-Anforderung, da du den Bucket mit einer URL beziehst. Keine zwei Kunden dürfen dieselbe URL haben.)
    aws s3 mb s3://movieswalker

aws s3 mb s3://movieswalker/titles

aws s3 mb s3://movieswalker/ratings
Dann kopieren Sie die Titel-Grundlagen- und Bewertungsdatei in die jeweiligen Kategorien.
    aws s3 cp 100.basics.json s3://movieswalker/titles

aws s3 cp 100.ratings.tsv.json s3://movieswalker/ratings
3. Konfigurieren Sie den Crawler in Kleber
Melden Sie sich in der Glue-Konsole für Ihre AWS-Region an. (Meine ist Europa-West.)
Gehe dann zum Crawler-Bildschirm und füge einen Crawler hinzu:
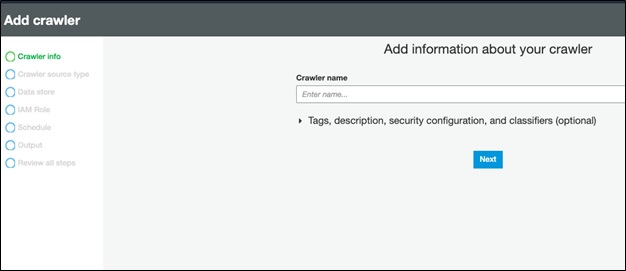
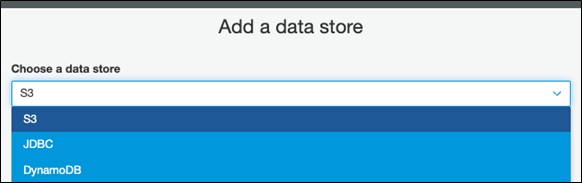
Als Nächstes wählen wir einen Datenspeicher. Ein besserer Name wäre Data Source, da wir Daten von dort ziehen und in Glue speichern.
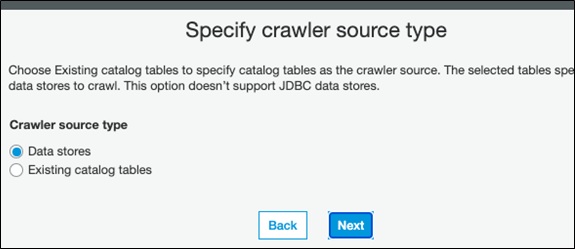
Dann wähle den oben erstellten Movieswalker-Ordner auf oberster Ebene.
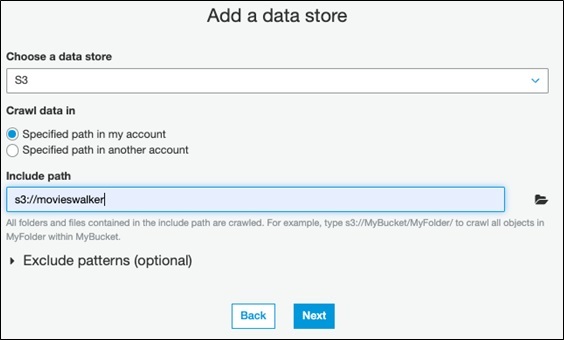
Beachten Sie, dass der Datenspeicher S3, DynamoDB oder JDBC sein kann.
Dann starte den Crawler. Wenn er fertig ist, kannst du dir die Stämme ansehen.
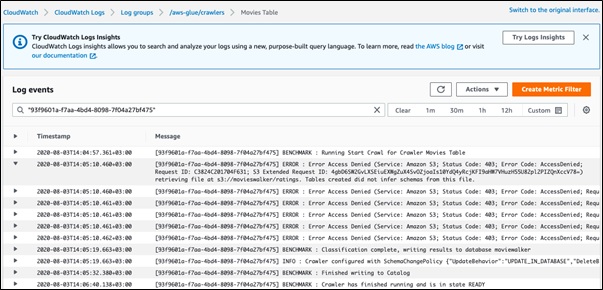
Wenn du diesen Fehler bekommst, handelt es sich um einen S3-Policy-Fehler. Du kannst die Tabellen nur für dieses Tutorial öffentlich machen, falls du nicht in IAM-Richtlinien eintauchen möchtest. In diesem Fall bekam ich diesen Fehler, weil ich die Dateien als Amazon-Root-Benutzer hochgeladen habe, während ich versucht habe, mit einem mit IAM erstellten Benutzer darauf zuzugreifen.
ERROR : Error Access Denied (Service: Amazon S3; Status Code: 403; Error Code: AccessDenied; Request ID: 16BA170244C85551; S3 Extended Request ID: y/JBUpMqsdtf/vnugyFZp8k/DK2cr2hldoXP2JY19NkD39xiTEFp/R8M+UkdO5X1SjrYXuJOnXA=) retrieving file at s3://movieswalker/100.basics.json. Tables created did not infer schemas from this file.
Sehen Sie sich das Crawler-Logbuch an. Hier können Sie jeden Schritt des Prozesses sehen.
4. Tabellen anzeigen, die in AWS Glue erstellt wurden
Hier sind die in Kleber erstellten Tabellen.

Wenn du darauf klickst, kannst du das Schema sehen.
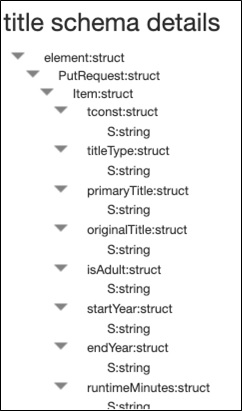
Es hat diese Eigenschaften. Das Interessante hier ist, dass die Daten im Hive-Format gespeichert wurden, was bedeutet, dass es Hadoop verwenden muss, um das zu speichern.
AWS Glue Crawler Tutorial: Wichtige Schritte zusammengefasst
- Daten auf Amazon S3 hochladen.
- Erstellen und konfigurieren Sie einen Crawler mit den richtigen Zugriffsberechtigungen, der die Datenquelle und den Pfad identifiziert.
- Konfigurieren Sie die Klassifikatoren, die Ihr Crawler zur Interpretation der Datenstruktur verwendet.
- Gib einen Ausgabestandort im Datenkatalog an. Du bist jetzt bereit, den Crawler auszulösen und auszuführen.
Die Nutzung von AWS Glue ist eine großartige Möglichkeit, Datenerkennung, -abfragen und -verarbeitung zu automatisieren. Um mehr über andere AWS-Management-Tools zu erfahren, besuchen Sie unseren Blog bei AWS Management Tools.
AWS Glue Leitfaden
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.