




Auf einen Blick: Graphdatenbanken verwalten vernetzte Daten effizient und ermöglichen schnelle Beziehungsanfragen, was sie ideal für Anwendungen wie Betrugserkennung und Echtzeitempfehlungen macht. Sie nutzen Knoten und Kanten, um Datenverbindungen darzustellen.
- Graphdatenbanken sind hervorragend darin, Datenbeziehungen zu erforschen.
- Beliebte Graphdatenbankoptionen sind Neo4j und Amazon Neptune.
Daten bestimmen die Tech-Welt. Daten, Daten, Daten. Es gibt Daten, die ein Nutzer sehen muss, Daten, die von einem Data Scientist überprüft werden müssen. Daten für Investoren. Daten für das Management. Daten. Für jede Organisation beeinflusst die Art und Weise, wie Sie Ihre Daten strukturieren und speichern, Ihren potenziellen Erfolg.
Das Unternehmen speichert seine Daten in handschriftlichen Microsoft Word-Dokumenten und ist ein Schritt hinter der Lagerung seiner Daten in leicht lesbaren Excel-Diagrammen auf einem Cloud-Server zurück. Innovation setzt sich in der Datenbankwelt fort – das sind Graphdatenbanken.
Wie traditionelle Datenbanken funktionieren
Daten wurden traditionell in Tabellen gespeichert. Für die Coffeeshop-Branche sieht man wahrscheinlich eine Reihe von Tabellen wie folgt:
Graph
| Café |
|---|
| Name |
| NOVO |
| Dampf |
| Dumpf |
| Corvus |
Kunden
| CustomerID | Name | BDay | Telefon | |
|---|---|---|---|---|
| 123461 | Jack | 1-1-1970 | a@b | 1 |
| 41263 | Jim | 1-1-1970 | b@c | 2 |
| 45714 | Jill | 1-1-1970 | c@d | 3 |
| 71129 | Jerome | 1-1-1970 | d@e | 4 |
| 90123 | Jeb | 1-1-1970 | e@f | 5 |
Dann gibt es separate Tabellen, um alle Bestellungen, Mitarbeiter, Lagerbestände und Lieferanten zu speichern. Wir haben 6 Datentabellen, um die Daten der Coffeeshop-Branche zu speichern. In der traditionellen relationalen Datenbank erfordert jede neue Beziehung, die bekannt sein soll, eine neue Tabelle, um Informationen zu speichern.
Obwohl Inventargegenstände in Tabellen gut funktionieren können, sind sie bei der Darstellung von Beziehungen zwischen Entitäten begrenzt.
In traditionellen Datenbanken erfordert die Beantwortung von Beziehungsfragen, dass IDs doppelt über Tabellen eingegeben werden und dann eine Anzahl von Join-Anweisungen , die so etwas sagen wie: "Geben Sie alle Werte zurück, bei denen ID-1 mit anderen ID-1 in all diesen Tabellensätzen übereinstimmt. Dann sehen Sie sich andere gängige IDs an, die in den Tabellen mit ID-1 erscheinen, und finden Sie diese IDs auch über alle Tabellensätze."
Das Cornell Movie Dialogue Corpus ist eine traditionelle Datenbank. Um zu wissen, wer was in welchem Film gesagt hat, muss man die IDs mit der Filmzeile abgleichen, um zu sehen, dass die Zeile "Here's to looking at you, kid" von der Charakter-ID 546 (Humphrey Bogart) und der Film-ID 123 (Casablanca) gesprochen wurde.
Man kann relationale Fragen mit traditionellen SQL- und NoSQL-Datenbanken beantworten, aber nur durch eine gut durchdachte Frage, die explizit angibt, welche Tabellen erforscht und verbunden werden sollen (enorme Arbeit). Dann warte eine Weile, bis die Abfrage zurückgegeben wird.
Abfragen zu Beziehungen in nicht-graphbasierten Datenbanken skalieren nicht gut. Die Beziehungsfragen in relationalen Datenbanken können Minuten dauern, während dieselbe Abfrage in einer Graphdatenbank Sekunden dauern kann.
Was ist eine Graphdatenbank?
Da Menschen in eine zunehmend vernetzte Gesellschaft eintreten, müssen Verbindungen ausgedrückt werden. Von Social-Media-Feeds, um zu zeigen, wer mit wem befreundet ist, über empfohlene Listen, die zeigen, dass Leute, die diese Lieder oder Videos ebenfalls mögen, bis hin zur Identifizierung des abtrünnigen Gruppenmitglieds , das am wahrscheinlichsten eine Bedrohung darstellt, helfen Graphendatenbanken, diese Informationen zu speichern und sie mühelos abzufragen.
Graphdatenbanken werden verwendet, um hoch miteinander verbundene Daten zu verstehen. Sie sind hervorragend darin, die Beziehungen zwischen Daten zu erforschen. Von Natur aus können Graphdatenbanken diese Arten von Fragen leicht beantworten:
- Mögen die Freunde des Nutzers die gleiche Musik wie der Nutzer?
- Ist es so, dass dieser betrügerische Nutzer entdeckt werden könnte, weil er weniger Beziehungen zu anderen Gruppenmitgliedern hat?
- Wenn diese Person solche Dinge weiß, wie groß ist die Wahrscheinlichkeit, dass sie die Zusammenhänge erkennt und diese anderen Dinge lernt?
Anwendungsfälle
Graphdatenbanken sind schemafrei und veränderbar. Graphdatenbanken sind besonders gut zu verwenden, wenn Sie Folgendes benötigen:
- Untersuchen Sie die Beziehungen zwischen Daten
- Skalieren Sie Anfragen leicht auf immer mehr Beziehungen
Beispiele für Anwendungsfälle für Graphdatenbanken sind:
- Betrugserkennung
- Echtzeit-Empfehlungen
- Datenmanagement
- Identitätsmanagement
- Netzwerk- und IT-Betrieb
Die drei Graphkomponenten
Das Konzept eines Graphen ist ein mathematischer Begriff, der aus der Graphentheorie stammt. Die Graphen der Graphentheorie können als Bäume, Netzwerke, Netze oder Gedankenkarten betrachtet werden. Wählen Sie Ihren Dämon. Sie bestehen alle aus denselben Teilen:
- Knoten
- Edge
- Graph
Knoten
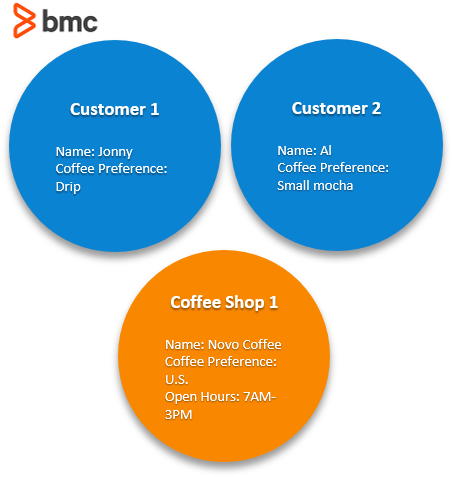
Das Grundelement des Graphen ist der Knoten. Diese sind jeweils Punkte entlang des Graphen:
- Ein Knoten enthält Daten wie den Kundennamen und die Wahl des Kaffees.
- Ein weiterer Knoten auf derselben Grafik könnte den Namen eines Cafés, seine Adresse und seine Öffnungszeiten enthalten.
Edge
Der Rand im Diagramm definiert die Beziehungen zwischen den Entitäten. Für unsere beiden oben genannten Kunden können wir sagen, dass beide das Café "besuchen". Die Bezeichnung variiert je nach Organisation und Bedürfnissen. Zum Beispiel kann "attends" durch Kunden, Kund, Kunde, Nutzer usw. ersetzt werden.
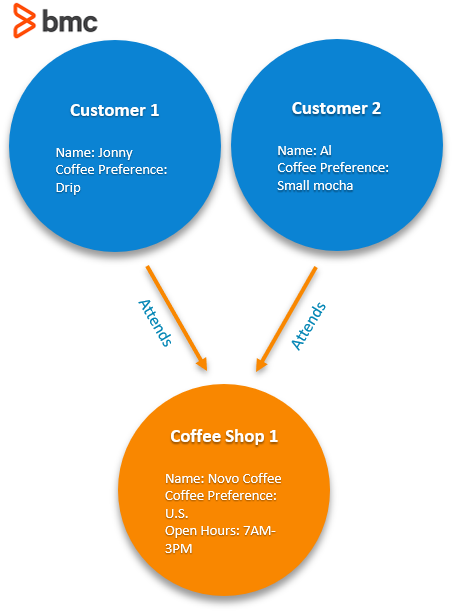
Abschließend haben wir unser Diagramm der Knoten und Kanten. Daraus können wir Beziehungen darstellen wie: "Kunde 1 und Kunde 2 besuchen beide Coffee Shop 1" und "Nur Kunde 1 besucht Coffee Shop 2".
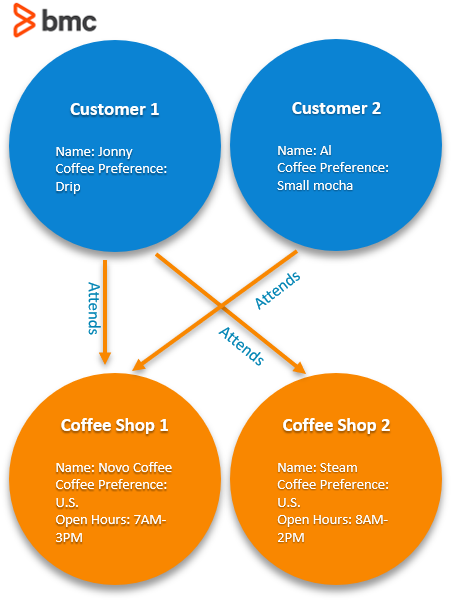
Wir könnten diesem Diagramm viele weitere Beziehungen hinzufügen. Innerhalb dieses Diagramms könnten wir:
- Zeigen Sie die Lieferanten zu jedem Café.
- Füge Familie und Freunde dieser beiden Kunden hinzu, erstelle so eine Kante "Familie", "Bruder", "Freund" zum Netzwerk und zeige ihre Kaffeevorlieben, und nutze dann auch den "Attends"-Rand, um anzugeben, welche Läden sie besuchen.
Diese Grafiken können unglaublich komplex werden.
Beliebte Graphentools von Cloud-Anbietern
Neo4j ist einer der größten Anbieter in der Graphenwelt und baut eine Kubernetes-Infrastruktur auf, die die Graphdatenbank auf jedem Cloud-Service implementieren kann. Das bedeutet, dass Sie Graphdatenbanken auf AWS, Azure und GCP implementieren können.
Während Neo4j etwas zusätzliche Arbeit erfordert, bietet AWS Amazon Neptune an, eine einsatzbereite Grapheninfrastruktur auf AWS. Eine weitere gute Graphenalternative ist Cayley, das Open Source ist und auf GCP nutzbar ist.
Welche anderen guten Graphenoptionen sind Ihnen schon aufgefallen? Bitte melden Sie sich und lassen Sie es uns wissen.
Zusätzliche Ressourcen
Für verwandte Lektüre entdecken Sie diese Ressourcen:
- BMC Big Data & Machine Learning Blog
- Data Visualization Guide, eine Tutorial-Reihe
- Tableau Online Guide, eine Tutorial-Reihe
- Data Lake vs Data Warehouse vs Datenbank erklärt
- DBMS: Eine Einführung in Datenbankmanagementsysteme

Leitfaden zur Datenvisualisierung
- Der Datenvisualisierungs-Anfängerleitfaden
- Einführung in Graphdatenbanken
- Anwendungsfälle für Graphdatenbanken
- Einführung in die Neo4j-Graphdatenbank
- Neo4j-Graphdatenbank-Abfragen
- Matplotlib-Streu- und Liniendiagramme erklärt
- Wie man Nebenhandlungen in Matplotlib hinzufügt
- Matplotlib-Logarithmische Skala
- Verwendung von Matplotlib zum Zeichnen von Diagrammen und Graphen
- Wie man 3D-Diagramme mit Matplotlib zeichnet
- Plotly Python Tutorial
- Ermöglichung der Bürgerdatenwissenschaftler
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.