




Auf einen Blick: Hadoop, ein bedeutendes Datenanalyse-Framework, steht in der Konkurrenz von Kubernetes und cloudnativen Technologien. Obwohl es bei der Verarbeitung großer Datensätze hervorragend ist, hat es Schwierigkeiten mit kleineren und es fehlt an Echtzeitanalysen. Der Artikel behandelt Hadoops Stärken, Schwächen und seine Relevanz in einer sich wandelnden Technologielandschaft.
- Hadoop verarbeitet große Datensätze effektiv, ist aber für kleinere ineffizient.
- Kubernetes bietet fortschrittliche Orchestrierung und Flexibilität für Datenlasten.
Apache Hadoop ist eine der führenden Lösungen für verteilte Datenanalyse und Datenspeicherung. Mit der Einführung weiterer verteilter Rechenlösungen, die direkt auf Datenanalyse und allgemeine Rechenbedürfnisse ausgerichtet sind, wurde jedoch die Nützlichkeit von Hadoop infrage gestellt.
Im Internet gibt es viele Debatten: Ist Hadoop noch relevant? Oder ist es ganz tot?
In Wirklichkeit ist Apache Hadoop nicht tot, und viele Organisationen nutzen es weiterhin als robuste Datenanalyselösung. Ein wichtiger Indikator ist, dass alle großen Cloud-Anbieter Apache Hadoop-Cluster auf ihren jeweiligen Plattformen aktiv unterstützen.
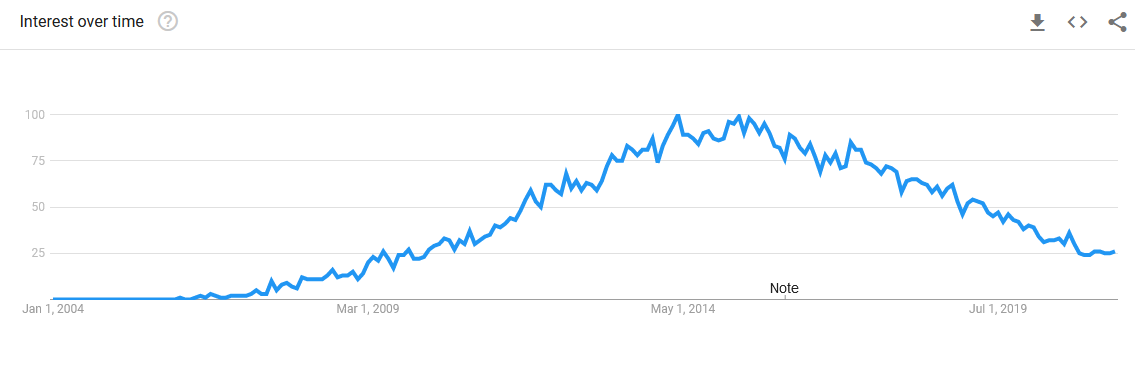
Google Trends zeigt, wie das Interesse an Hadoop von 2014 bis 2017 seinen Höhepunkt erreichte. Danach sehen wir einen deutlichen Rückgang der Suchanfragen nach Hadoop. Dies allein ist jedoch kein guter Maßstab für die Nutzung von Hadoop in der aktuellen Landschaft. Schließlich kann Hadoop in andere Plattformen integriert werden, um eine vollständige Analyselösung zu bilden.
In diesem Artikel erfahren wir mehr über Hadoop, seine Benutzerfreundlichkeit und ob es durch schnell entwickelnde Technologien wie Kubernetes und Cloud-Native-Entwicklung ersetzt wird.
Was ist Hadoop?
Hadoop ist ein Open-Source-Framework, das verwendet wird, um riesige Datensätze effizient zu speichern und zu verarbeiten. Es ist eine zuverlässige und skalierbare verteilte Rechenplattform, die auf Standardhardware verwendet werden kann.
Hadoop verteilt seine Datenspeicher- und Analyse-Workloads auf mehrere Knoten (Computer), um die Arbeit parallel zu erledigen. Dies führt zu schnelleren, hocheffizienten und kostengünstigen Datenanalysefunktionen.
Hadoop-Module
Hadoop besteht aus vier Hauptmodulen, die seine Funktionalität antreiben:
- HDFS. Das Hadoop Distributed File System ist ein Dateisystem, das auf günstiger Hardware laufen kann und dabei einen besseren Durchsatz als herkömmliche Dateisysteme bietet. Zusätzlich verfügt es über eine eingebaute Fehlertoleranz und die Fähigkeit, große Datensätze zu verarbeiten.
- GARN. "Yet Another Resource Negotiator" wird für das Aufgabenmanagement, die Planung von Jobs und das Ressourcenmanagement des Clusters verwendet.
- MapReduce. MapReduce ist eine Big-Data-Verarbeitungs-Engine, die die parallele Berechnung großer Datensätze unterstützt. Es ist die Standard-Verarbeitungs-Engine, die auf Hadoop verfügbar ist. Derzeit unterstützt Hadoop jedoch auch andere Engines wie Apache Tez und Apache Spark.
- Hadoop Common. Hadoop Common bietet einen gemeinsamen Satz von Bibliotheken, die über alle anderen Hadoop-Module hinweg verwendet werden können.
Hadoop-Vorteile
Schauen wir uns nun einige der Hauptgründe für die Beliebtheit von Apache Hadoop an.
- Rechenleistung. Hadoops verteiltes Rechenmodell ermöglicht es unbegrenzten, gleichzeitigen Aufgaben zu bewältigen.
- Datensicherheit. Hadoop erstellt und verwaltet automatisch Datensicherungen. Sie können Ihre Daten also im Falle eines Ausfalls einfach aus einem Backup wiederherstellen.
- Kosten. Die Fähigkeit von Hadoop, auf Standardhardware zu laufen, ermöglicht es Organisationen, eine Datenanalyseplattform einfach bereitzustellen. Außerdem entfällt der Bedarf an teurer und spezialisierter Hardware.
- Verfügbarkeit. Hadoop ist darauf ausgelegt, Fehler auf der Anwendungsebene zu bewältigen – das heißt, es bietet hohe Verfügbarkeit , ohne auf Hardware angewiesen zu sein.
Mit seiner Flexibilität und Skalierbarkeit gewann Hadoop schnell die Gunst sowohl einzelner Dateningenieure/-analysten als auch von Unternehmen. Diese Flexibilität erstreckt sich auch auf Datentypen, die Hadoop sammeln kann:
- Strukturiert und unstrukturiert
- Durch verschiedene Eingaben wie soziale Medien, gestreamte Daten, interne Sammlungen usw.
Dann überprüft Hadoop all diese Datensätze und bestimmt den Nutzen jedes einzelnen Datensatzes. All dies geschieht, ohne den Prozess der Umwandlung in ein einziges Format durchlaufen zu müssen.
Ein weiteres Merkmal, das Hadoop hervorhebt, ist die Speicherfähigkeit.
Sobald ein großer Datensatz angesammelt und die benötigten Daten extrahiert sind, können wir die unverarbeiteten Daten einfach endlos mit Hadoop speichern. Dadurch können Nutzer einfach auf ältere Daten zugreifen, und die Speicherkosten sind ebenfalls minimal, da Hadoop auf Standardhardware läuft.
Apache Spark

Nachteile von Hadoop
Apache Hadoop-Cluster gewannen dank all dieser Merkmale an Bedeutung.
Mit dem technologischen Fortschritt sind jedoch neue Optionen aufgetaucht, die Hadoop herausfordern und es in bestimmten Aspekten sogar übertreffen. Dies, zusammen mit den inhärenten Einschränkungen von Hadoop, bedeutet, dass es tatsächlich seine Marktführung verloren hat.
Was sind also einige Nachteile von Hadoop?
Ineffizient für kleine Datensätze
Hadoop ist für die Verarbeitung von Big Data konzipiert, die aus riesigen Datensätzen bestehen. Es ist sehr ineffizient, wenn kleinere Datensätze verarbeitet werden. Hadoop eignet sich nicht und ist unerschwinglich, wenn es um schnelle Analysen kleinerer Datensätze geht.
Ein weiterer Grund: Obwohl Hadoop Daten kombinieren, verarbeiten und transformieren kann, bietet es keine einfache Möglichkeit, die notwendigen Daten auszugeben . Dies schränkt die verfügbaren Möglichkeiten für Business-Intelligence-Teams zur Visualisierung und Meldung der verarbeiteten Datensätze ein.
Sicherheitsbedenken
Hadoop verfügt standardmäßig über eine lockere Sicherheitsdurchsetzung und implementiert keine Verschlüsselung auf Speicher- oder Netzwerkebene. Nur die Kerberos-Authentifizierung wird offiziell von Hadoop unterstützt, eine Technologie, die für sich genommen schwer zu warten ist.
In jeder Hadoop-Konfiguration müssen Nutzer Sicherheitsoptionen manuell aktivieren oder Drittanbieter-Tools nutzen, um sichere Cluster zu konfigurieren.
Mangelnde Benutzerfreundlichkeit
Hadoop wird mit Java entwickelt, einer der führenden Programmiersprachen mit einer großen Entwicklerbasis. Java ist jedoch nicht die beste Sprache für Datenanalyse und kann für neue Nutzer komplex sein.
Dies kann zu Komplikationen bei der Konfiguration und Nutzung führen – der Benutzer muss umfassende Kenntnisse sowohl in Java als auch in Hadoop besitzen, um den Cluster richtig zu nutzen und zu debuggen .
Nicht geeignet für Echtzeitanalysen
Hadoop ist mit hervorragender Unterstützung für Batch-Verarbeitung konzipiert. Aufgrund seiner Einschränkungen bei der Verarbeitung kleinerer Datensätze und der fehlenden nativen Unterstützung für Echtzeitanalysen ist Hadoop jedoch für schnelle Echtzeitanalysen ungeeignet.
Hadoop-Alternativen
Welche anderen Optionen stehen also für Hadoop zur Verfügung? Auch wenn es keine einheitliche Lösung gibt, um Hadoop vollständig zu ersetzen, gibt es neuere Technologien, die den Bedarf an Hadoop verringern oder eliminieren können.
Apache Spark ist eine Lösung, die vom Apache-Team selbst bereitgestellt wurde, um MapReduce, Hadoops Standard-Datenverarbeitungs-Engine, zu ersetzen. Spark ist die neue Datenverarbeitungs-Engine, die entwickelt wurde, um die Einschränkungen von MapReduce zu adressieren.
Apache behauptet, dass Spark fast 100-mal schneller als MapReduce ist und Berechnungen im Speicher unterstützt. Außerdem unterstützt es Echtzeitverarbeitung durch das Erstellen von Mikro-Chargen von Daten und deren Verarbeitung.
Die Unterstützung von Spark für moderne Sprachen ermöglicht es Ihnen, mit Ihren bevorzugten Programmiersprachen zu interagieren. Spark bietet ausgezeichnete Unterstützung für Datenanalysen in Sprachen wie:
- Scala
- Python
- Spark SQL
(Entdecken Sie unseren Apache Spark Guide.)
Apache Flink
Eine weitere verfügbare Lösung ist Apache Flink. Flink ist eine weitere Verarbeitungs-Engine mit denselben Vorteilen wie Spark. Flink bietet in einigen Workloads sogar eine höhere Leistung, da es für die Verarbeitung von zustandsbasierten Berechnungen über unbegrenzte und begrenzte Datenströme ausgelegt ist.
Werden Kubernetes und Cloud-native Hadoop ersetzen?
Selbst mit neueren und schnelleren Datenverarbeitungs-Engines beschränkt Hadoop die Nutzer weiterhin auf seine Tools und Technologien wie HDFS und YARN mit Java-basierten Tools. Aber was, wenn Sie andere Tools und Plattformen integrieren müssen, um das Beste für Ihre spezifischen Datenspeicher- und Analysebedürfnisse zu erhalten?
Die Lösung ist, Kubernetes als Orchestrierungs-Engine zu nutzen, um deinen Cluster zu verwalten.
Mit der stetig wachsenden Beliebtheit containerisierter cloudnativer Anwendungen ist Kubernetes zur führenden Orchestrierungsplattform zur Verwaltung jeder containerisierten Anwendung geworden. Es bietet Funktionen wie:
- Bequeme Verwaltung
- Netzwerke
- Skalierung
- Hohe Verfügbarkeit
(Entdecken Sie unseren umfassenden Kubernetes-Leitfaden.)
Betrachten Sie folgendes Szenario: Sie möchten auf günstige Cloud-Speicheroptionen wie Amazon S3 Buckets und verwaltete Data Warehouses wie Amazon Redshift, Google BigQuery, Panoply umsteigen. Das ist mit Hadoop nicht möglich.
Kubernetes hingegen kann sie problemlos in Kubernetes-Cluster einbinden, auf die die Container zugreifen können. Ebenso verfügen Kubernetes-Cluster über unbegrenzten Speicher mit reduzierten Wartungsaufgaben, da Cloud-Anbieter die tägliche Wartung und Verfügbarkeit der Daten verwalten.
Nachdem der Speicher sortiert ist, kann Kubernetes verschiedene Dienste hosten, wie zum Beispiel:
- Big-Data-Analysetools (Apache Spark, Presto, Flink)
- Data-Science-Tools (BigML, Jupyter, NLTK, TensorFlow, PyTorch, MATLAB)
- Jedes andere Tool innerhalb eines Kubernetes-Clusters
Das gibt dir die Freiheit, alle Werkzeuge, Frameworks oder Programmiersprachen zu verwenden, mit denen du bereits vertraut bist oder die für deinen Anwendungsfall am besten geeignet ist – du bist nicht mehr auf Java beschränkt.
(Siehe genau, wie Container und K8s zusammenarbeiten.)
Portabilität von Kubernetes
Ein weiterer Faktor, der Kubernetes aufwertet, ist seine Portabilität. Kubernetes lässt sich leicht so konfigurieren, dass es über viele Standorte verteilt und in mehreren Cloud-Umgebungen ausgeführt werden kann. Mit containerisierten Anwendungen können Nutzer problemlos zwischen Entwicklungs- und Produktionsumgebungen wechseln, um Datenanalysen an jedem Ort ohne größere Änderungen zu ermöglichen.
Durch die Kombination von Kubernetes mit schnellen DevOps- und CI/CD-Pipelines können Entwickler praktisch überall Datenanalyse-, ML- und KI-Anwendungen erstellen, testen und bereitstellen.
Unterstützung von Kubernetes für serverloses Rechnen
Kubernetes hat zudem die Notwendigkeit, Infrastrukturen separat zu verwalten, durch die Unterstützung für serverloses Rechnen überflüssig gemacht. Serverloses Rechnen ist eine aufstrebende Technologie, bei der die Cloud-Plattform die Hardwareressourcen automatisch verwaltet und skaliert, entsprechend den Anforderungen der Anwendung.
Einige container-native, Open-Source- und Function-as-a-Service-Computing-Plattformen wie fn, Apache OpenWhisk und nuclio lassen sich problemlos mit Kubernetes integrieren, um serverlose Anwendungen auszuführen – wodurch Technologien wie Hadoop überflüssig werden.
Einige Frameworks, wie Nuclio, sind speziell darauf ausgerichtet, Data-Science-Pipelines mit serverlosen Funktionen zu automatisieren.
Mit all den oben genannten Vorteilen wird Kubernetes allmählich zur perfekten Wahl für die Verwaltung von Big-Data-Workloads.
Hadoop verarbeitet große Datensätze kostengünstig
Wie jede andere Technologie ist Hadoop auch darauf ausgelegt, einen spezifischen Bedarf zu erfüllen – also große Datensätze effizient mit Standardhardware zu verarbeiten.
Allerdings haben sich sich entwickelnde Technologietrends zu neuen Anforderungen und Anwendungsfällen geführt. Hadoop ist nicht tot, aber andere Technologien wie Kubernetes und serverloses Rechnen bieten viel flexiblere und effizientere Optionen.
Wie bei jeder Technologie liegt es also an Ihnen, den richtigen Technologie-Stack für Ihre Bedürfnisse zu identifizieren und zu nutzen.
Verwandte Literatur
Hadoop-Leitfaden
- Hadoop-Tutorial für Anfänger: Hadoop-Basics
- Eine Einführung in die Hadoop-Verwaltung
- Einführung in die Hadoop-Sicherheit
- Einführung in den Apache Flume
- Eine Einführung in Hive
- Eine Einführung in HDFS
- Einführung in Hbase
- Hadoop-Beispiele: 5 reale Anwendungsfälle
- Hadoop-Karrieren: Einstellung
- Hadoop-Interviewfragen
- Eine Einführung in die Hadoop-Analyse
- Einführung in Apache Pig
- Eine Einführung in Apache-Garn
- Eine Einführung in die Hadoop-Architektur
- Vorteile und Vorteile von Hadoop
- Hadoop mit Apache Cassandra verwenden
- Hadoop vs Kubernetes: Werden K8s & Cloud Native Hadoop beenden?
- Hadoop-Zertifizierungen
- Hadoop-Cluster: Eine Einführung
- Hadoop-Ökosystem und Komponenten
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.