




Auf einen Blick: K-means Clustering mit Apache Spark analysiert Kriminalstatistiken, um gefährliche Bundesstaaten in den USA zu identifizieren. Das Tutorial behandelt Datenvorbereitung, Clustering-Implementierung und Ergebnisvisualisierung mittels SQL-Abfragen in einem Zeppelin-Notizbuch.
- Nutzt Kriminalitätsdaten für die Analyse von Clustering.
- Beinhaltet Scala-Code für Datenverarbeitung und Modelltraining.
Hier zeigen wir ein einfaches Beispiel, wie man k-means-Clustering verwendet. Wir betrachten Kriminalstatistiken aus verschiedenen US-Bundesstaaten, um zu zeigen, welche am gefährlichsten und am wenigsten gefährlich sind. Unsere Daten beziehen wir hier. Die Daten sehen so aus. Die Spalten sind Bundesstaat, Cluster, Mordrate, Körperverletzung, Bevölkerung und Vergewaltigung. Sie enthält bereits eine Cluster-Spalte, die wir entfernen werden. Das liegt daran, dass man Datenpunkte in so viele Cluster gruppieren kann, wie man möchte. Dieser Datensatz verwendete einen anderen Wert. Beachten Sie auch, dass die Population ein normalisierter Wert ist, das heißt, es ist nicht die tatsächliche Population. Das macht es zu einer kleinen Zahl, was ein gängiger Ansatz für Statistiken ist. Löschen Sie die Spaltenüberschriften, um die Daten einzulesen. Später setzen wir sie wieder ein.
| Crime$Cluster | Mord | Angriff | UrbanPop | Vergewaltigung | |
|---|---|---|---|---|---|
| Alabama | 4 | 13.2 | 236 | 58 | 21.2 |
| Alaska | 4 | 10 | 263 | 48 | 44.5 |
| Arizona | 4 | 8.1 | 294 | 80 | 31 |
| Arkansas | 3 | 8.8 | 190 | 50 | 19.5 |
| Kalifornien | 4 | 9 | 276 | 91 | 40.6 |
| Colorado | 3 | 7.9 | 204 | 78 | 38.7 |
Unten ist der Scala-Code. Wir fügen ihn in ein Zeppelin-Notizbuch ein, da das Graphen gut macht. (Über die Nutzung von Zeppelin mit Apache Spark können Sie in einem früheren Beitrag hier lesen.) Zuerst haben wir unsere normalen Importe:
    import org.apache.spark.mllib.clustering.{KMeans, KMeansModel}
import org.apache.spark.mllib.linalg.Vectors
import sqlContext.implicits._
import org.apache.spark.sql.types._
Dann erstellen wir die Verbrechensdaten-RDD aus der crime_data.csv-Datei, die wir nach Hadoop kopiert haben.
var rdd = sc.textFile("hdfs://localhost:9000/data/crime_data.csv")
Jetzt müssen Daten, die an einen Machine-Learning-Algorithmus gesendet werden, Zahlen sein. Dieser Algorithmus wandelt also eine Zeichenkette in Bytes und dann in ein Double um. Dann schleifen wir über jede Bytegruppe und summieren sie, um eine einzige Gesamtzahl zu ergeben, die der codierte Wert des Textfeldzustands ist.
    def stoDouble (s : String): Double = {
return s.map(_.toByte.doubleValue()).reduceLeft( (x,y) => x + y)
}
Wir müssen diese Zahl natürlich wieder in Text übersetzen, damit wir sehen können, mit welchem Zustand wir es zu tun haben. Wir erstellen also eine Fallklasse. Das macht man, wenn man einen Dataframe erstellen möchte. Man erstellt einen Dataframe, wenn man SQL verwenden möchte, was einfach zu handhaben ist.
    case class StateCode(State:String, Code:Double)
var lines = rdd.map(l => l.split(","))
var states = lines.map(l => StateCode(l(0),stoDouble(l(0)))).toDF()
states.show()
states.createOrReplaceTempView("states")
Hier nehmen wir jede Zeile der Eingabedatei und machen sie zu einem Array von Doppelgängern.
    def makeDouble (s: String): Array[Double] = {
var str = s.split(",")
var a = stoDouble(str(0))
return Array(a,str(2).toDouble,str(3).toDouble,str(4).
toDouble,str(5).toDouble)
}
var crime = rdd.map(m => makeDouble(m))
Jetzt erstellen wir ein Objekt namens Dense Vector. Der Spark k-means Klassifikationsalgorithmus benötigt dieses Format. Dann führen wir die Train-Methode aus, damit der Machine-Learning-Algorithmus die Bundesstaaten basierend auf Kriminalitätsraten und Bevölkerung in Cluster gruppiert. Wir sagen ihm, er soll fünf Cluster verwenden. Wir hätten 10 oder jede beliebige Zahl sagen können. Je größer die Anzahl der Cluster, desto mehr haben Sie Ihre Daten geteilt.
    val crimeVector = crime.map(a => Vectors.dense(a(0),a(1),a(2),a(3),a(4)))
val clusters = KMeans.train(crimeVector,5,10)
Jetzt erstellen wir eine weitere Fallklasse, sodass die Endergebnisse in einem Datenrahmen mit Namen und Spalten liegen. Hier haben wir alle Daten plus das Dense-Vector-Objekt sowie die Vorhersage, die Spark basierend auf dem k-means-Algorithmus treffen wird. Ein wichtiger Punkt ist, dass Spark kein Problem damit hat, einen dichten Vektor als SQL-Spalte zu machen. Beachte, dass der Clusterwert aus dem Trainingsset zur Vorhersage verwendet wird. Wir fügen das auch der Crime-Fallklasse hinzu.
    case class Crime (Code:Double, Murder:Double, Assault:Double, UrbanPop:Double,Rape:Double, PredictionVector:org.apache.spark.mllib.linalg.Vector, Prediction:Double)
val crimeClass = crimeVector.map(a => Crime(a(0), a(1), a(2), a(3), a(4), a ,clusters.predict(a))).toDF()
crimeClass.show()
crimeClass.createOrReplaceTempView("crimes")
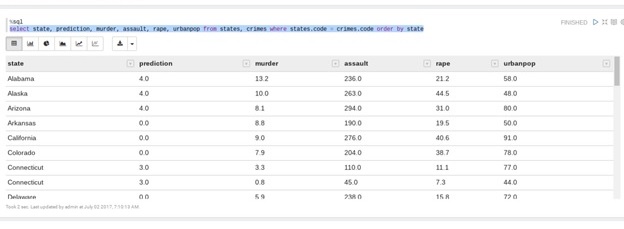
Schließlich müssen wir die beiden Tabellen mit Zustand und Vorhersage verbinden, weil wir den Zustandsnamen anzeigen wollen und nicht die Zahl, in die wir ihn umgewandelt haben. Beachten Sie die %sql-Zeile. In einem Zeppelin-Notizbuch bedeutet das, dass wir SQL verwenden wollen. Das können wir, weil wir in crimeClass.createOrReplaceTempView("crimes") eine temporäre Ansicht erstellt haben, die wir mit SQL abfragen können. Wenn Sie %sql verwenden, gibt Zeppelin Ihnen automatisch die Möglichkeit, verschiedene Graphen zu erstellen.
    %sql
select state, prediction, murder, assault, rape, urbanpop from states, crimes where states.code = crimes.code order by state
Hier geben wir die Option als Tabelle aus. Wir hätten ein Tortendiagramm, ein Balkendiagramm oder Ähnliches erstellen können. Wie Sie sehen, halten Sie sich von Alabama fern, da es gefährlicher ist als zum Beispiel Colorado.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.