




Auf einen Blick: Top-Machine-Learning-Frameworks wie TensorFlow, PyTorch, Keras und scikit-learn erleichtern die Modellentwicklung, indem sie komplexe Algorithmen vereinfachen. Sie bedienen verschiedene Bedürfnisse im Bereich Machine Learning und Deep Learning und bieten unverzichtbare Werkzeuge für Data Scientists.
- TensorFlow und PyTorch sind führende Wettbewerber mit umfangreichen Fähigkeiten.
- Keras vereinfacht die Modellierung neuronaler Netzwerke, während scikit-learn ideal für schnelle Prototypenbildung ist.
Es gibt viele Machine-Learning-Frameworks . Da jedes Zeit zum Lernen braucht und einige eine größere Nutzerbasis haben als andere, welches sollte man verwenden?
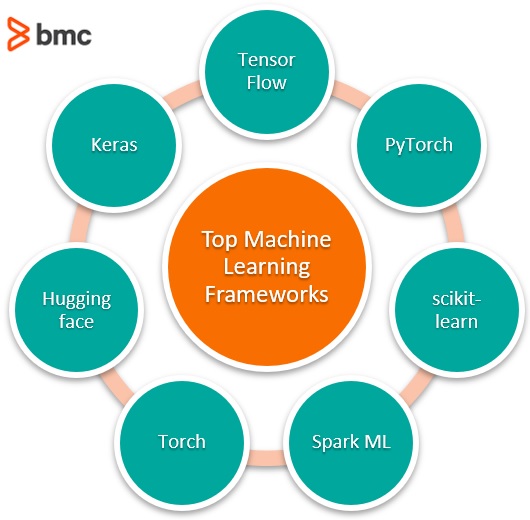
In diesem Artikel werfen wir einen übergeordneten Blick auf die wichtigsten ML-Frameworks – und einige neuere auf der Bühne:
TensorFlow
PyTorch
scikit-Learn
Spark ML
Torch
Keras
Was ist ein ML-Framework?
Maschinelles Lernen basiert auf Algorithmen. Es sei denn, man ist Data Scientist oder ML-Experte, sind diese Algorithmen sehr kompliziert zu verstehen und zu handhaben.
Ein maschinelles Lern-Framework vereinfacht also maschinelle Lernalgorithmen. Ein ML-Framework ist jedes Werkzeug, jede Schnittstelle oder jede Bibliothek, die es ermöglicht, ML-Modelle einfach zu entwickeln, ohne die zugrunde liegenden Algorithmen zu verstehen.
Es gibt eine Vielzahl von Machine-Learning-Frameworks, die auf unterschiedliche Zwecke ausgerichtet sind. Fast alle ML-Frameworks – die wir hier besprechen und die nicht, sind in Python geschrieben. Python ist die vorherrschende Programmiersprache für maschinelles Lernen.
Auswahl Ihres ML-Tools
Bei der Auswahl eines Werkzeugs müssen Sie sich fragen: Ihr Ziel: maschinelles Lernen oder Deep Learning? Deep Learning bedeutet mittlerweile, neuronale Netze zu nutzen, um viele Aufgaben zur Datenanalyse auszuführen:
- Bilddaten
- Sprachdaten
- Große Mengen an nummerierten und kategorialen Daten
Mit den Daten ist es möglich:
- Erstellen Sie Gesichtserkennungsmodelle
- Bilder manipulieren, wie bei Deepfakes
- Generiere vollständige, nahezu kohärente Artikel zu einem gegebenen Thema
- Prognostizieren Sie routinemäßige Verhaltenshandlungen, zum Beispiel wenn jemand möglicherweise die Mitgliedschaft im Fitnessstudio kündigt
- Biete Empfehlungen an, vorausgesetzt, du magst ein Restaurant/Film/Produkt, hier ist ein weiteres, das dir wahrscheinlich gefallen wird
Maschinelles Lernen hingegen basiert auf Algorithmen, die auf Mathematik und Statistik basieren – nicht auf neuronalen Netzen –, um Muster zu finden. Die meisten Tutorials, Anwendungsfälle und das Engineering in den neueren ML-Frameworks zielen darauf ab, ein Framework zu entwickeln, das sich in der schnellsten Zeit auf Bilddatenbanken oder Textgenerierung oder -klassifikation trainiert, mit möglichst wenig Speicher und sowohl auf GPUs als auch auf CPUs läuft.
Warum nicht nur eine übergeordnete API für alle ML-Aufgaben bereitstellen? Sagen wir eine Bildklassifikations-API und Data Scientists einfach Bilddatenbanken in diese einfügen? Oder das als Webservice bereitstellen, ähnlich wie Googles Webservice für natürliche Sprachen.
Das liegt daran, dass Data Scientists an mehr als nur der Handschrifterkennung interessiert sind, nur um der Handschrifterkennung willen. Data Scientists interessieren sich für Werkzeuge, die Probleme lösen, die geschäftlich relevant sind, wie lineare und logistische Regression, k-Mean-Clustering und, ja, neuronale Netze. Im Jahr 2020 gibt es viele Optionen für diese Werkzeuge.
Beliebte Machine-Learning-Frameworks
Man könnte argumentieren, dass TensorFlow, PyTorch und scikit-learn die beliebtesten ML-Frameworks sind. Dennoch hängt die Wahl des verwendeten Frameworks von der Arbeit ab, die man ausführen möchte. Diese Frameworks sind auf Mathematik und statistische Modellierung (maschinelles Lernen) ausgerichtet, im Gegensatz zum Training neuronaler Netze (Deep Learning).
Hier ist eine kurze Übersicht dieser beliebten ML-Frameworks:
- TensorFlow und PyTorch sind direkte Konkurrenten aufgrund ihrer Ähnlichkeit. Beide bieten eine reiche Auswahl an Werkzeugen der linearen Algebra und können Regressionsanalysen durchführen.
- Scikit-Learn gibt es schon lange und ist R-Programmierern am vertrautsten, aber es gibt einen großen Vorbehalt: Es ist nicht dafür ausgelegt, über einen Cluster hinweg zu laufen.
- Spark ML ist dafür gebaut, auf einem Cluster zu laufen, denn genau darum geht es bei Apache Spark.
Schauen wir uns nun einige konkrete Rahmenwerke an.
TensorFlow
TensorFlow wurde bei Google Brain entwickelt und anschließend zu einem Open-Source-Projekt gemacht. TensorFlow kann:
- Führe Regressionen, Klassifikationen, neuronale Netze usw. durch.
- Läuft sowohl auf CPUs als auch auf GPUs
TensorFlow gehört heute zu den de-facto-Frameworks für maschinelles Lernen und ist kostenlos. (Google glaubt, die Bibliothek könne kostenlos sein, aber ML-Modelle benötigen erhebliche Ressourcen für Produktionszwecke, daher nutzen sie den Verkauf der Ressourcen, um ihre Werkzeuge auszuführen.)
TensorFlow ist ein vollwertiges ML-Forschungs- und Produktionstool. Es kann sehr komplex sein – muss es aber nicht sein. Wie eine Excel-Tabelle kann TensorFlow einfach oder professioneller verwendet werden:
- TF ist einfach genug für den einfachen Nutzer, der eine Vorhersage für einen gegebenen Datensatz zurückgeben möchte
- TF kann auch für fortgeschrittene Nutzer funktionieren, die mehrere Datenpipelines einrichten, die Daten an ihr Modell anpassen, alle Ebenen und Parameter ihres Modells anpassen und auf mehreren Maschinen trainieren möchten, während die Privatsphäre des Benutzers gewahrt bleibt.
TF erfordert ein tiefgehendes Verständnis von NumPy-Arrays. TensorFlow besteht aus Tensoren. Es ist eine Möglichkeit, Tensoren zu verarbeiten; daher das NumPy-Tool von Python. NumPy ist ein Python-Framework zur Arbeit mit n-dimensionalen Arrays (ein eindimensionales Array ist ein Vektor. Ein zweidimensionales Array ist eine Matrix und so weiter.) Anstatt Arrays automatisch in One-Hot-Vektoren umzuwandeln (eine True-False-Darstellung), wird erwartet, dass diese Aufgabe vom Data Scientist übernommen wird.
Aber TensorFlow verfügt über eine umfangreiche Auswahl an Werkzeugen. Zum Beispiel können die Aktivierungsfunktionen für neuronale Netze die ganze harte Arbeit der Statistik übernehmen. Wenn wir Deep Learning als die Fähigkeit definieren, neuronale Netze zu erstellen, dann übernimmt TensorFlow das. Aber es kann auch alltäglichere Probleme wie Regression behandeln.
Ein einfaches TF-ML-Modell sieht so aus:
    import tensorflow as tf
mnist = tf.keras.datasets.mnist
    (x_train, y_train),(x_test, y_test) = mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

model = tf.keras.models.Sequential([
  tf.keras.layers.Flatten(input_shape=(28, 28)),
  tf.keras.layers.Dense(128, activation='relu'),
  tf.keras.layers.Dropout(0.2),
  tf.keras.layers.Dense(10, activation='softmax')
])
    model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

model.fit(x_train, y_train, epochs=5)
model.evaluate(x_test, y_test)
Ein einfaches Modell und ein fortschrittlicheres Modell sind hier zu sehen.
PyTorch
PyTorch wurde von FAIR, Facebook AI Research, entwickelt . Anfang 2018 fusionierte das FAIR-Team Caffe2, ein weiteres ML-Framework, mit PyTorch. Es ist der führende Konkurrent zu TensorFlow. Wenn Ingenieure sich entscheiden, eine ML-Plattform zu verwenden, läuft ihre Entscheidung meist auf die Frage hinaus: "Verwenden wir TensorFlow oder PyTorch?" Beide erfüllen ihre Zwecke, sind aber ziemlich austauschbar.
Wie TensorFlow, PyTorch:
- Gibt es Regression, Klassifikation, neuronale Netze usw.
- Läuft sowohl auf CPUs als auch auf GPUs.
PyTorch gilt als eher pythonisch. Während TensorFlow ein Modell schneller und mit etwas Anpassung zum Laufen bringen kann, gilt PyTorch als anpassbarer und folgt einem traditionelleren objektorientierten Programmierungsansatz durch das Erstellen von Klassen.
Es wird gezeigt, dass PyTorch schnellere Trainingszeiten hat. Diese Geschwindigkeit ist für viele Nutzer marginal, kann aber bei großen Projekten einen Unterschied machen. PyTorch und TensorFlow befinden sich beide in aktiver Entwicklung, daher schwankt der Geschwindigkeitsvergleich wahrscheinlich zwischen den beiden hin und her.
Im Vergleich zu Torch verwendet PyTorch Python und benötigt weder Lua noch den Lua Package Manager.
Von Asad Mahmood sieht ein PyTorch-Modell so aus:
    import torch
from torch.autograd import Variableclass linearRegression(torch.nn.Module):
    def __init__(self, inputSize, outputSize):
        super(linearRegression, self).__init__()
        self.linear = torch.nn.Linear(inputSize, outputSize)

    def forward(self, x):
        out = self.linear(x)
        return out
    inputDim = 1 # takes variable 'x'
outputDim = 1 # takes variable 'y'
learningRate = 0.01
epochs = 100

model = linearRegression(inputDim, outputDim)
##### For GPU #######
if torch.cuda.is_available():
model.cuda()
    criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learningRate)
    for epoch in range(epochs):
   # Converting inputs and labels to Variable
   if torch.cuda.is_available():
       inputs = Variable(torch.from_numpy(x_train).cuda())
       labels = Variable(torch.from_numpy(y_train).cuda())
   else:
       inputs = Variable(torch.from_numpy(x_train))
       labels = Variable(torch.from_numpy(y_train))

   # Clear gradient buffers because we don't want any gradient from previous epoch to carry forward, dont want to cummulate gradients
   optimizer.zero_grad()
    # get output from the model, given the inputs
   outputs = model(inputs)

   # get loss for the predicted output
   loss = criterion(outputs, labels)
   print(loss)
   # get gradients w.r.t to parameters
   loss.backward()

   # update parameters
   optimizer.step()

   print('epoch {}, loss {}'.format(epoch, loss.item()))
scikit-Learn
Manchmal ist nur ein schneller Test nötig, um den wahrscheinlichen Erfolg einer Hypothese zu messen. Scikit-Learn ist ein alter Standard der Data-Science-Welt, und es kann sinnvoll sein, schnelle ML-Modellskizzen durchzuführen, um zu sehen, ob ein Modell interpretierbar ist.
Scikit ist ein weiteres Python-Paket, das viele nützliche Machine-Learning-Aufgaben ausführen kann:
- Lineare Regression
- Entscheidungsbaum-Regressionen
- Random Forest-Regressionen
- K-Nächster Nachbar
- SVMs
- Stochastische Gradientenabstiegsmodelle
- Und mehr
Scikit bietet Modellanalysetools wie die Confusion Matrix , um zu bewerten, wie gut ein Modell abgeschnitten hat. Oft kann man einen ML-Job in scikit-learn starten und dann zu einem anderen Framework wechseln. Zum Beispiel bietet scikit-learn ausgezeichnete Daten-Vorverarbeitungstools für One-Hot-Encoding-Kategorien-Daten. Sobald die Daten durch Scikit vorverarbeitet wurden, können Sie sie in TensorFlow oder PyTorch übertragen.
    from sklearn import linear_model

regr = linear_model.LinearRegression()
regr.fit(diabetes_X_train, diabetes_y_train)
print(regr.coef_)
Wir haben ausführlich darüber geschrieben , wie man Spark ML verwendet. Wie bereits beschrieben, kann Spark ML in Clustern laufen. Mit anderen Worten: Es kann wirklich große Matrixmultiplikationen bewältigen, indem Schnitte der Matrix genommen und diese Berechnung auf verschiedenen Servern ausgeführt werden. (Matrixmultiplikation ist eine der wichtigsten ML-Operationen.) Das erfordert eine verteilte Architektur, damit Ihr Computer nicht zu lange Speicher ausgeht oder zu lange arbeitet, wenn er mit großen Datenmengen arbeitet.
Spark ML ist kompliziert, aber anstatt mit NumPy-Arrays arbeiten zu müssen, kann man mit Spark RDD-Datenstrukturen arbeiten, was jeder, der Spark in seiner Big-Data-Rolle nutzt, verstehen wird. Und man kann Spark ML nutzen, um mit Spark SQL-Dataframes zu arbeiten, was die meisten Python-Programmierer kennen. Es erstellt also dichte und Spark-Feature-Label-Vektoren für Sie, wodurch etwas Komplexität bei der Datenvorbereitung für die ML-Algorithmen entfällt.
Im Januar 2019 veröffentlichte Yahoo TensorFlowOnSpark, eine Bibliothek, die "wichtige Funktionen des TensorFlow Deep Learning Frameworks mit Apache Spark und Apache Hadoop kombiniert. TensorFlowOnSpark ermöglicht verteiltes Deep Learning auf einem Cluster von GPU- und CPU-Servern." Das Paket integriert Big Data und maschinelles Lernen in ein brauchbares ML-Tool für große Produktionsanwendungen.
Das Spark ML-Modell, geschrieben in Scala oder Java, ähnelt dem TensorFlow-Code, da es deklarativer ist:
    // Build the model with the desired layers
val training = sparkContext.parallelize(Seq(
  LabeledPoint(1.0, Vectors.dense(0.0, 1.1, 0.1)),
  LabeledPoint(0.0, Vectors.dense(2.0, 1.0, -1.0)),
  LabeledPoint(0.0, Vectors.dense(2.0, 1.3, 1.0)),
  LabeledPoint(1.0, Vectors.dense(0.0, 1.2, -0.5))))
val lr = new LogisticRegression()
    // We may set parameters using setter methods.
lr.setMaxIter(10)
  .setRegParam(0.01)
    // Train a LogisticRegression model.  This uses the parameters stored in lr.
val model1 = lr.fit(training)
Torch
Torch behauptet, das einfachste ML-Framework zu sein. Es handelt sich um eine alte Machine-Learning-Bibliothek, die erstmals 2002 veröffentlicht wurde.
Früher war Python mit PyTorch die gewählte Methode, um auf die grundlegenden Tabellen zuzugreifen, in denen Torch seine Berechnungen durchführt. Torch selbst kann mit Lua verwendet werden, mit dem LuaRocks Package Manager. Torchs relative Einfachheit beruht auf seiner Lua-Programmiersprachenoberfläche (Es gibt andere Schnittstellen wie QT und iPython/Jupyter, und es hat eine C-Implementierung). Lua ist tatsächlich einfach. Es gibt keine Floats oder Ganzzahlen, nur Zahlen. Und alle Objekte in Lua sind Tabellen. Es ist also einfach, Datenstrukturen zu erstellen. Und es bietet eine reiche Auswahl leicht verständlicher Funktionen, um Tabellen zu slicen und hinzuzufügen.
Wie bei TensorFlow ist das grundlegende Datenelement in Torch der Tensor. Man erstellt einen, indem man Torch schreibt. Tensor. Die CLI (Kommandozeilen-Schnittstelle) bietet Inline-Hilfe und hilft bei Einzügen. Leute, die Python benutzt haben, werden erleichtert sein, denn das bedeutet, dass man Funktionen in situ eingeben kann, ohne bei einem Fehler von vorne anfangen zu müssen. Und für diejenigen, die Komplexität und spärlichen Code mögen, unterstützt Torch funktionale Programmierung.
Neue ML-Framework-Typen
Die Welt des maschinellen Lernens ist reich an Bibliotheken. Es gibt hochrangige Bibliotheken, die einige der zuvor genannten Bibliotheken als Basis nutzen, um maschinelles Lernen für den Data Scientists zu erleichtern.
huggingface.co
Eine der führenden Machine-Learning-Bibliotheken ist huggingface.co, die gute Basismodelle für Forscher auf Basis von TensorFlow und PyTorch erstellt. Sie passen komplexe Werkzeuge wie GPT-2 an, um einfach auf Ihrem Rechner zu arbeiten.
Keras ist eine neuronale Netzwerkbibliothek, die auf TensorFlow aufbaut, um die ML-Modellierung einfach zu machen. Es vereinfacht einige der Codierungsschritte, wie zum Beispiel das Angebot von All-in-One-Modellen; Keras kann denselben Code auch verwenden, um auf einer CPU oder GPU zu laufen.
Keras ist nicht auf TensorFlow beschränkt, wird aber dort am häufigsten verwendet. Du kannst Keras auch mit TensorFlow verwenden:
- Microsoft Cognitive Toolkit (CNTK)
- R
- Theano
- PlaidML
Zusätzliche Ressourcen
Mehr zum Thema maschinelles Lernen finden Sie im BMC Machine Learning & Big Data Blog sowie in diesen Ressourcen:
- Ermöglichung der Bürgerdatenwissenschaftler
- 3 Schlüssel zum Aufbau widerstandsfähiger Datenpipelines
- 5 Stämme des maschinellen Lernens
- Maschinelles Lernen mit TensorFlow & Keras, einem mehrteiligen Leitfaden
- Sci-Kit lern Leitfaden
- Apache Spark Leitfaden
- O'Reillys praktisches maschinelles Lernen mit Scikit-Learn, Keras und TensorFlow (für diejenigen, die etwas altmodisches Buchlernen bevorzugen)
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.