




Auf einen Blick: Der Einsatz von maschinellem Lernen verbessert die Cybersicherheit, indem die Analyse des Netzwerkverkehrs verbessert wird, insbesondere durch Techniken wie k-means Clustering, das Ausreißer in Router-Logs für eine bessere Bedrohungserkennung identifiziert.
- Maschinelles Lernen filtert Rauschen in Netzwerkverkehrsdaten.
- K-bedeutet Clustering Gruppierung von Verkehrsdaten für eine effektivere Analyse.
In diesem Artikel zeigen wir, wie maschinelles Lernen auf Cybersicherheit angewendet werden kann. Es gibt mehrere Anwendungsfälle, aber dieser Artikel konzentriert sich auf die Analyse von Router-Logs.
Warum maschinelles Lernen mit Cybersicherheit einsetzen
Es ist fast unmöglich für einen Analysten, der sich ein Zeitreihendiagramm des Netzwerkverkehrs ansieht, aus dem, was er betrachtet, eine Schlussfolgerung zu ziehen. Warum? Menschen können nicht mehr als drei Dimensionen sehen. Und zu viele Fehlalarme führen dazu, dass Analysten einfach einige der Beobachtungen ignorieren – zu viel Rauschen.
Aber maschinelles Lernen ermöglicht es, zum Beispiel kriminelle Hacker zu entlarven, die Daten aus Ihrem System stehlen und an ihr Kommando- und Kontrollzentrum weiterleiten. Das ist es, was Eindringerkennungssysteme tun sollen, aber Hacker nutzen alle möglichen Techniken, um der Entdeckung durch traditionelle Cybersicherheitssysteme zu entgehen. Sie könnten beispielsweise gestohlene Daten in kleinen Teilen übertragen und jede an eine andere IP-Adresse senden, wie etwa an gekaperte Heimcomputer, und diese dann nutzen, um diese Teile an ihr Hacker-Kommando- und Kontrollzentrum zu senden.
[Helix-Video]
Maschinelles Lernen hilft uns, Dutzende oder Hunderte von Datenpunkten in ein oder zwei Metriken zu destillieren. Dann können wir unsere Diagramme und Warnungen darauf aufbauen. Diese Warnungen sind jetzt deutlich wertvoller.
In diesem Beispiel zeigen wir einen Ansatz zur Betrachtung des Netzwerkverkehrs. Wir verwenden Router-Logs, die von Verizon vom Bro-Typ Router bereitgestellt werden. Wir gruppieren jeden Datensatz in einen von sieben Clustern und betrachten dann den Verkehr in diesen Clustern mit der geringeren Anzahl an Einträgen. Das sind per Definition unsere Ausreißer.
K-bedeutet Clustering
Wir verwenden den k-mean-Clustering-Algorithmus , der Daten entlang beliebiger Achsen trennt. (Weitere Informationen finden Sie unter k-means clustering mit Apache Spark und Python Spark ML K-Means Beispielen<)
Ein Data Scientist würde sagen, dass wir eine Hyperebene in einen n-dimensionalen Raum zwischen den Datenpunkten führen. Da wir das nicht visualisieren können, stellen wir uns einen 3D-Raum vor, dann fädeln wir ein Blatt Papier zwischen jeden Datensatz hinein, sodass Punkte in einer Gruppe auf der einen Seite des Papiers und Punkte in der anderen Gruppe auf der anderen Seite liegen.
Dies ist ein unüberwachtes Modell , weil es keine Labels gibt, sondern nur Merkmale. Wir müssen das Modell also nicht trainieren, da es nichts vorhersagen gibt. Stattdessen beobachten wir.
Der Code, erklärt
Der Code ist hier verfügbar, und die Daten hier. Dies sind Daten von einem Netzwerkanalysetool namens Zeek, früher Bro genannt.
Die University of Cincinnati liefert folgende Beschreibung der Spalten in diesen Daten:
- ts—zeit; Zeitstempel
- uid—String; eindeutige ID der Verbindung
- orig_h—addr; IP-Adresse des ursprünglichen Endpunkts (auch bekannt als ORIG)
- orig_p—Port; TCP/UDP-Port oder ICMP-Code des ursprünglichen Endpunkts
- resp_h—addr; IP-Adresse des antwortenden Endpunkts (auch RESP genannt)
- resp_p—Port; der TCP/UDP-Port oder ICMP-Code des antwortenden Endpunkts
- proto—transport_protoTransport Schichtprotokoll der Verbindung
- Service—String; dynamisch erkanntes Anwendungsprotokoll, falls vorhanden
- Dauer – Intervall; Zeit des letzten gesehenen Pakets zur Zeit des ersten sichtbaren Pakets
- orig_bytes—Zählung; Originator-Payload-Bytes, aus Sequenznummern, falls TCP
- resp_bytes—Zählung; Responder-Payload-Bytes, aus Sequenznummern, falls TCP
- conn_state—String; Verbindungszustand (siehe conn.log:conn_state Tabelle)
- local_orig—bool; wenn conn lokal T entstand; wenn entfernt F. Wenn Site::local_nets leer, immer ungesetzt
- missed_bytes—Zählung; Anzahl fehlender Bytes in Inhaltslücken
- Geschichte—String; Verbindungszustandsgeschichte (siehe conn.log:History-Tabelle)
- orig_pkts—Zählen; Anzahl der ORIG-Pakete
- orig_ip_bytes—Zählung; Anzahl der ORIG-IP-Bytes (über IP-total_length Headerfeld)
- resp_pkts—Zählung; Anzahl der RESP-Pakete
- resp_ip_bytes – Anzahl; Anzahl der RESP-IP-Bytes (über IP-total_length Headerfeld)
- tunnel_parents—gesetzt; Wenn getunnelt, Verbindungs-UID der kapselnden Eltern
- orig_cc—Saite; ORIG GeoIP Landedode
- resp_cc—String; RESP GeoIP-Ländercode
Zuerst laden wir die CSV-Datei in ein Spark-Dataframe.
    from pyspark.sql.types import StructType, StructField, FloatType, BooleanType
from pyspark.sql.types import DoubleType, IntegerType, StringType
import pyspark
from pyspark.ml.linalg import Vectors
from pyspark.ml.feature import VectorAssembler
from pyspark.sql.functions import lit
from pyspark.sql.functions import udf, concat

from pyspark import SQLContext

conf = pyspark.SparkConf()

sc = pyspark.SparkContext.getOrCreate(conf=conf)
sqlcontext = SQLContext(sc)

schema = StructType([
    StructField("ts", StringType(),True),
    StructField("uid", StringType(),True),
    StructField("origh", StringType(),True),
    StructField("origp", StringType(),True),
    StructField("resph", StringType(),True),
    StructField("respp", StringType(),True),
    StructField("proto", StringType(),True),
    StructField("service" , StringType(),True),
    StructField("duration", FloatType(),True),
    StructField("origbytes", StringType(),True),
    StructField("respbytes", StringType(),True),
    StructField("connstate", StringType(),True),
    StructField("localorig", StringType(),True),
    StructField("missedbytes", StringType(),True),
    StructField("history", StringType(),True),
    StructField("origpkts", IntegerType(),True),
    StructField("origipbytes", IntegerType(),True),
    StructField("resppkts", IntegerType(),True),
    StructField("respipbytes", IntegerType(),True),
    StructField("tunnelparents", StringType(),True)
              ])


df = sqlcontext.read.csv(path="/home/ubuntu/Documents/forensics/bigger.log", sep="\t", schema=schema)
df2 = df.fillna(0)
Als Nächstes registrieren wir eine benutzerdefinierte UDF (benutzerdefinierte Funktion). Wir werden damit alle an diese Funktion gesendeten Felder in ganze Zahlen umwandeln, da maschinelles Lernen größtenteils nur mit Zahlen arbeitet.
    colsInt = udf(lambda z: toInt(z), IntegerType())

sqlcontext.udf.register("colsInt", colsInt)

def toInt(s):
    if not s:
        return 0
    if isinstance(s, str) == True:
        st = [str(ord(i)) for i in s]
        return(int(''.join(st)))
    else:
        return s
Nun erstellen wir einige zusätzliche Spalten, die wir ausgewählt haben, um sie in unser Modell einzuführen. Für jede dieser Spalten rufen wir das colsInt() UDF auf, um diese in Zahlen umzuwandeln.
Sie könnten die Auswahl der Spalten je nach Hypothesen variieren, denen Sie folgen möchten. Zum Beispiel betrachten wir unten die Ports und den Datenverkehr sowie das Protokoll.
- Es könnten andere Metriken in diesem Logbuch sein, die wir hinzufügen oder entfernen könnten.
- Wir sollten wahrscheinlich die Ziel-IP-Adresse aus dem Modell herauslassen, da der Hacker sein wahres Ziel verbergen kann.
- Wir könnten das UDP-Protokoll fallen lassen, da SFTP (TCP) das Protokoll wäre, das sie zur Übertragung verwenden würden.
- Oder wir könnten die Tageszeit in die lokale Zeitzone einbeziehen, um Ereignisse außerhalb der Geschäftszeiten zu isolieren.
Es hängt ganz davon ab, auf welche Art von Aktivität du dich konzentrieren möchtest.
Beachten Sie, dass jede der .withColumn() -Anweisungen einen neuen Dataframe erzeugt. Dies liegt daran, dass Spark-Dataframes unveränderlich sind.
    a = df2.withColumn( 'iorigp',colsInt('origp'))
c = a.withColumn( 'irespp',colsInt('respp'))
d = c.withColumn( 'iproto',colsInt('proto'))
e = d.withColumn('iorigh',colsInt('origh'))
f = e.withColumn( 'iorigbytes',colsInt( 'origbytes'))
g = f.withColumn( 'irespbytes',colsInt('respbytes'))
h = g.withColumn(  'iorigpkts',colsInt( 'origpkts'))
i = h.withColumn( 'iorigipbytes',colsInt('origipbytes'))

columns =  ['iorigp','irespp','iproto', 'iorigbytes','irespbytes','iorigpkts','iorigipbytes']
Der nächste Schritt fügt unserem Dataframe eine Spalte namens Features hinzu. Dies ist ein Tupel der ausgewählten Spalten. Der K-means-Algorithmus erwartet, dass es eine Feature-Spalte gibt.
    vecAssembler = VectorAssembler(inputCols=columns, outputCol="features")
router = vecAssembler.transform(i)
Hier verwenden wir den K-means-Algorithmus. Ein Vorteil von Apache Spark ist, dass seine maschinellen Lernalgorithmen einfach zu bedienen sind. Sie erfordern nicht die Umbearbeitung und Umformung wie andere Frameworks und arbeiten mit Spark-Dataframes, sodass wir mit viel größeren Datensätzen arbeiten könnten. (Pandas skaliert nicht wie Spark-Dataframes.)
    from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator


kmeans = KMeans().setK(7).setSeed(1)
model = kmeans.fit(router)

predictions = model.transform(router)

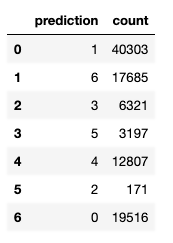
p = predictions.groupby('prediction').count()
q = p.toPandas()
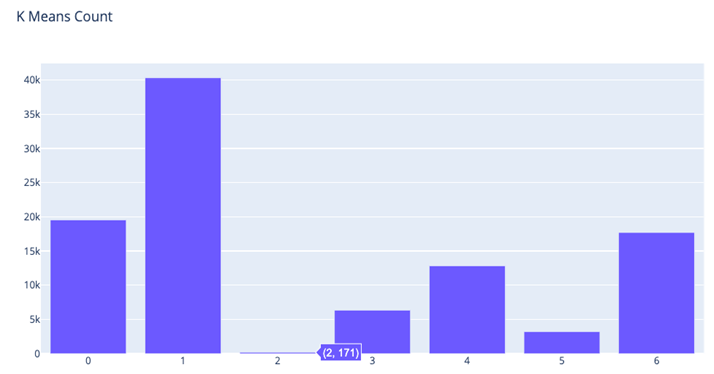
Wir haben die Beobachtungen in 7 Cluster gruppiert. Cluster 0 hat 40.303 Router-Datensätze, aber Cluster 2 nur 171. Offensichtlich sind das Ausreißer, daher konzentrieren wir uns auf unsere Cybersicherheitsanalyse.
Wir können das als Balkendiagramm darstellen, um weiter zu zeigen, wie die Daten gruppiert sind.
    from plotly.offline import plot

import pandas as pd


import plotly.graph_objects as go
fig = go.Figure(
    data=[go.Bar(x=q['prediction'],y=q['count'])],
    layout_title_text="K Means Count"
)
fig.show()
Plotly verwendet JavaScript, um Popups zu erstellen, die Ihnen mehr Informationen geben, wo Sie den Cursor platzieren. Wir haben ihn an den Punkt gesetzt (Prognose=2, Zahl=121).
Also erstellen wir einen neuen Dataframe nur aus diesen Datensätzen in Cluster 2. (Es ist tatsächlich Zeilenindex 5 im Dataframe, also verwechselt man diese beiden Konzepte nicht.)
suspect = predictions.filter("prediction == 2")
Hier wandeln wir die Ausgabe in Pandas um, einfach weil das Jupyter-Notizbuch diese Daten klarer darstellt als Datenframes, wobei es dazu neigt, breite Spalten abzuschneiden, was sie schwer lesbar macht.
x = suspect.select('ts','uid','origh','resph').toPandas()
Man kann dieselbe IP-Adresse mehrmals anzeigen, was wahrscheinlich ein guter Ort für eine weitere Analyse ist. Schau dir an, um welche Maschine es sich handelt und mit wem sie verbunden ist.

Ihre Analysten können also die Protokolle Ihrer Anwendungen, Firewall usw. durchsehen, um zu sehen, was mit diesen IP-Adressen los ist. (Beachten Sie, dass einige davon im IPv6-Format sind.)
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.