




Auf einen Blick: Daten können mit Apache Spark und dem K-Means-Algorithmus in verschiedene Gruppen gruppiert werden, wie im Tutorial gezeigt. Es enthält Codebeispiele und bewertet die Cluster-Effektivität anhand von Metriken wie Silhouette Score und Summe quadrierter Fehler.
- Cluster werden auf Basis von Datenpunkten mit Schwerpunkten und Hyperebenen gebildet.
- Evaluationskennzahlen umfassen den Silhouette-Score und die Summe der quadrierten Fehler.
In diesem Artikel zeigen wir, wie man Daten mit Apache Spark und dem Spark ML K-Means-Algorithmus in verschiedene Gruppen, sogenannte "Cluster", einteilt. Dieser Ansatz funktioniert mit allen Daten, die man nach einigen gemeinsamen Merkmalen aufteilen möchte. Diese Daten zeigen medizinische Patienten, einige mit Herzkrankheit, andere ohne. Wir haben diese Daten bereits mithilfe logistischer Regression betrachtet. Die Klassifikation sagt uns nicht, welche Herzkrankheiten haben (so hat die logistische Regression im vorherigen Beitrag getan), aber man kann logisch schließen, dass eine Patientengruppe krank ist und die andere nicht, da die Gesundheitsindikatoren die Eingabedaten sind.
Verständnis des Spark ML K-Means Algorithmus
Die Klassifikation funktioniert, indem Koordinaten im n-dimensionalen Raum gefunden werden, die diese Daten am nächsten trennen. Stellen Sie sich das als eine Ebene im 3D-Raum vor: Auf der einen Seite befinden sich Datenpunkte, die zu einem Cluster gehören, und die anderen auf der anderen Seite. In diesem Beispiel haben wir 12 Datenmerkmale (Datenpunkte). Sie werden sehen, dass die Ebene die unten gezeigten Koordinaten hat. Es ist keine Ebene im eigentlichen Sinne, da es mehr als drei Dimensionen gibt, aber man könnte es eine Hyperebene nennen. (Dennoch ist das mentale Bild einer Ebene nah genug, um das Beispiel zu erklären.) Unten teilen wir die Daten in zwei Cluster, was erklärt, warum wir zwei Koordinatensätze haben. Das sind die Schwerpunkte oder der zentrale Punkt jedes Clusters. Wenn wir versuchen, sie in eine größere Anzahl von Clustern zu unterteilen, wird das weniger genau, da die Daten nicht ausreichend voneinander entfernt sind.
    [5.68235294e+01 5.68627451e-01 3.25490196e+00 1.35803922e+02
 3.00078431e+02 1.47058824e-01 1.18627451e+00 1.45225490e+02
 4.01960784e-01 1.09705882e+00 1.59803922e+00 8.23529412e-01]
[5.29821429e+01 7.44047619e-01 3.12500000e+00 1.28636905e+02
 2.19047619e+02 1.48809524e-01 9.22619048e-01 1.52380952e+02
 2.85714286e-01 1.02142857e+00 1.57738095e+00 5.77380952e-01]
Hier ist der Code , der als Zeppelin-Notizbuch gespeichert ist. (Der verwandte Beitrag in diesem Leitfaden erklärt das Datenfeld und wie man den Spark-Datenrahmen lädt.) Die Daten sind gleich, außer dass wir eine Patienten-ID-Spalte hinzufügen.
    %spark.pyspark

def isSick(x):
    if x in (3,7):
        return 0
    else:
        return 1


import pandas as pd
from pyspark.sql.types import StructType, StructField, NumericType


cols = ('age',
      'sex',
       'chest pain',
       'resting blood pressure',
       'serum cholestoral',
       'fasting blood sugar',
       'resting electrocardiographic results',
       'maximum heart rate achieved',
       'exercise induced angina',
       'ST depression induced by exercise relative to rest',
      'the slope of the peak exercise ST segment',
      'number of major vessels ',
       'thal',
       'last')


data = pd.read_csv('/home/ubuntu/Downloads/heart.csv', delimiter=' ', names=cols)

data['isSick'] = data['thal'].apply(isSick)

rowCount = data['age'].count()
ids = np.arange(1,rowCount+1,1)
data['id'] = ids


df = spark.createDataFrame(data)


from pyspark.ml.feature import VectorAssembler

features =   ('age',
      'sex',
       'chest pain',
       'resting blood pressure',
       'serum cholestoral',
       'fasting blood sugar',
       'resting electrocardiographic results',
       'maximum heart rate achieved',
       'exercise induced angina',
       'ST depression induced by exercise relative to rest',
      'the slope of the peak exercise ST segment',
      'number of major vessels ')


assembler = VectorAssembler(inputCols=features,outputCol="features")

dataset=assembler.transform(df)
dataset.select("features").show(truncate=False)
Dieser untenstehende Code stammt direkt aus der Spark ML-Dokumentation mit einigen Änderungen, da es nur eine Möglichkeit gibt, den Algorithmus zu verwenden. Ein paar Punkte zu beachten:
- KMeans().setK(2).setSeed(1)—Die Zahl 2 ist die Anzahl der Cluster, in die die Daten geteilt werden sollen. Wir sehen, dass jede Zahl größer als 2 dazu führt, dass dieser Wert ClusteringEvaluator() unter 0,5 fällt, was bedeutet, dass es keine klare Division ist. Eine weitere Möglichkeit, die optimale Anzahl von Clustern zu überprüfen, wäre, eine Ellbogenkurve zu zeichnen.
- Predictions = model.transform(dataset)—Dadurch wird die Prognosespalte zum Dataframe hinzugefügt, sodass wir zeigen können, welche Patienten für welche Kategorie qualifiziert sind.
Der Rest des Codes ist offensichtlich. Der Code druckt die Cluster-Zentren für jede Division sowie die Summe der quadrierten Fehler aus. Das ist ein Hinweis darauf, wie es funktioniert: Er berechnet die Entfernung jedes Datenpunkts von seiner Schätzung bis zum Zentrum des Clusters, passt die Schätzungen an und wiederholt sich dann, bis die Zahl ihr Minimum erreicht. Der Abstand jedes Punktes zu diesem zentralen Punkt wird quadriert, sodass der Abstand immer positiv ist. Das Ziel ist es, die kleinste mögliche Anzahl zu haben – die kürzeste Entfernung zwischen allen Datenpunkten.
    %spark.pyspark

from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.clustering import KMeans

# Trains a k-means model.
kmeans = KMeans().setK(2).setSeed(1)
model = kmeans.fit(dataset)

# Make predictions
predictions = model.transform(dataset)

# Evaluate clustering by computing Silhouette score
evaluator = ClusteringEvaluator()

silhouette = evaluator.evaluate(predictions)
print("Silhouette with squared euclidean distance = " + str(silhouette))


# Evaluate clustering.
cost = model.computeCost(dataset)
print("Within Set Sum of Squared Errors = " + str(cost))

# Shows the result.
print("Cluster Centers: ")
ctr=[]
centers = model.clusterCenters()
for center in centers:
    ctr.append(center)
    print(center)
Im Folgenden zeigt der Algorithmus die quadrierte euklidische Distanz.
- Ist diese Zahl negativ, können die Daten überhaupt nicht getrennt werden.
- Werte näher bei 1 geben den maximalen Abstand an.
- Werte nahe null bedeuten, dass die Daten kaum getrennt werden können.
In diesem Beispiel ist 0,57 nicht schlecht.
    Silhouette with squared euclidean distance = 0.5702065126840549
Within Set Sum of Squared Errors = 548301.9823949672
Cluster Centers:
[5.68235294e+01 5.68627451e-01 3.25490196e+00 1.35803922e+02
 3.00078431e+02 1.47058824e-01 1.18627451e+00 1.45225490e+02
 4.01960784e-01 1.09705882e+00 1.59803922e+00 8.23529412e-01]
[5.29821429e+01 7.44047619e-01 3.12500000e+00 1.28636905e+02
 2.19047619e+02 1.48809524e-01 9.22619048e-01 1.52380952e+02
 2.85714286e-01 1.02142857e+00 1.57738095e+00 5.77380952e-01]
Um es einfach visualisieren zu können, konvertieren wir den Spark-Datenrahmen in einen Pandas-Datenrahmen, sodass wir die Zeppelin-Funktion z.show verwenden können, um die Tabelle aufzulisten.
    %spark.pyspark
pandasDF=predictions.toPandas()
centers = pd.DataFrame(ctr,columns=features)
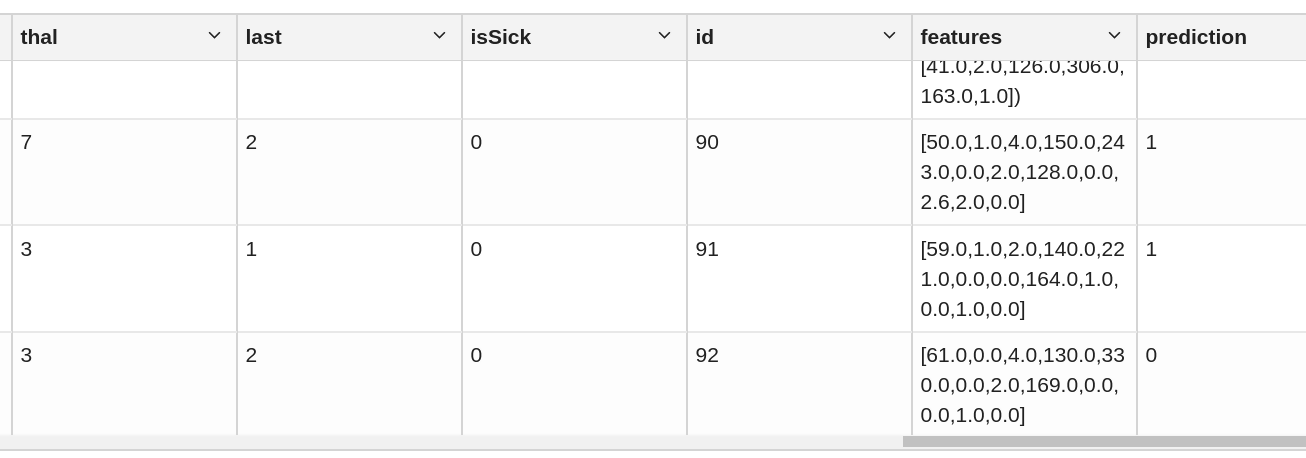
Man kann diese Daten nicht grafisch darstellen, weil ein 3D-Diagramm nur drei Variablen darstellen kann. Wir können also nicht zeigen, wie Herzpatienten getrennt sind, aber wir können sie mit z.display() in einen tabellarischen Bericht einordnen und die Vorhersagespalte beobachten, was sie in eine oder andere Kategorie einordnet:
    %spark.pyspark
z.show(pandasDF)
Wie wir sehen, befinden sich die Patienten 90 und 91 in Cluster 1. Patient 92 ist in Cluster 0.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.