




Auf einen Blick: Lineare Regression mit Stochastic Gradient Descent (SGD) mit Apache Spark ermöglicht eine effiziente prädiktive Modellierung. Dieses Tutorial bietet einen umfassenden Leitfaden zur Implementierung des Modells in Scala, der Datenverarbeitung, Training und Fehlerberechnung abdeckt.
SGD ist auf spezifische Analyseherausforderungen zugeschnitten.
Der mittlere quadratische Fehler (MSE) wird zur Bewertung der Modellgenauigkeit verwendet.
Erfahren Sie mehr über die Machine Learning Pipeline von Apache Spark.
Dieser Artikel erklärt, wie man lineare Regression mit Apache Spark durchführt. Er setzt voraus, dass du grundlegende Kenntnisse der linearen Regression hast. Wenn nicht, musst du dich damit beschäftigen, da es eine der einfachsten Ideen in der Statistik ist. Außerdem sind die meisten Maschinensprachmodelle eine Erweiterung dieser Grundidee. Es ist so einfach zu verstehen und zu verwenden, dass du es mit Google Sheets oder Microsoft Excel machen kannst. Obwohl du in diesen Tools auf eine Eingabevariable beschränkt bist. Unser Beispiel hier hat etwa 12. Das Ziel ist es, eine Formel zu entwickeln, um ein prädiktives Modell zu erstellen. Ab der Highschool wirst du das Modell hier als die Formel für eine gerade Linie erkennen, wobei b der Punkt ist, an dem die Linie die y-Achse kreuzt.
y = mx + b
Zum Beispiel könnten wir annehmen, dass Umsatz- und Werbeausgaben miteinander zusammenhängen. Wir könnten also schreiben:
    y = mx + b
= sales = some function of (advertising expenses ) + constant_value (b)
= (number of ads purchased (m))* (average age cost of ad ( x)) + b.
In diesem Fall ist der Wert für b 0, da keine Anzeigen keine Ausgaben bedeuten. Die klassische Lösung dieses Problems ist, die Linie zu finden.
y = mx + b
das diese Daten fast genau in der Mitte aufteilt, wie im untenstehenden Diagramm gezeigt. Dazu finden wir die Linie, deren durchschnittlicher Abstand zu den Datenpunkten am kleinsten ist.
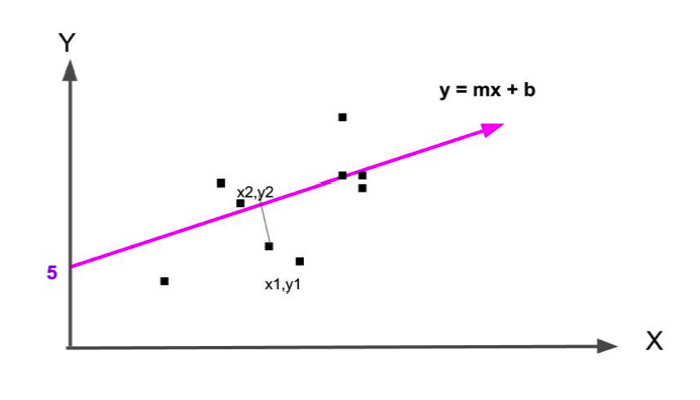
Der einfachste Weg, diese Linie in Apache Spark zu finden, ist, Folgendes zu verwenden:
org.apache.spark.mllib.regression.LinearRegressionMode.
Ein ausgefeilterer Ansatz ist jedoch, Folgendes zu verwenden:
org.apache.spark.mllib.regression.LinearRegressionWithSGD
wobei stochastischer Gradientenabstieg steht. Aus Gründen, die über den Rahmen dieses Dokuments hinausgehen, genügt es zu sagen, dass SGD für bestimmte analytische Probleme besser geeignet ist als andere. Welcher Algorithmus am besten geeignet ist, basiert auf vielen Faktoren – wie zum Beispiel, welcher die besten Schätzungen macht, die Effizienz des Algorithmus, die Tendenz, einen Algorithmus zu übertrainieren (was zu Schlüssen führt, die durch vorurteilsbehaftete Annahmen verzerrt sind), seiner Empfindlichkeit gegenüber Ausreißern (das heißt, er vermischt die Schätzung, wenn Datenpunkte weit von den anderen entfernt sind) usw. Die einzige Möglichkeit zu wissen, welches Modell verwendet werden sollte, ist, das Modell mit dem geringsten Fehler zu finden, also das Modell, das den kleinsten Unterschied zwischen den vorhergesagten und beobachteten Werten liefert. Das ist es, was Data Scientists tun – sie probieren mehrere Modelle aus.
Wie man lineare Regression mit Apache Spark und Scala programmiert
Laden Sie diese Daten herunter: https://raw.githubusercontent.com/cloudera/spark/master/mllib/data/ridge-data/lpsa.data Es spielt keine Rolle, was diese Daten sind. Wir interessieren uns nicht für die Spaltenüberschriften oder überhaupt dafür, was diese Daten bedeuten. Wir wollen nur zeigen, wie man lineare Regressionen macht, und brauchen Daten, die korrelieren. Viele Daten korrelieren überhaupt nicht, das heißt, lineare Regression oder irgendeine Art von Statistik passt nicht dazu. Zum Beispiel sind Benzinpreise und Benzinverkäufe kaum korreliert, da Menschen Gas unabhängig vom Preis kaufen, weil sie es brauchen. Zuerst zeigen wir den gesamten Code, dann gehen wir ihn Zeile für Zeile durch.
    import org.apache.spark.mllib.linalg.Vectors
import org.apache.spark.mllib.regression.LabeledPoint
import org.apache.spark.mllib.feature.Normalizer
import org.apache.spark.mllib.regression.LinearRegressionWithSGD
val data = sc.textFile("/home/walker/lpsa.dat")
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
val MSE = valuesAndPreds.map{ case(v, p) => math.pow((v - p), 2) }.mean()
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val d = y.size - 1
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
}.cache()
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
}
-0.4307829,-1.63735562648104 -2.00621178480549 -1.86242597251066 -1.02470580167082 -0.522940888712441 -0.863171185425945 -1.04215728919298 -0.864466507337306
Das erzeugt Daten als RDD[String].
val data = sc.textFile("/home/walker/lpsa.dat")
Eine Zeichenkette ist ein iterables Objekt, daher schleifen wir zweimal darüber, um sie in Leerzeichen zu unterteilen. Wir machen das zweimal, weil man in den Daten sehen kann, dass die ersten beiden Elemente durch ein Komma getrennt sind, also müssen wir das zuerst entfernen.
    val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
Wir wandeln dann alle diese Strings in Doubles um, da maschinelles Lernen Zahlen benötigt und dieser spezielle Algorithmus einen Vektor von Doubles benötigt.
val y = x.map{ (a => a.toDouble)}
Der LabeledPoint ist ein Objekt, das vom linearen Regressionsalgorithmus benötigt wird. Es ist in diesem Format vorliegend
(labels, features)
Wobei Features ein Vektor ist. Hier verwenden wir einen dichten Vektor, der ein Typ ist, der keine leeren Werte verarbeitet, von denen wir keine haben.
    val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val d = y.size - 1
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
}.cache()
Beachten Sie, dass wir das Wort Cache verwenden, weil Spark ein verteiltes System ist. Um dies zu berechnen, müssen wir Daten von jedem Knoten abrufen. Cache, wie Collect, sammelt alle Elemente über die Knoten hinweg.
Training mit Testdaten
In diesem Beispiel verwenden wir auch das Trainingsset als Testdaten . Das ist für die Illustration in Ordnung, da beide nahezu gleich sein sollten, wenn sie echte Stichproben tatsächlicher Daten darstellen. Im echten Leben trainiert man auf den Trainingsdaten, zum Beispiel auf der lpsa.dat-Datei. Dann macht man Vorhersagen auf neue eingehende Daten, die Testdaten genannt werden, obwohl ein besserer Name Live-Daten wäre. Es gibt zwei Parameter: Numiterationen und Schrittgröße, zusätzlich zum LabeledPoint. Man müsste die Logik und Mathematik des stochastischen Gradientenabstiegs verstehen, um zu verstehen, was diese bedeuten, was wir hier nicht erklären, da es komplex ist. Im Grunde bedeutet das, wie oft der Algorithmus immer wieder in Schleifen laufen kann, um seine Schätzung anzupassen, also sich auf den Punkt zu konzentrieren, an dem der Fehler so nah wie möglich an null geht. Das nennt man Konvergieren.
    val numIterations = 100
val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
Teste das Modell
Um nun zu sehen, wie gut es funktioniert, schleifen Sie den LabelPoint durch und führen Sie dann die predict()-Methode über jede Methode durch, wodurch ein neues RDD(double, double) aus dem Label (y oder der unabhängigen Variable, also dem beobachteten Endergebnis y) und der Prognose (die Schätzung basierend auf der Regressionsformel des SDG-Algorithmus) erstellt wird.
    val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
}
Fehler berechnen
Ein Fehler von 0 würde bedeuten, dass wir ein perfektes Modell haben. Wie Sie unten sehen können, sagt das Modell Werte erst gut vorher, wenn das Label hoch ist. Für das gesamte Modell lautet der Fehler:
    println("training Mean Squared Error = " + MSE)
training Mean Squared Error = 7.451030996001437
MSE bedeutet die Differenz zwischen dem Durchschnitt ((vorhergesagter Wert – tatsächlicher Wert ) ** 2 (quadriert)). Wenn der Prädiktiv nahezu dem tatsächlichen Wert ist, liegt MSE nahe bei 0.
    valuesAndPreds.foreach((result) => println(s"predicted label: ${result._1}, actual label: ${result._2}"))
predicted label: -0.4307829, actual label: -6.538896995115336E-8
...
predicted label: 1.446919, actual label: 1.7344923653317994E-7
...
predicted label: 2.6567569, actual label: 3.4906394367410936E-7
predicted label: 1.8484548, actual label: 2.592863859023973E-7
....
predicted label: 2.2975726, actual label: 3.16412860478681E-7
predicted label: 2.7180005, actual label: 3.4164515319254127E-7
predicted label: 2.7942279, actual label: 3.448229999917885E-7
predicted label: 2.8063861, actual label: 3.5506022919177794E-7
predicted label: 2.8124102, actual label: 3.64517218758205E-7
predicted label: 2.8419982, actual label: 3.508992428582512E-7
...
predicted label: 4.029806, actual label: 5.019849314865162E-7
predicted label: 4.1295508, actual label: 5.211902354094908E-7
predicted label: 4.3851468, actual label: 5.732554699437345E-7
predicted label: 4.6844434, actual label: 6.026343831319147E-7
predicted label: 5.477509, actual label: 7.208914981741786E-7
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.