





Auf einen Blick: Kubernetes DaemonSets stellen sicher, dass bestimmte Pods auf allen Knoten laufen, um Aufgaben wie Logging und Überwachung zu verwalten, und erstellen und entfernen Pods automatisch, wenn Knoten hinzugefügt oder entfernt werden.
- Konfiguriert mit YAML-Dateien, was verschiedene Anpassungen für die Pod-Bereitstellung ermöglicht.
- Erleichtert die Bereitstellung von Diensten wie Fluentd und Prometheus über alle Knoten in einem Kubernetes-Cluster.
Kubernetes ist eine führende Open-Source-Engine, die containerisierte Anwendungen orchestriert. In diesem Artikel werfen wir einen Blick auf die von Kubernetes angebotene DaemonSet-Funktion. Wir führen Sie durch Anwendungsfälle und wie Sie DaemonSets erstellen, aktualisieren, kommunizieren und löschen.
Was ist ein Kubernetes DaemonSet?
Die DaemonSet-Funktion wird verwendet, um sicherzustellen, dass einige oder alle Ihrer Pods auf jedem verfügbaren Knoten geplant und laufen. Dies führt im Grunde eine Kopie des gewünschten Pods über alle Knoten aus.
- Wenn ein neuer Knoten zu einem Kubernetes-Cluster hinzugefügt wird, wird ein neuer Pod zu diesem neu angeschlossenen Knoten hinzugefügt.
- Wenn ein Knoten entfernt wird, sorgt der DaemonSet-Controller dafür, dass der mit diesem Knoten verknüpfte Pod abgesammelt wird. Das Löschen eines DaemonSet beseitigt alle Pods, die DaemonSet erstellt hat.
DaemonSets sind ein integraler Bestandteil des Kubernetes-Clusters und ermöglichen es Administratoren, Services (Pods) einfach über alle oder eine Teilmenge von Knoten zu konfigurieren.
Anwendungsfälle von DaemonSet
DaemonSets können die Leistung eines Kubernetes-Clusters verbessern, indem sie Wartungsaufgaben und Unterstützungsdienste über das Deployen von Pods über alle Knoten verteilt. Sie eignen sich gut für langlaufende Dienste wie Überwachung oder Protokollsammlung. Im Folgenden sind einige Beispielanwendungen von DaemonSets aufgeführt:
- Um einen Daemon für die Clusterspeicherung auf jedem Knoten auszuführen, wie Glusterd und Ceph.
- Um einen Daemon für die Logsammlung auf jedem Knoten auszuführen, wie Fluentd und Logstash.
- Um einen Daemon für die Knotenüberwachung auf jeder Note auszuführen, wie zum Beispiel Prometheus Node Exporter, Collected oder Datadog-Agenten.
Je nach Anforderungen kann man mehrere DaemonSets für einen einzigen Daemon-Typ einrichten, mit unterschiedlichen Flags, Speicher, CPU usw., die verschiedene Konfigurationen und Hardwaretypen unterstützen.
Scheduling von DaemonSet-Pods
Standardmäßig wird der Knoten, auf dem ein Pod läuft, vom Kubernetes-Scheduler bestimmt. Allerdings werden DaemonSet-Pods vom DaemonSet-Controller erstellt und geplant. Die Verwendung des DaemonSet-Controllers kann zu inkonsistentem Pod-Verhalten und Problemen bei der Pod-Prioritätspräemption führen. Um diese Probleme zu mindern, ermöglicht Kubernetes (ScheduleDaemonSetPods) Nutzern, DaemonSets mit dem Standard-Scheduler statt mit dem DaemonSet-Controller zu planen. Dies geschieht, indem der NodeAffinity-Begriff zu den DaemonSet-Pods statt des .spec.nodeName-Terms hinzugefügt wird. Der Standard-Scheduler wird dann verwendet, um den Pod an den Zielhost zu binden. Im Folgenden eine Beispielkonfiguration für NodeAffinity:
    apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          # Key Name
          - key: disktype
            operator: In
            # Value
            values:
            - ssd
  containers:
  - name: nginx
    image: nginx
    imagePullPolicy: IfNotPresent
Oben haben wir NodeAffinity so konfiguriert, dass ein Pod nur auf einem Knoten erstellt wird, der das Label "disktype=ssd" trägt. Zusätzlich halten sich DaemonSet-Pods an Verunreinigungen und Toleranzen in Kubernetes. Die node.kubernetes.io/unschedulable:NoSchedule-Toleranz wird automatisch zu DaemonSet-Pods hinzugefügt. (Weitere Informationen zu Verunreinigungen und Toleranzen finden Sie in der offiziellen Kubernetes-Dokumentation.)
Wie man ein DaemonSet erstellt
Wie bei allen anderen Komponenten in Kubernetes werden DaemonSets mit einer YAML-Datei konfiguriert. Schauen wir uns die Struktur einer DaemonSet-Datei an.
    apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: test-daemonset
  namespace: test-daemonset-namespace
  Labels:
    app-type: test-app-type
spec:
  template:
    metadata:
      labels:
        name: test-daemonset-container
  selector:
    matchLabels:
      name: test-daemonset-container
Wie man in der obigen Struktur sehen kann, sind apiVersion, Typ und Metadaten in jedem Kubernetes-Manifest erforderliche Felder. Die DaemonSet-spezifischen Felder fallen unter den Spezifikationsbereich – diese Felder sind beide verpflichtend.
- Vorlage. Dies ist die Pod-Definition für den Pod, der über alle Knoten verteilt werden muss. Eine Pod-Vorlage in einem DaemonSet muss seine RestartPolicy auf "Always" setzen, und standardmäßig nimmt sie "Always", wenn du keine RestartPolicy angegeben hast.
- Selektor. Der Selektor für die Pods, die vom DaemonSet verwaltet werden. Dieser Wert muss ein im Pod-Template angegebenes Label sein. (Im obigen Beispiel haben wir den Namen: test-daemonset-container als Selektor verwendet.) Dieser Wert ist fest und kann nach der Ersterstellung des DaemonSet nicht mehr geändert werden. Eine Änderung dieses Wertes führt dazu, dass Pods, die über dieses DaemonSet erstellt wurden, verwaist werden. Kubernetes bietet zwei Möglichkeiten, matchLabels und matchExpressions für die Erstellung komplexer Selektoren abzugleichen.
Weitere optionale Felder
- template.spec.nodeSelector – Dieser kann verwendet werden, um eine Teilmenge von Knoten zu spezifizieren, die den Pod mit dem angegebenen Selektor erstellen.
- template.spec.affinity – Dieses Feld kann so konfiguriert werden, dass die Affinität festgelegt wird, die den Pod nur auf Knoten ausführt, die der konfigurierten Affinität entsprechen.
Erstellung eines DaemonSet
Nun machen wir ein Beispiel-DaemonSet. Hier verwenden wir ein "fluentd-elasticsearch"-Bild, das auf jedem Knoten in einem Kubernetes-Cluster ausgeführt wird. Jeder Pod sammelt dann Logs und sendet die Daten an ElasticSearch.
daemonset-example.yaml
    apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd-elasticsearch-test
  namespace: default # Name Space
  labels:
    k8s-app: fluentd-logging
spec:
  selector: # Selector
    matchLabels:
      name: fluentd-elasticsearch-test-deamonset
  template: # Pod Template
    metadata:
      labels:
        name: fluentd-elasticsearch-test-deamonset
    spec:
      tolerations: # Tolerations
      - key: node-role.kubernetes.io/master
        effect: NoSchedule
      containers: # Container Details
      - name: fluentd-elasticsearch
        image: quay.io/fluentd_elasticsearch/fluentd:v2.5.2
        resources:
          limits:
            memory: 200Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
        - name: varlibdockercontainers
          mountPath: /var/lib/docker/containers
          readOnly: true
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
      - name: varlibdockercontainers
        hostPath:
          path: /var/lib/docker/containers
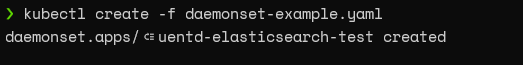
Zuerst erstellen wir das DaemonSet mit dem Befehl kubectl create und rufen das DaemonSet und die Pod-Informationen wie folgt ab:
kubectl create -f daemonset-example.yaml
kubectl get daemonset

kubectl get pod -o wide

Wie Sie aus der obigen Ausgabe sehen können, wurde unser DaemonSet erfolgreich bereitgestellt. Je nach verfügbaren Knoten im Cluster skaliert es automatisch, um der Anzahl der Knoten oder einer Teilmenge von Knoten in der Konfiguration zu entsprechen. (Hier wird die Anzahl der Knoten eins sein, da wir dies in einer Testumgebung mit einem einzelnen Knoten-Kubernetes-Cluster ausführen.)
Aktualisierung von DaemonSets
Wenn es darum geht, DaemonSets zu aktualisieren, fügt DaemonSet bei einer Änderung eines Knotenlabels automatisch neue Pods zu passenden Knoten hinzu, während Pods von nicht übereinstimmenden Knoten gelöscht werden. Wir können den Befehl "kubectl apply" verwenden, um ein DaemonSet zu aktualisieren, wie unten gezeigt.
Es gibt zwei Strategien, die beim Aktualisieren von DaemonSets angewendet werden können:
- Die Standardstrategie in Kubernetes ist, dass alte DaemonSet-Pods gelöscht werden und automatisch neue Pods erstellt werden, wenn eine DaemonSet-Vorlage aktualisiert wird.
- Bei dieser Option werden neue DaemonSet-Pods erst erstellt, nachdem ein Nutzer alte DaemonSet-Pods manuell gelöscht hat.
Diese Strategien können mit der Option spec.updateStrategy.type konfiguriert werden.
Löschen von DaemonSets
Das Löschen eines DaemonSet ist eine einfache Aufgabe. Dazu führt man einfach den kubectl-delete-Befehl mit dem DaemonSet aus. Das würde das DaemonSet mit allen zugrundeliegenden Pods löschen, die es erstellt hat.
Wir können den Cascade=False Flag im kubectl-Delete-Befehl verwenden, um nur das DaemonSet zu löschen, ohne die Pods zu löschen.
Kommunikation mit von DaemonSet erstellten Pods
Es gibt mehrere Methoden, um mit Pods zu kommunizieren, die von DaemonSets erstellt wurden. Hier sind einige verfügbare Optionen:
- Push. So können Pods so konfiguriert werden, dass sie Informationen an andere Dienste senden (Überwachungsdienst, Statistikdatenbank). Sie erhalten jedoch keine Daten.
- NodeIP & Bekannter Port. Pods sind über die Knoten-IPs über HostPort erreichbar. Nutzer können dann die bekannten Ports und die Knoten-IP nutzen, um mit den Pods zu kommunizieren.
- DNS. Mit dieser Methode können Benutzer einen headless-Service mit demselben Pod-Selektor konfigurieren, um DaemonSet mit der Endpoints-Ressource zu entdecken.
- Service. Um einen zufälligen Knoten in einem DaemonSet auszuwählen, mit dem wir einen Service mit demselben Pod-Selektor erstellen können.
DaemonSet-Zusammenfassung
In diesem Artikel haben wir mehr über Kubernetes DaemonSets erfahren. Diese Konfigurationen können Überwachung, Speicherung oder Logging-Dienste erleichtern, die genutzt werden, um die Leistung und Zuverlässigkeit sowohl des Kubernetes-Clusters als auch der Container zu steigern.
Verwandte Literatur
Kubernetes-Leitfaden
- Was ist Kubernetes (K8s)? Ein Tutorial zu den Grundlagen von Kubernetes
- Kubernetes Best Practices für verbesserte Cluster-Effizienz
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Kubernetes Pods: Eine Einführung
- Kubernetes ReplicaSets: Eine kurze Einführung
- Kubernetes-Deployments vollständig erklärt
- Wie man Kubernetes DaemonSets verwendet und verwaltet
- Wie Kubernetes-Dienste funktionieren
- Verwendung von Kubernetes Port, TargetPort und NodePort
- Erstellen und verwenden von ConfigMaps in Kubernetes
- Einführung in Kubernetes-Geheimnisse
- Kubernetes-Netzwerkgrundlagen
- Kubernetes-Ingress erklärt
- Einführung in Kubernetes Helm Charts
- Was ist das Kubernetes-Operator-Muster?
- Bereitstellung von PostgreSQL als StatefulSet in Kubernetes
- Kubernetes Custom Resource Definition (CRDs) erklärt
- 3 Kubernetes-Muster für Cloud-native Anwendungen
- Kubernetes Compute-Ressourcen erklärt
- Kubernetes-Sicherheit für DevOps-Pipelines
- Verwendung von Spinnaker mit Kubernetes für Continuous Delivery
- Kubernetes-Multi-Cluster: Wie und warum man sie verwendet.
- Kubernetes-Überwachung: Ein umfassender Leitfaden
- Kubernetes vs. Docker: Ein kurzer Vergleich
- Kubernetes vs. Docker Swarm: Vergleich von Container-Orchestrierungstools
- Kubernetes vs. OpenShift: Was ist der Unterschied?
- Kubernetes-Zertifizierungen: Wie und warum man zertifiziert wird
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.