





Auf einen Blick: Die Bereitstellung von PostgreSQL als StatefulSet in Kubernetes gewährleistet eine effiziente Verwaltung statefuler Anwendungen durch die Bereitstellung persistenter Speicher- und eindeutiger Pod-Identitäten. Dies ermöglicht eine geordnete Bereitstellung, Skalierung und vereinfachte Verwaltung von Umweltvariablen durch ConfigMaps.
- StatefulSets ermöglichen eine geordnete Bereitstellung und Skalierung von zustandsvollen Anwendungen.
- Die Nutzung von ConfigMaps vereinfacht die Verwaltung von Umweltvariablen bei Deployments.
Es gibt verschiedene Anwendungstypen, von einzelnen großen Anwendungen bis hin zu microservices-basierten Anwendungen, die unterschiedliche Bedürfnisse erfüllen. Was die Zustände dieser Anwendungen betrifft, gibt es zwei Zustände:
- Zustandslose Anwendungen können unabhängig isoliert ausgeführt werden, ohne Kenntnis von früheren Transaktionen.
- Zustandsfähige Anwendungen verfügen über vollständiges Wissen über die vergangenen Informationen (Zustand).
Die meisten von uns verwendeten Anwendungen sind zustandsbehaftete Anwendungen, deren Zustandsdaten aus Benutzerpräferenzen, aktuellen Aktivitäten, Datenbanktransaktionen, Zugangsdaten, Einstellungen usw. bestehen können.
Kubernetes stellt StatefulSets bereit, wenn eine stateful Anwendung in einem Kubernetes-Cluster erstellt wird. Das Management von Zuständen innerhalb einer containerisierten Umgebung ist mit der Beliebtheit der Bereitstellung von Datenbankclustern in Kubernetes noch bedeutender geworden.
In diesem Artikel konzentrieren wir uns darauf, wie man eine PostgreSQL-Datenbank auf einem Kubernetes-Cluster mit StatefulSets bereitstellt.
Was ist Kubernetes StatefulSets?
StatefulSet ist ein Kubernetes-Workload-API-Objekt, das zur Verwaltung von zustandsvollen Anwendungen verwendet werden kann.
Bei einer normalen Bereitstellung ist es dem Nutzer egal, wie die Pods geplant sind, solange dies keine negativen Auswirkungen auf die bereitgestellte Anwendung hat. Es besteht jedoch die Notwendigkeit, Pods korrekt zu identifizieren, um den Zustand in zustandsvollen Anwendungen mit persistenter Speicherung zu erhalten.
StatefulSet bietet diese Funktionalität, indem Pods mit einem persistenten Identifikator erstellt werden, der sich auf seinen Wert über das Rescheduling hinweg bezieht. So wird ein Pod korrekt auf die Speichervolumes abgebildet, selbst wenn er neu erstellt wird, und der Anwendungszustand bleibt erhalten.
StatefulSets Anwendungsfälle
Es gibt mehrere Anwendungsfälle für StatefulSets.
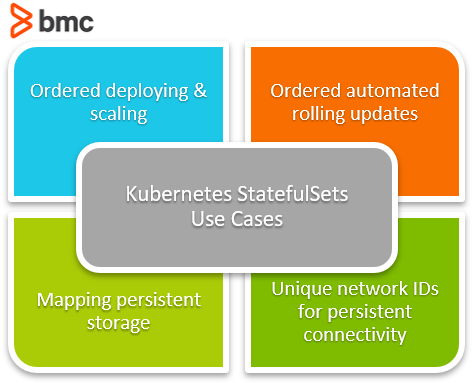
Geordnete Bereitstellung und Skalierung
Wenn eine Anwendung auf mehrere Container angewiesen ist, stellt der geordnete Ansatz zur Skalierung sicher, dass abhängige Container bei Deployments und Skalierungsszenarien geordnet erstellt werden.
Automatisierte Rolling-Updates wurden angeordnet
Das Aktualisieren von abhängigen Anwendungen oder Microservices sollte ebenfalls geordnet aktualisiert werden. Außerdem sollte ein Update die Funktionalität nicht beeinträchtigen.
Daher können Nutzer die Reihenfolge bestimmen, in der Anwendungen oder Microservices aktualisiert werden sollen, indem sie ein StatefulSet verwenden.
Abbildung persistenter Speicher
Bei der Betrachtung von Datenbanken ist persistente Speicherung der wichtigste Teil, da Anwendungen Daten speichern müssen. Mit einem StatefulSet können Benutzer:
- Definiere, welche Pods zu jedem persistenten Speicher gehören
- Schaffen Sie widerstandsfähige Anwendungsbereitstellungen
Verwendung eindeutiger Netzwerkidentifikatoren zur Schaffung einer dauerhaften Netzwerkverbindung
Mit eindeutigen Identifikatoren können Netzwerknutzer den Datenverkehr für bestimmte Pods verwalten und routen, ohne sich um IP-Änderungen bei der Neuplanung sorgen zu müssen. Dies ermöglicht eine größere Kontrolle über die Netzwerkkommunikation zwischen den Pods, da persistent Routing, Richtlinien und Sicherheitskonfigurationen für gewünschte Pods konfiguriert werden können.
Selbst mit diesen Vorteilen bieten StatefulSets keine Lösung für alle Anforderungen. StatefulSets sind beispielsweise nicht austauschbar mit Deployments oder ReplicaSets – diese sind stattdessen auf statelose Konfigurationen ausgerichtet.
Nachteile von StatefulSets
StatefulSets bringen außerdem eine Reihe von Einschränkungen mit sich, über die Nutzer vor der Bereitstellung der Anwendung Bescheid wissen sollten.
- Der Speicher für ein StatefulSet muss entweder von einem PersistentVolume Provisioner basierend auf der Speicherklasse bereitgestellt oder vorab bereitgestellt werden.
- Das Skalieren oder Löschen von Pods beeinflusst nicht den zugrundeliegenden persistenten Speicher, um die Datensicherheit zu gewährleisten. Die bereitgestellten Volumes bleiben innerhalb von Kubernetes.
- Der Benutzer muss manuell einen headless Service erstellen, um die Netzwerkidentität in StatefulSets sicherzustellen.
- SatefulSets garantiert nicht das Ende aktueller Pods, wenn das StatefulSet gelöscht wird. Best practice ist daher, dass der Benutzer ein SOP implementiert, um das StatefulSet vor dem Löschen auf null Pods zu skalieren.
- Das Rollen von Updates mit der Standard-Pod-Management-Richtlinie kann beim Deployen Probleme verursachen, wenn ein Pod defekt ist (aufgrund eines Anwendungskonfigurationsfehlers, einer fehlerhaften Binärdatei usw.). In solchen Fällen müssen die Nutzer:
- Manuell zu einer vorherigen Bereitstellungsvorlage zurücksetzen.
- Lösche die kaputten Pods, bevor du versuchst, die neuen Updates erneut auszuführen.
Einrichtung eines StatefulSet in einem Kubernetes-Cluster
Da wir nun ein grundlegendes Verständnis eines StatefulSet haben, schauen wir uns eine beispielhafte StatefulSet-Implementierung an.
StatefulSets sind ideal für Datenbankdeployments. In diesem Beispiel erstellen wir eine PostgreSQL-Deployment als StatefulSet mit einem persistenten Speichervolume.
postgresql.yaml
    # PostgreSQL StatefulSet
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: postgresql-db
spec:
  serviceName: postgresql-db-service
  selector:
    matchLabels:
      app: postgresql-db
  replicas: 2
  template:
    metadata:
      labels:
        app: postgresql-db
    spec:
      containers:
        - name: postgresql-db
          image: postgres:latest
          volumeMounts:
            - name: postgresql-db-disk
              mountPath: /data
          env:
            - name: POSTGRES_PASSWORD
              value: testpassword
            - name: PGDATA
              value: /data/pgdata
  # Volume Claim
  volumeClaimTemplates:
    - metadata:
        name: postgresql-db-disk
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 25Gi
In der obigen YAML-Datei haben wir ein einfaches StatefulSet definiert, um eine PostgreSQL-Datenbank bereitzustellen. Wir erstellen ein StatefulSet namens postgresql-db mit zwei Pods (Repliken: 2).
Zusätzlich erstellen wir ein persistentes Volume mit der volumeClaimTemplate und verwenden es im StatefulSet, um die PostgreSQL-Daten zu speichern. Der Standard-Persistent-Volume-Provisioner bereitet das Volume bereit, und wir können dies mit folgendem Befehl bereitstellen.
kubectl apply -f postgresql.yaml
Ergebnis:

Jetzt haben wir erfolgreich ein PostgreSQL StatefulSet erstellt, benötigen aber einen Service, der es außerhalb des Kubernetes-Clusters bereitstellt. Das kann durch die Erstellung eines Dienstes erreicht werden, der auf das StatefulSet verweist.
postgresql-service.yaml
    # PostgreSQL StatefulSet Service
apiVersion: v1
kind: Service
metadata:
  name: postgres-db-lb
spec:
  selector:
    app: postgresql-db
  type: LoadBalancer
  ports:
    - port: 5432
      targetPort: 5432
Dadurch wird ein Load Balancer erstellt und der Dienst stellt unsere PostgreSQL-Datenbank mit dem Selektor "app: postgresql-db" bereit. Du kannst den Service erstellen, indem du den untenstehenden Befehl ausführst.
kubectl apply -f postgresql-service.yaml
Ergebnis:

Sehen wir uns nun an, ob sowohl StatefulSet als auch der Service erfolgreich in Kubernetes erstellt werden, indem der folgende Befehl ausgeführt wird.
kubectl get all
Ergebnis:
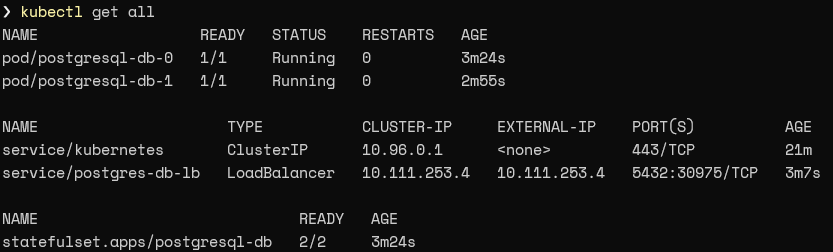
Das Ergebnis zeigt, dass zwei Pods erstellt und mit einem Load Balancer-Service ausgeführt werden, der StatefulSet über IP 10.111.253.4 über Port 5432 bereitstellt.
Tests der Konnektivität
Nachdem wir PostgreSQL bereitgestellt haben, müssen wir sicherstellen, dass wir problemlos darauf zugreifen können. Wir werden den pgAdmin4-Client verwenden, um die Verbindung zu initialisieren:
- Lade den pgAdmin-Client in deiner Umgebung herunter.
- Verbinden Sie sich und versuchen, eine Verbindung zu initialisieren.
Bei der oben genannten Bereitstellung verwenden wir die externe IP des postgres-db-lb-Dienstes (10.111.253.4) mit Port 5432. Da wir nur ein Passwort in unseren Umgebungsvariablen für das PostgreSQL StatefulSet definiert haben, wird die Konfiguration den Standardbenutzernamen "postgres" mit dem von uns definierten Passwort haben.
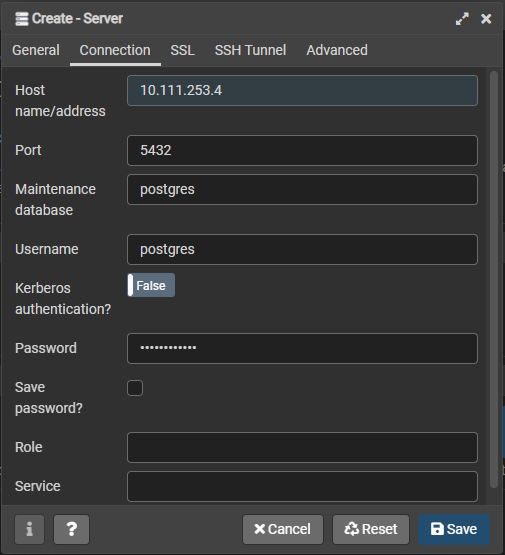
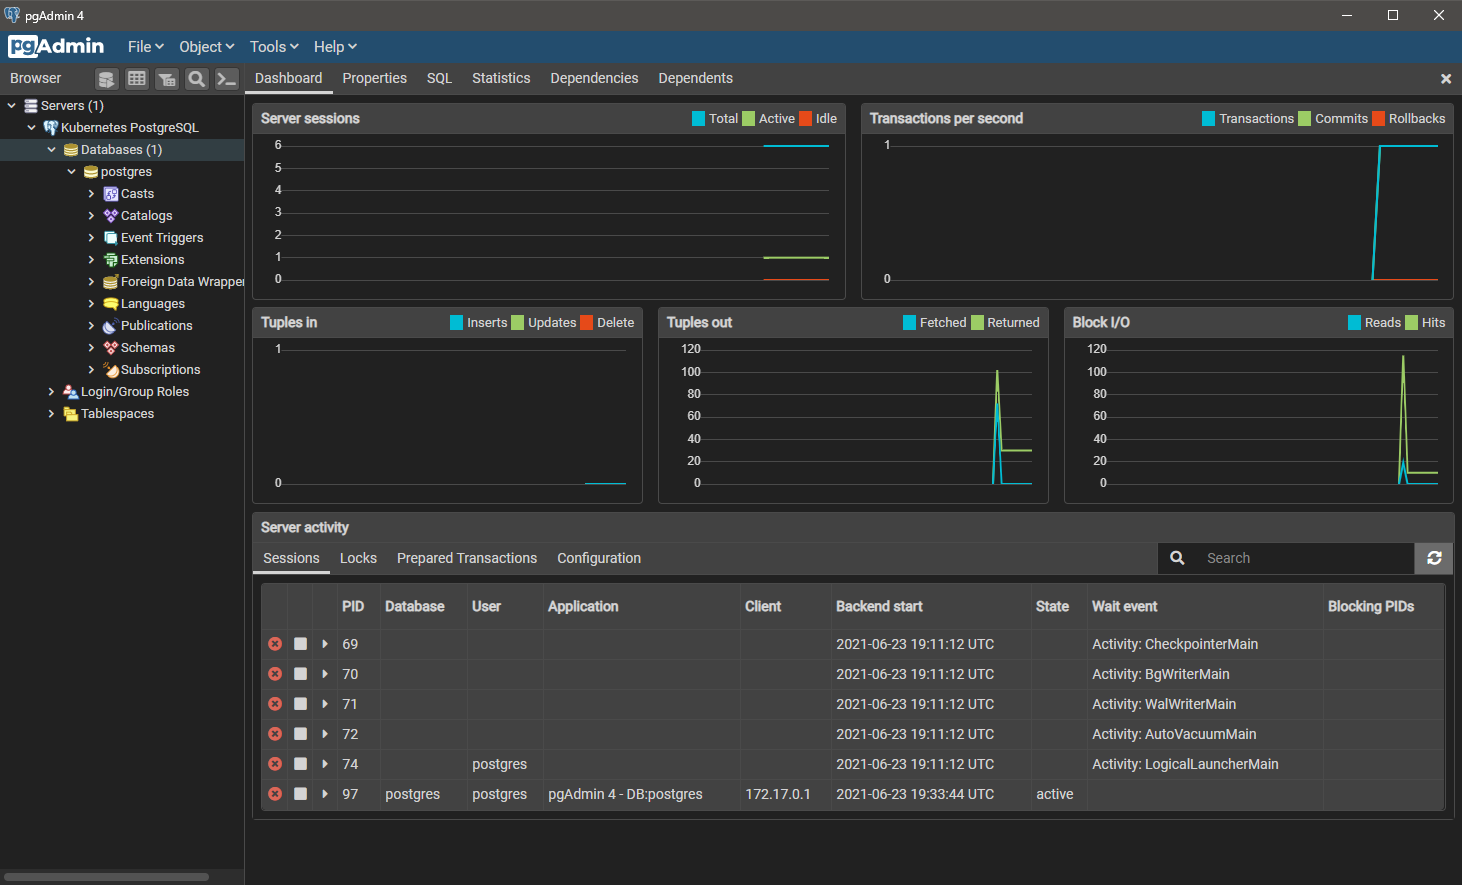
Wenn alle Details stimmen, wird die Verbindung initiiert, wenn Sie auf "Speichern" klicken, und der Benutzer kann die verbundene Datenbank sehen.
Verwendung von ConfigMap in StatefulSet
In unserem früheren Beispiel haben wir die Umweltvariablen mit dem StatefulSet YAML definiert.
Die beste Praxis wäre jedoch, die Umweltvariablen mit ConfigMaps zu trennen und die ConfigMap aus der StatefulSet-Bereitstellung aufzurufen. Das erleichtert die Verwaltung und Wartung jeder Komponente der Bereitstellung.
Also erstellen wir eine ConfigMap und ändern die StatefulSet-YAML wie unten gezeigt.
postgresql-configmap.yaml
    # PostgreSQL StatefulSet ConfigMap
apiVersion: v1
kind: ConfigMap
metadata:
  name: postgres-db-config
  labels:
    app: postgresql-db
data:
  POSTGRES_DB: testdb
  POSTGRES_USER: testdbuser
  POSTGRES_PASSWORD: testdbuserpassword
  PGDATA: /data/pgdata
In der obigen ConfigMap haben wir unsere Umgebungsvariable erweitert, um eine PostgreSQL-Datenbank, einen Benutzer, ein Passwort und einen Datenspeicher anzugeben. Jetzt erstellen wir die ConfigMap und sehen uns die Konfigurationen mit diesem Befehl an:
kubectl apply -f .postgresql-configmap.yaml
Ergebnis:

Wir können die Informationen der erstellten ConfigMap mit der Beschreibungsfunktion erhalten:
kubectl describe configmap postgres-db-config
Ergebnis:
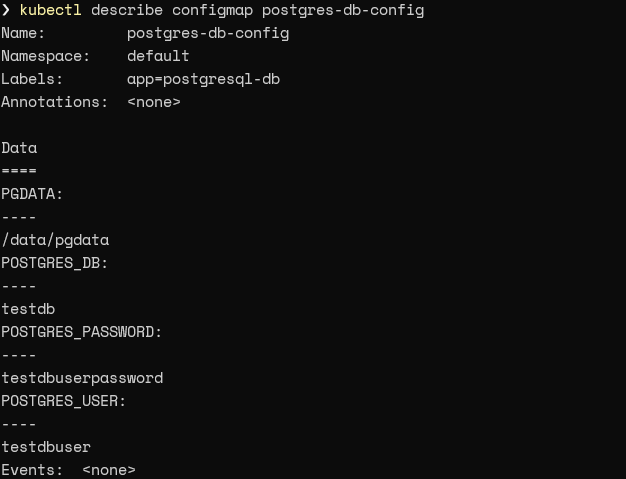
Der nächste Schritt ist, das StatefulSet so zu verändern, dass es die Daten aus der ConfigMap aufruft. Das kann durch Verwendung des envFrom-Feldes erreicht werden, um auf das obige ConfigMap zu verweisen. Dies ermöglicht uns auch, ein StatefulSet mit den Daten in der ConfigMap zu erstellen.
postgresql.yaml
    # PostgreSQL StatefulSet - ConfigMap
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: postgresql-db
spec:
  serviceName: postgresql-db-service
  selector:
    matchLabels:
      app: postgresql-db
  replicas: 2
  template:
    metadata:
      labels:
        app: postgresql-db
    spec:
      containers:
        - name: postgresql-db
          image: postgres:latest
          volumeMounts:
            - name: postgresql-db-disk
              mountPath: /data
          # Config from ConfigMap
          envFrom:
          - configMapRef:
              name: postgres-db-config
  # Volume Claim
  volumeClaimTemplates:
    - metadata:
        name: postgresql-db-disk
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 25Gi
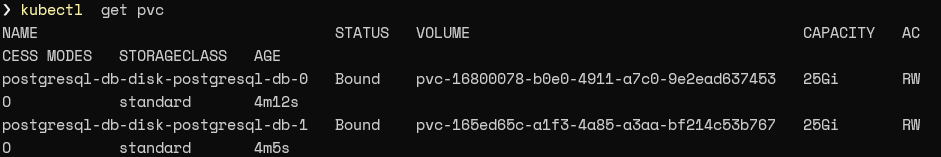
Mit unseren persistenten Volumes werden Löschungen in der zugrunde liegenden Datenbank auch im Falle von Pod-Fehlern erhalten. Als StatefulSet wird auch der Zustand der Pods erhalten, und sie werden bei der Wiederherstellung korrekt den gewünschten Volumes zugeordnet.
Wir können die Kapseln mit folgendem Befehl identifizieren:
kubectl get pvc
Ergebnis:
Die Zustandsverwaltung ist entscheidend für die Funktionalität der App
Kubernetes StatefulSets ermöglicht es Nutzern, stateful Anwendungen oder Dienste innerhalb eines Kubernetes-Clusters einfach zu erstellen und zu verwalten. Diese StatefulSets-Konfigurationen sind jedoch komplex – daher müssen Sie Ihre Deployments sorgfältig planen, bevor sie ausgeführt werden.
Darüber hinaus sind StatefulSets die ideale Lösung für den Umgang mit Datenbankanwendungen, Zahlungsdiensten usw., bei denen die Zustandsverwaltung ein entscheidender Teil der Anwendungsfunktionalität ist.
Kubernetes-Leitfaden
- Was ist Kubernetes (K8s)? Ein Tutorial zu den Grundlagen von Kubernetes
- Kubernetes Best Practices für verbesserte Cluster-Effizienz
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Kubernetes Pods: Eine Einführung
- Kubernetes ReplicaSets: Eine kurze Einführung
- Kubernetes-Deployments vollständig erklärt
- Wie man Kubernetes DaemonSets verwendet und verwaltet
- Wie Kubernetes-Dienste funktionieren
- Verwendung von Kubernetes Port, TargetPort und NodePort
- Erstellen und verwenden von ConfigMaps in Kubernetes
- Einführung in Kubernetes-Geheimnisse
- Kubernetes-Netzwerkgrundlagen
- Kubernetes-Ingress erklärt
- Einführung in Kubernetes Helm Charts
- Was ist das Kubernetes-Operator-Muster?
- Bereitstellung von PostgreSQL als StatefulSet in Kubernetes
- Kubernetes Custom Resource Definition (CRDs) erklärt
- 3 Kubernetes-Muster für Cloud-native Anwendungen
- Kubernetes Compute-Ressourcen erklärt
- Kubernetes-Sicherheit für DevOps-Pipelines
- Verwendung von Spinnaker mit Kubernetes für Continuous Delivery
- Kubernetes-Multi-Cluster: Wie und warum man sie verwendet.
- Kubernetes-Überwachung: Ein umfassender Leitfaden
- Kubernetes vs. Docker: Ein kurzer Vergleich
- Kubernetes vs. Docker Swarm: Vergleich von Container-Orchestrierungstools
- Kubernetes vs. OpenShift: Was ist der Unterschied?
- Kubernetes-Zertifizierungen: Wie und warum man zertifiziert wird
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.