





Auf einen Blick: Kubernetes-Dienste sind unerlässlich, um Anwendungen freizustellen und die Lastverteilung innerhalb von Clustern zu verwalten, indem sie stabile Endpunkte trotz dynamischer Pod-IP-Änderungen bieten. Sie unterstützen verschiedene Servicetypen, darunter ClusterIP, NodePort, LoadBalancer und ExternalName.
- Dienste können mit oder ohne Selektoren für flexible Pod-Verwaltung erstellt werden.
- Sie vereinfachen die Service-Entdeckung und überflüssig die Notwendigkeit separater Mechanismen.
Ein Kubernetes-Dienst ist eine logische Sammlung von Pods in einem Kubernetes-Cluster. Wir können einen K8s-Dienst als abstrakte Methode definieren, um die Lastverteilung zwischen den Pods zu verteilen und eine Anwendung auf einem Set von Pods bereitzustellen. Außerdem entfällt die Verwendung des integrierten Service-Mechanismus in Kubernetes die Implementierung eines separaten Service-Discovery-Mechanismus.
In diesem Artikel werden wir die Struktur eines Kubernetes-Dienstes und dessen Nutzung besprechen.
Was sind Kubernetes-Dienste?
Ein Kubernetes-Dienst kann verwendet werden, um eine auf einer Reihe von Pods installierte Anwendung mit einem einzigen Endpunkt einfach offenzulegen. Ein Dienst ist sowohl ein REST-Objekt als auch eine Abstraktion, die definiert:
- Ein Set von Pods
- Eine Richtlinie, um darauf zuzugreifen
Pods in einer Kubernetes-Bereitstellung werden regelmäßig erstellt und zerstört, wodurch sich ihre IP-Adressen ständig ändern. Das führt zu Auffindbarkeitsproblemen für die bereitgestellten Anwendung, was es dem Anwendungs-Frontend erschwert, zu erkennen, welche Pods verbunden werden sollen.
Hier kommen die Stärken von Kubernetes-Diensten ins Spiel: Dienste verfolgen die Änderungen der IP-Adressen und DNS-Namen der Pods und stellen sie dem Endnutzer als eine einzige IP oder DNS zur Verfügung.
Kubernetes-Dienste nutzen Selektoren, um eine Reihe von Pods anzusteuern:
- Für native Kubernetes-Anwendungen (die Kubernetes-APIs zur Service-Discovery verwenden) wird die Endpunkt-API aktualisiert, sobald Änderungen an den Pods im Service vorliegen.
- Nicht-native Anwendungen können virtuelle IP-basierte Bridge- oder Load-Balancer-Implementierungsmethoden von Kubernetes nutzen, um den Datenverkehr zu den Backend-Pods zu leiten.
Eigenschaften eines Kubernetes-Dienstes
Hier sind allgemeine Merkmale eines Dienstes:
- Einem Dienst wird eine IP-Adresse ("Cluster-IP") zugewiesen, die die Service-Proxys verwenden.
- Ein Dienst kann einen eingehenden Port auf jeden TargetPort abbilden. (Standardmäßig ist der TargetPort auf denselben Wert wie das Portfeld gesetzt und kann als Zeichenkette definiert werden.)
- Die Portnummer, die jedem Namen zugewiesen ist, kann in jedem Backend-Pod variieren. (Zum Beispiel können Sie die Portnummer, die Pods in der nächsten Version Ihrer Backend-Software offenlegen, ändern, ohne die Clients zu beschädigen.)
- Dienste unterstützen TCP (Standard), UDP und SCTP für Protokolle.
- Dienste können mit oder ohne Selektor definiert werden.
- Dienste unterstützen eine Vielzahl von Portdefinitionen
Schauen wir uns nun an, wie die Dienste funktionieren.
Definition eines Kubernetes-Dienstes
Wie oben erwähnt, können wir Kubernetes-Dienste mit oder ohne Selektoren definieren – machen wir beides!
Definition eines Dienstes mit einem Selektor
Im folgenden Beispiel haben wir einen einfachen Dienst definiert, der Port 80 im Service offenlegt, während er Port 8080 in den Pods mit dem Selektorlabel "app=webserver-nginx" anvisiert.
    apiVersion: v1
kind: Service
metadata:
  name: nginx-service
spec:
  selector:
    app: webserver-nginx
  ports:
    - protocol: TCP
      port: 80
      targetPort: 8080
Kubernetes weist automatisch eine IP-Adresse ("Cluster-IP") zu, die dann von Service-Proxys genutzt wird, um den Datenverkehr zu routen. Der Controller des Selektors überwacht konsequent Pods, die dem definierten Label entsprechen.
Einige Anwendungen erfordern, dass mehrere Ports über den Dienst bereitgestellt werden. Kubernetes ermöglicht dies durch Multi-Port-Services, bei denen ein Benutzer mehrere Ports in einem einzigen Service-Objekt definieren kann. Bei der Definition eines Multi-Port-Services besteht die Hauptanforderung darin, für jeden freigestellten Port Namen bereitzustellen, sodass sie eindeutig sind. Diese Portnamen können:
- Nur alphanumerische Zeichen und das Strichzeichen enthalten
- Sollte mit einem alphanumerischen Zeichen beginnen und enden.
In diesem Beispiel haben wir sowohl die Ports 80 als auch 443 den Zielports 8080 und 8090 zugänglich gemacht, um HTTP- und HTTPS-Verkehr mit dem Selektor "app=webserver-nginx-multiport" zu den zugrundeliegenden Pods zu leiten.
    apiVersion: v1
kind: Service
metadata:
  name: nginx-service
spec:
  selector:
    app: webserver-nginx-multiport
  ports:
    - name: http
      protocol: TCP
      port: 80
      targetPort: 8080
    - name: https
      protocol: TCP
      port: 443
      targetPort: 8090
Definition eines Dienstes ohne Selektor
Bei der Definition eines Dienstes ohne Selektor müssen Sie den Dienst manuell der entsprechenden IP-Adresse und dem entsprechenden Port zuordnen, indem Sie ein Endpoints-Objekt hinzufügen. Der Grund ist, dass die Endpunktobjekte nicht automatisch erstellt werden wie bei einem Selektor, da Kubernetes nicht weiß, mit welchen Pods der Dienst verbunden sein soll. Dienst:
    apiVersion: v1
kind: Service
metadata:
  name: nginx-service
  ports:
    - protocol: TCP
      port: 80
      targetPort: 8080
Endpunkt:
    apiVersion: v1
kind: Endpoints
metadata:
  name: nginx-service
subsets:
  - addresses:
      - ip: 192.10.0.1
    ports:
      - port: 8080
Bei der Definition eines Dienstes und des Endpunkts ist die Hauptüberlegung, dass sowohl der Name des Dienstes als auch des Endpunkts exakt übereinstimmen müssen.
Einige Anwendungsfälle für Dienste ohne Selektoren sind:
- Verbindung zu einem anderen Dienst in einem anderen Namespace oder einem anderen Cluster
- Kommunikation mit externen Diensten, Datenmigration, Testdienste, Deployments usw.
Erstellung eines Kubernetes-Dienstes
Da wir nun die Grundstruktur eines Kubernetes-Dienstes kennen, nehmen wir ein praktisches Beispiel, um besser zu verstehen, wie man einen Dienst erstellt. Zuerst erstellen wir eine kleine Bereitstellung mit vier Repliken eines Apache-Webservers.
apache-deployment.yaml
    apiVersion: apps/v1
kind: Deployment
metadata:
  name: apache-deployment
  labels:
    app: webserver
spec:
  replicas: 4
  selector:
    matchLabels:
      app: webserver
  template:
    metadata:
      labels:
        app: webserver
    spec:
      containers:
      - name: apache
        image: bitnami/apache:latest
        ports:
        - containerPort: 80
Erstellen Sie die Bereitstellung.
kubectl apply -f apache-deployment.yaml
Ergebnis:

Überprüfen Sie den Status des Einsatzes.
kubectl get deployment apache-deployment
Ergebnis:
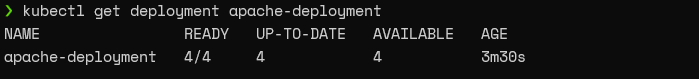
Jetzt haben wir die Anwendung auf dem Apache-Server bereitgestellt.
Als Nächstes erstellen wir einen Service, um auf unsere bereitgestellte Anwendung zuzugreifen. Dazu gibt es zwei Methoden:
- Erstellen Sie ein YAML-Manifest für einen Service
- Verwende den Befehl "kubectl expose"
Der Befehl Expose ermöglicht es den Nutzern, den Dienst direkt über die Kommandozeile zu erstellen.
Wir können den folgenden Befehl verwenden, um das "apache-deployment" mit dem ClusterIP-Servicetyp anzuzeigen. Wir werden den Service auf Port 8080 verweisen, da das "bitnami/apache"-Image Port 8080 als HTTP-Port verwendet.
kubectl expose deployment apache-deployment --name=apache-http-service --type=ClusterIP --port=8080 --target-port=8080
Ergebnis:
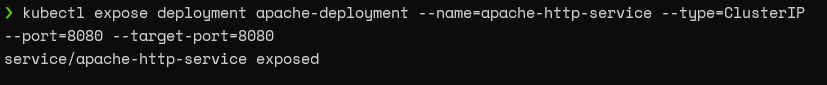
Überprüfen Sie, ob der Dienst korrekt erstellt wurde.
kubectl get service apache-http-service
Ergebnis:
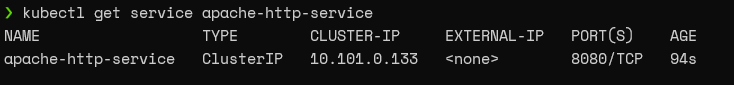
Jetzt müssen wir den Datenverkehr an den von uns erstellten Dienst weiterleiten, und wir können dafür den Befehl "kubectl port-forward" verwenden. Wir werden den Datenverkehr vom Host-Port 8090 zum Service-Port 8080 leiten.
kubectl port-forward service/apache-http-service 8090:8080
Ergebnis:
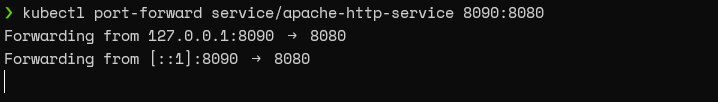
Wenn wir zum "http://localhost:8090" navigieren, werden wir zu einer Nginx-Landingpage wie der folgenden weitergeleitet.
Wir hätten auch einen Dienst mit einer YAML-Datei für das obige Szenario definieren können, wie unten gezeigt. Dort haben wir den Selektor als "app=Webserver" gesetzt.
    apiVersion: v1
kind: Service
metadata:
  name: apache-http-service
spec:
  selector:
    app: webserver
  ports:
    - protocol: TCP
      port: 8080
      targetPort: 8080
Arten von Kubernetes-Diensten
Es gibt vier Arten von Kubernetes-Diensten:
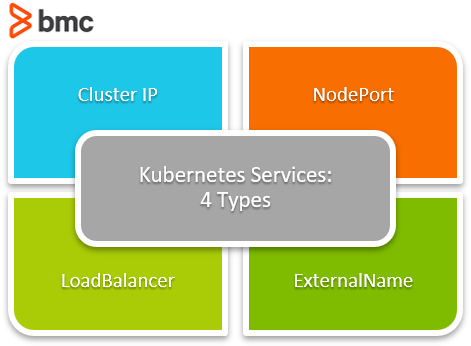
Dies ist der Standardtyp, der den Dienst auf einer internen IP des Clusters offenlegt. Diese Dienste sind nur innerhalb des Clusters zugänglich. Daher müssen Nutzer Port Forwarding oder einen Proxy implementieren, um eine ClusterIP einem breiteren Datenverkehr zugänglich zu machen.
Ein NodePort-Dienst stellt den Dienst auf der IP jedes Knotens an einem statischen Port frei. Ein ClusterIP-Dienst wird automatisch erstellt, um den Datenverkehr an den NordPort-Dienst weiterzuleiten. Nutzer können von außen mit dem Dienst kommunizieren, indem sie anfordern :
Dies ist die bevorzugte Lösung, um den Cluster dem weiteren Internet zugänglich zu machen. Der LoadBalancer-Typ von Service erstellt einen Load Balancer (der Load Balancer-Typ hängt vom Cloud-Anbieter ab) und stellt den Service extern zur Verfügung.
Es erstellt außerdem automatisch ClusterIP- und NodePort-Dienste und routet den Datenverkehr entsprechend.
Dieser Diensttyp ordnet den Service den Inhalt des externalName-Feldes (z.B.: app.test.com) zu. Dies geschieht, indem ein Wert für den CNAME-Datensatz zurückgegeben wird.
Implementierungen von Service-Proxys
Der kube-Proxy-Prozess implementiert eine Form virtueller IPs für alle Servicetypen, mit Ausnahme des ExternalName-Typs. Die Nutzung von Proxying für Services ermöglicht es Benutzern, einige DNS-Auflösungsprobleme zu mindern.
Wenn beispielsweise ein DNS-Datensatz abgelaufen ist, kann es vorherige DNS-Abfragen noch mit dem abgelaufenen Datensatz zwischengespeichert werden, was zu Lösungen führt. Ebenso kann es zu Lösungen führen, wenn DNS-Datensätze nicht richtig weitergeleitet werden.
Die folgenden drei Methoden können vom kube-Proxy zum Routing von Verkehr verwendet werden:
- Proxy-Modus: Benutzerraum
- Proxy-Modus: iptables
- Proxy-Modus: ipvs
Proxy-Modus: Benutzerraum
In diesem Modus überwacht kube-proxy den Kubernetes-Master, und wann immer ein Dienst oder Endpunkt erstellt oder entfernt wird, wird ein zufälliger Port am lokalen Knoten zugeteilt oder freigegeben.
Alle Verbindungen zu diesem "Proxy-Port" sind mit dem Dienst und den notwendigen Endpunkten verbunden.
Proxy-Modus: iptables
Dieser Modus überwacht auch den Kubernetes-Master auf Dienste und Endpunkte. Allerdings werden auch iptable-Regeln installiert, um den Datenverkehr zur ClusterIP des Dienstes und des Ports zu erfassen und den Datenverkehr dann umzuleiten.
Zusätzlich werden iptable-Regeln für Endpunktobjekte installiert, um den Backend-Pod auszuwählen, während das Standardverhalten darin besteht, ein zufälliges Backend auszuwählen. (Pod)
In diesem Modus überwacht der Kube-Proxy die Dienste und Endpunkte und ruft dann die Netlink-Schnittstelle auf, um entsprechende IPvS-Regeln (IP Virtual Server) zu erstellen. Dieser Modus synchronisiert die IPvVs-Regeln regelmäßig mit den Diensten und dem Endpunkt, um alles aktuell zu halten.
Entdeckung von Kubernetes-Diensten
Sie können zwei Methoden verwenden, um einen Dienst zu entdecken – DNS oder Environment Variable.
Dies ist die bevorzugte Methode zur Service-Discovery. Hier wird der DNS-Server dem Kubernetes-Cluster hinzugefügt, der die Kubernetes-API überwacht und für jeden neuen Dienst DNS-Datensätze erstellt. Wenn das DNS aktiviert ist, können clusterweit alle Pods die Namensauflösung der Dienste durchführen.
Umweltvariablen
Bei dieser Methode fügt Kubelet für jeden aktiven Service Umweltvariablen zu den Pods hinzu. Bei dieser Methode muss der gewünschte Service erstellt werden, bevor die Pods erstellt werden, die diesen Dienst nutzen werden. Andernfalls erhalten die Pods nicht die notwendigen Umgebungsvariablen für den gewünschten Service.
Wenn keine Lastverteilung und eine einzelne Dienst-IP erforderlich sind, können Nutzer einen headless Service erstellen, indem sie explizit "none" für das Cluster-IP-Feld angeben (.spec.clusterIP). Diese headless Services haben keine zugehörigen Cluster-IPs, und die Plattform bietet keine Lastverteilung oder Proxying für sie. Der Kube-Proxy ignoriert diese Services ebenfalls.
Die DNS-Konfiguration dieser Dienste hängt von den in den Diensten definierten Selektoren ab.
- Headless-Service mit Selektoren. Der Endpunkt-Controller erstellt die Endpunkt-Datensätze in der API und verändert den DNS-Datensatz, um einen A-Datensatz zurückzugeben, der auf die erforderlichen Pods verweist.
- Headless-Service ohne Selektoren. Der Endpunkt-Controller erstellt keine Endpunktdatensätze, ohne dass die Selektoren konfiguriert sind.
Zusammenfassung der K8s-Dienste
Damit haben wir alle Grundlagen von Kubernetes-Diensten abgedeckt. Wir kennen uns jetzt mit Diensten aus, einschließlich der verschiedenen Typen, der Service-Entdeckung und der Nutzung von Service-Proxys. Services sind ein integraler Bestandteil von Kubernetes und bieten Möglichkeiten, die Kommunikation zwischen Pods, externen Diensten und Nutzern zu erleichtern.
Kubernetes-Leitfaden
- Was ist Kubernetes (K8s)? Ein Tutorial zu den Grundlagen von Kubernetes
- Kubernetes Best Practices für verbesserte Cluster-Effizienz
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Kubernetes Pods: Eine Einführung
- Kubernetes ReplicaSets: Eine kurze Einführung
- Kubernetes-Deployments vollständig erklärt
- Wie man Kubernetes DaemonSets verwendet und verwaltet
- Wie Kubernetes-Dienste funktionieren
- Verwendung von Kubernetes Port, TargetPort und NodePort
- Erstellen und verwenden von ConfigMaps in Kubernetes
- Einführung in Kubernetes-Geheimnisse
- Kubernetes-Netzwerkgrundlagen
- Kubernetes-Ingress erklärt
- Einführung in Kubernetes Helm Charts
- Was ist das Kubernetes-Operator-Muster?
- Bereitstellung von PostgreSQL als StatefulSet in Kubernetes
- Kubernetes Custom Resource Definition (CRDs) erklärt
- 3 Kubernetes-Muster für Cloud-native Anwendungen
- Kubernetes Compute-Ressourcen erklärt
- Kubernetes-Sicherheit für DevOps-Pipelines
- Verwendung von Spinnaker mit Kubernetes für Continuous Delivery
- Kubernetes-Multi-Cluster: Wie und warum man sie verwendet.
- Kubernetes-Überwachung: Ein umfassender Leitfaden
- Kubernetes vs. Docker: Ein kurzer Vergleich
- Kubernetes vs. Docker Swarm: Vergleich von Container-Orchestrierungstools
- Kubernetes vs. OpenShift: Was ist der Unterschied?
- Kubernetes-Zertifizierungen: Wie und warum man zertifiziert wird
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.