





Auf einen Blick: Drei wesentliche Kubernetes-Muster verbessern die Skalierbarkeit und Zuverlässigkeit cloudnativer Anwendungen und konzentrieren sich auf grundlegende, verhaltensbezogene und strukturelle Aspekte des Anwendungsmanagements. Diese Muster leiten die Bereitstellung und Organisation von Anwendungen in einer Kubernetes-Umgebung.
- Das grundlegende Muster gewährleistet eine vorhersehbare Nachfrage und deklarative Einsätze.
- Das Verhaltensmuster legt den Schwerpunkt auf Pod-Management und Anwendungstypen.
- Structural Pattern organisiert Behälter in Pods mit Konzepten wie Sidecar und Ambassador.
Moderne cloud-native Anwendungen sind darauf ausgelegt, skalierbar, elastisch, zuverlässig und vorhersehbar zu sein. Um diese Eigenschaften zu erreichen, können bestimmte Prinzipien Administratoren oder Architekten beim Betrieb von Anwendungen in Kubernetes leiten.
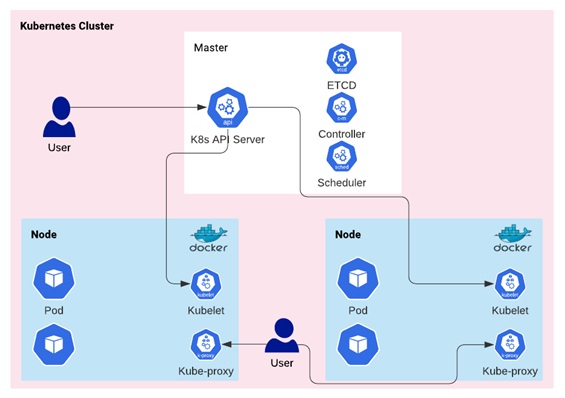
In diesem Artikel behandeln wir drei wichtige Muster, die man beim Betrieb einer cloudnativen Anwendung auf Kubernetes berücksichtigen sollte. Am Ende dieses Beitrags sollten Sie ein gutes Verständnis dafür haben, worauf Sie achten sollten, wenn Sie eine containerisierte Anwendung architektonieren , die innerhalb eines K8s-Clusters läuft.
Grundlegendes Muster
Das grundlegende Muster ist grundlegend für den Betrieb jeder containerbasierten Anwendung in einem Kubernetes-Cluster und dafür, dass sie als cloud-native gilt.
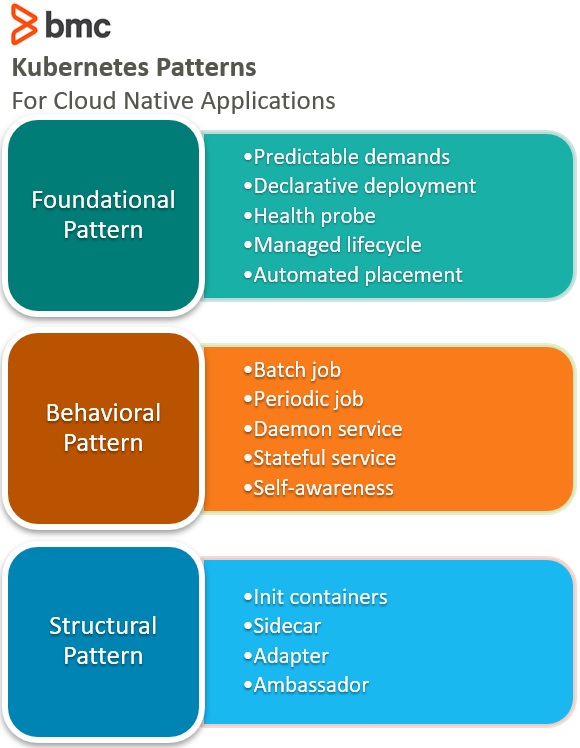
Es gibt fünf Bereiche, auf die man sich beim Arbeiten mit dem grundlegenden Muster konzentrieren sollte:
- Vorhersehbare Nachfrage
- Deklarativer Einsatz
- Gesundheitssonde
- Verwalteter Lebenszyklus
- Automatisierte Platzierung
Diese Konzepte decken das meiste ab, was du verstehen musst, um deine Anwendung in Kubernetes mit diesem Muster auszuführen.
Vorhersehbare Anforderungen
Das Verständnis von Anwendungsressourcen und Laufzeitabhängigkeit ist entscheidend, um jede Anwendung auf Kubernetes auszuführen. Um die Nachfrage der Anwendung vorhersagen zu können, müssen wir wissen:
- Die Laufzeitabhängigkeit (z. B. persistentes Volume oder ConfigMap)
- Das Anwendungsressourcenprofil, das das Setzen komprimierbarer Ressourcen (CPU) und unkomprimierbarer Ressourcen (Speicher) abdeckt
Deklarativer Einsatz
Die Automatisierung der Anwendungsbereitstellung ist ein weiterer entscheidender Bestandteil des Betriebs einer Cloud-nativen App auf Kubernetes. Dieses Prinzip ist nur mit der Nutzung der Bereitstellungs-Workload möglich, um deklarative Updates für Pods und Replikasets bereitzustellen. Ebenso wird erwartet, dass die containerisierten Anwendungen für die korrekte Erfüllung einer Bereitstellung gute cloud-native Bürger sind.
Im Kern einer Bereitstellung steht die Fähigkeit, eine Reihe von Pods vorhersehbar zu starten und zu stoppen. Damit dies wie erwartet funktioniert, hören die Container selbst in der Regel auf Lebenszyklusereignisse wie Sigmar und stellen zudem Gesundheitscheck-Endpunkte bereit, die anzeigen, ob sie erfolgreich gestartet sind.
Gesundheitssonde
Eine cloud-native Kubernetes-Anwendung muss beobachtbar sein. Das Konzept der Gesundheitsprobe konzentriert sich mehr darauf, wie die laufende Anwendung ihren Zustand an den Cluster kommunizieren sollte. Mit einer Kombination aus Prozess-Gesundheitscheck, Liveness-Probe und Readiness-Probe kann man schnell feststellen, ob die Anwendung gesund ist und wie man den Datenverkehr steuert.
Im Fall, in dem die Liveness-Probe ausfällt, wird der Container vollständig beendet, aber mit dem Ausfall der Readiness Probe wird der Container aus dem Service entfernt.
Verwalteter Lebenszyklus
Containerbasierte Anwendungen, die in k8s laufen, sollten auf bestimmte vom Cluster ausgesendete Lebenszyklusereignisse reagieren können. Zu verstehen, wie man Prozesssignale wie Sigterm und Sigkill (Force Kill nach 30 Sekunden), Poststart und Prestop-Hooks nutzen kann, ist wichtig.
- Poststart-Hook ist ein Blockierungsaufruf, der ausgeführt wird, wenn ein Container erstellt wird. Der Pod-Status ist ausstehend, bis der Poststart-Hook abgeschlossen ist, und wenn der Poststart-Hook fehlschlägt, wird der Containerprozess beendet.
- Prestop ist ein Blockierungsaufruf, der vor der Beendigung an einen Container gesendet wird, und ist besonders nützlich, um einen Container auf Grundlage der vom Cluster ausgesendeten Ereignisse elegant abzuschalten.
Automatisierte Platzierung
Zu verstehen, wie containerbasierte Anwendungen auf einem Kubernetes-Node verteilt werden, ist entscheidend für Leistung, Zuverlässigkeit und Automatisierung. Die Aufgabe eines Schedulers ist es, jede neu erstellte Pod-Definition vom API-Server abzurufen und sie einem Knoten zuzuweisen. So einfach ist es jedoch nicht – wir müssen sicherstellen, dass die Knotenkapazität Pod-Platzierungen basierend auf dem Container-Ressourcenprofil ermöglicht.
Wichtige Punkte bei automatisierten Platzierungen sind:
- Verfügbare Knotenressourcen
- Containerressourcenbedarf
- Vermittlungsrichtlinien
- Knotenaffinität, Pod-Affinität und Anti-Affinität
- Verunreinigungen und Toleranz
Verhaltensmuster
Die Konzepte im Verhaltensmuster konzentrieren sich auf die Pod-Management-Primitive und deren Verhaltensweisen. Es ist sehr wichtig zu wissen, wie man die Anwendung in einem Pod in einem Cluster ausführen möchte, je nach Anwendungsfall.
Zum Beispiel kannst du eine Anwendung in einem nackten Pod oder als Daemonset ausführen, das in jedem Knoten im Cluster einen einzelnen Pod ausführt.
Die im Verhaltensmuster behandelten Konzepte sind:
- Batch-Job
- Periodischer Auftrag
- Dämonendienst
- Staatlicher Dienst
- Selbstbewusstsein
Batch-Job
Dies wird verwendet, um kurzlebige Pods zuverlässig bis zum Abschluss zu betreiben. Das ist besonders nützlich, wenn man keinen lang laufenden Pod möchte, sondern einfach eine Aufgabe ausführen möchte, die bis zum Abschluss läuft, und den Pod beenden. Im Gegensatz zu anderen Pod-Primitiven starten Batch-Jobs Pods nicht neu, sobald sie abgeschlossen sind.
Periodischer Auftrag
Dies wird verwendet, um eine Arbeitseinheit auszuführen, die durch ein Ereignis oder zu einem bestimmten Zeitpunkt ausgelöst wird. Periodische Jobs werden mit dem Cronjob-Primitiv bereitgestellt, wobei man sich Cronjobs als eine Zeile eines Unix-Crontabs vorstellen kann. Der Unterschied zwischen Kubernetes-Cronjob und Unix-Cron besteht darin, dass Kubernetes Cronjob sehr verfügbar ist und sowohl zeit- als auch ereignisbasierte Ausführung ermöglicht. Dieser Ansatz ist nützlich, wenn Anwendungen eine bestimmte Aufgabe ausführen müssen, wie Dateiübertragung oder Abfragen eines anderen Services.
Dämonendienst
Im Allgemeinen sind Daemons Programme, die als Prozesse ohne Interaktion laufen. Da Kubernetes ein verteiltes System ist und darauf laufende Anwendungen ebenfalls von Natur aus verteilt sind, kann Daemonset genutzt werden, um Einblicke in den darauf laufenden Cluster oder die darauf laufende Anwendung zu geben, z. B. indem fluentd daemonset auf jedem Knoten ausgeführt wird, um Cluster-Logs zu sammeln.
Staatlicher Dienst
Dieses Konzept gilt für Anwendungen, die nicht stateless sind. Im Gegensatz zu einer typischen 12-Faktor-Anwendung , bei der die Anwendung beendet werden kann und bei jedem Problem neu gestartet werden kann, ist eine Stateful-Anwendung das Gegenteil. Sie ist hauptsächlich für Anwendungen gedacht, die den Status speichern müssen. Durch die Verwendung von Statefulset Workload können Sie persistente Identität, Netzwerk, Speicher und Ordinalität steuern, was beeinflusst, wie die Anwendung hoch- und herunterskaliert wird.
Selbstbewusstsein
In manchen Fällen müssen Anwendungen, die in Kubernetes laufen, bestimmte Informationen über sich selbst wissen; genau das löst das Selbstbewusstseinskonzept mit der Downward API. Es bietet eine einfache Möglichkeit für Introspektion und Metadaten-Injektion in Anwendungen, die in Kubernetes laufen. Die Downward API ermöglicht es, Metadaten über den Pod über Umgebungsvariablen (z. B. POD_IP) oder Dateien an die Container und den Cluster weiterzugeben.
Die Fähigkeit einer Anwendung, sich ihrer Umgebung bewusst zu sein, ist kraftvoll, wenn man bedenkt, wie verteilt Kubernetes von Natur aus ist.
Strukturelles Muster
Dieses Muster ist eines der wichtigsten Muster, die man beim Betrieb einer verteilten Cloud-nativen Anwendung auf Kubernetes verstehen sollte. Das Hauptziel des strukturellen Musters ist es, zu verstehen, wie man Container in einem Pod organisiert, um verschiedene Anwendungsfälle zu lösen.
Der Kern dieses Musters basiert auf einem Modell der einzelnen Verantwortung, bei dem Container nur eine Aufgabe ausführen sollten. Wenn mehr als eine einzelne Aufgabe ausgeführt werden muss, sollte es einen zweiten Container geben, der die zweite Aufgabe ausführt.
Um dieses Muster umzusetzen, gibt es je nach Anwendungsfall vier Bereiche, auf die man sich konzentrieren sollte:
- Init-Container
- Seitenwagen
- Adapter
- Botschafter
Init-Container
Die Trennung von initialisierungsbezogenen Aufgaben vom Anwendungsstart ist der Hauptfokus von Init-Containern. Zum Beispiel die Möglichkeit, das Datenbankschema vor dem Start der Anwendung einzurichten.
Dieses Konzept erlaubt es, zwei Sets von Containern in einem einzigen Pod auszuführen – die Init-Container und die Anwendungscontainer. Der einzige Unterschied besteht darin, dass Anwendungscontainer parallel laufen, während Init-Container sequentiell laufen. Der Vorteil davon ist, dass Sie sicher sein können, dass die Initialisierung erfolgreich abgeschlossen wird, bevor die Anwendung startet.
Es gibt auch keine Bereitschaftsprüfung für Init-Container, was wichtig ist.
Seitenwagen
Im Gegensatz zu init-Containern, deren Aufgabe es nur ist, die Anwendungscontainer beim Start zu initialisieren, ermöglichen Sidecar-Container uns, die Funktionalität eines bestehenden Containers zu erweitern, ohne den Container zu verändern. Dieses Muster ermöglicht es Einzelzweckcontainern, in einem verteilten System wie Kubernetes eng zusammenzuarbeiten.
Ein Beispiel für dieses Konzept ist ein Pod mit zwei Containern, wobei einer ein HTTP-Server ist und ein anderer die Datei herunterzieht, die der HTTP-Container bedient, vielleicht aus s3, Storage Bucket oder git. Das Verhalten des HTTP-Containers wird nun durch den anderen Container verbessert.
Adapter
Dies ist eine Variante des oben genannten Sidecar und wird verwendet, um Situationen zu lösen, in denen alle Container, die in einem Anwendungspod laufen, einheitlich freigestellt werden müssen.
Zum Beispiel haben wir einen Pod mit drei Containern, bei dem zwei Container als Anwendung zusammenarbeiten und der letzte Container, der Adapter, die Logs der beiden Anwendungscontainer auf einheitliche Weise parset und formatiert, damit ein Drittanbieter-Tool sie konsumieren kann. Die Hauptcontainer könnten in zwei Sprachen geschrieben sein, aber ihre Logs werden trotzdem auf die gleiche Weise präsentiert, wie andere Tools sie verstehen können.
Botschafter
Dies ist eine weitere Variante des Sidecar-Konzepts. Es gibt Situationen, in denen Ihre containerisierte Anwendung in einem Pod laufen muss, um mit externen Diensten außerhalb des Pods zu kommunizieren. Hier kommt das Ambassador-Konzept ins Spiel. Es fungiert als Proxy und nimmt die Verantwortung des Hauptapplikationscontainers weg, einen externen Dienst direkt zu kontaktieren.
Zum Beispiel eine Situation, in der eine Anwendung einen externen Datenspeicher oder Cache abfragen muss. In diesem Fall trifft eine Anfrage den Hauptapplikationscontainer, der die Anfrage an den Botschaftercontainer sendet, der die Anfrage an die externe Quelle weiterleitet.
Nützliche Kubernetes-Muster
Die oben genannten Muster und Überlegungen sind gute Muster, über die man beim Architekten und Betrieb verteilter Cloud-nativer Anwendungen in Kubernetes nachdenken sollte, um Skalierbarkeit, Elastizität, Zuverlässigkeit und Vorhersehbarkeit zu erreichen.
Zusätzliche Ressourcen
Für mehr Informationen zu Kubernetes entdecken Sie diese Ressourcen:
- Kubernetes-Leitfaden mit 20+ Artikeln und Tutorials
- BMC DevOps Blog
- Bring Kubernetes in die serverlose Partei
- Wie eBay sein IT-Programm mit Kubernetes & Replatforming neu erfindet

Kubernetes-Leitfaden
- Was ist Kubernetes (K8s)? Ein Tutorial zu den Grundlagen von Kubernetes
- Kubernetes Best Practices für verbesserte Cluster-Effizienz
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Kubernetes Pods: Eine Einführung
- Kubernetes ReplicaSets: Eine kurze Einführung
- Kubernetes-Deployments vollständig erklärt
- Wie man Kubernetes DaemonSets verwendet und verwaltet
- Wie Kubernetes-Dienste funktionieren
- Verwendung von Kubernetes Port, TargetPort und NodePort
- Erstellen und verwenden von ConfigMaps in Kubernetes
- Einführung in Kubernetes-Geheimnisse
- Kubernetes-Netzwerkgrundlagen
- Kubernetes-Ingress erklärt
- Einführung in Kubernetes Helm Charts
- Was ist das Kubernetes-Operator-Muster?
- Bereitstellung von PostgreSQL als StatefulSet in Kubernetes
- Kubernetes Custom Resource Definition (CRDs) erklärt
- 3 Kubernetes-Muster für Cloud-native Anwendungen
- Kubernetes Compute-Ressourcen erklärt
- Kubernetes-Sicherheit für DevOps-Pipelines
- Verwendung von Spinnaker mit Kubernetes für Continuous Delivery
- Kubernetes-Multi-Cluster: Wie und warum man sie verwendet.
- Kubernetes-Überwachung: Ein umfassender Leitfaden
- Kubernetes vs. Docker: Ein kurzer Vergleich
- Kubernetes vs. Docker Swarm: Vergleich von Container-Orchestrierungstools
- Kubernetes vs. OpenShift: Was ist der Unterschied?
- Kubernetes-Zertifizierungen: Wie und warum man zertifiziert wird
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.