





Auf einen Blick: Kubernetes-Deployments ermöglichen deklarative Updates zur Verwaltung von Pods und ReplicaSets und ermöglichen so nahtlose Anwendungsupdates ohne Ausfallzeiten. Sie ermöglichen es den Nutzern, Deployments effizient zu skalieren, zurückzurollen und zu verwalten.
- Das Deployment-Management umfasst Schlüsselbefehle wie kubectl apply, scale und rollout.
- Benutzer können Deployments einfach pausieren, fortsetzen und zurückrollen, um die Anwendungsstabilität zu gewährleisten.
Kubernetes-Deployment ist der Prozess, bei dem deklarative Updates für Pods und ReplicaSets bereitgestellt werden. Sie ermöglicht es Nutzern, den gewünschten Zustand in der Manifest-Datei (YAML) zu deklarieren, und der Controller ändert den aktuellen Zustand in den deklarierten Zustand. Schauen wir uns also an, wie man Kubernetes-Deployments erstellt und nutzt. Ich führe Sie durch die Nutzung von Kubernetes-Deployments, um den Deployment-Prozess zu vereinfachen sowie Deployments zu verwalten, zu skalieren und zurückzurollen. Für diesen Artikel verwenden wir einen lokal bereitgestellten Kubernetes-Cluster in einer Windows-Umgebung, der das Windows Subsystem for Linux (WSL) nutzt.
Erstellung einer Kubernetes-Bereitstellung
Erstellen wir zunächst eine einfache Nginx-Bereitstellung mit vier Repliken. Wie jede andere Kubernetes-Konfiguration enthält eine Bereitstellungsdatei:
- apiVersion (apps/v1)
- Kind (Einsatz)
- Die Metadaten mit einem Spezifikationsabschnitt definieren die Replikate und Konfigurationen im Zusammenhang mit der Bereitstellung
nginx-deployment.yaml
    apiVersion: apps/v1
kind: Deployment
metadata:
  # Define the Deployment Name
  name: nginx-deployment
  labels:
    app: webserver
spec:
  # Define the Number of Pods
  replicas: 4
  # Define the Selector
  selector:
    matchLabels:
      app: webserver
  template:
    metadata:
      labels:
        app: webserver
    spec:
      containers: # Container Details
      - name: nginx
        image: nginx:latest # Image
        ports:
        - containerPort: 80
Wir können die Bereitstellung mit folgendem Befehl erstellen. Wir haben das --record-Flag hinzugefügt, um den Befehl zu speichern.
kubectl apply -f nginx-deployment.yaml --record
Ergebnis:

Wir haben die folgenden Einträge in den Metadaten- und Spezifikationsabschnitten der obigen Bereitstellungsdatei definiert.
- Der Bereitstellungsname und ein Label (App: Webserver).
- Die Anzahl der Repliken (Pods), der Selektor, in dem der Controller die Zielpods auswählt. (Das Label wird verwendet, um die notwendigen Pods über das Feld matchLabels auszuwählen.) Der Template-Abschnitt enthält die eigentliche Vorlage für die Pod. Dieser Abschnitt definiert die Metadaten, die jeder Pod mit den Spezifikationen hat (Containerdefinition). In diesem Fall haben wir das Nginx-Image und den Containerport als 80 definiert.
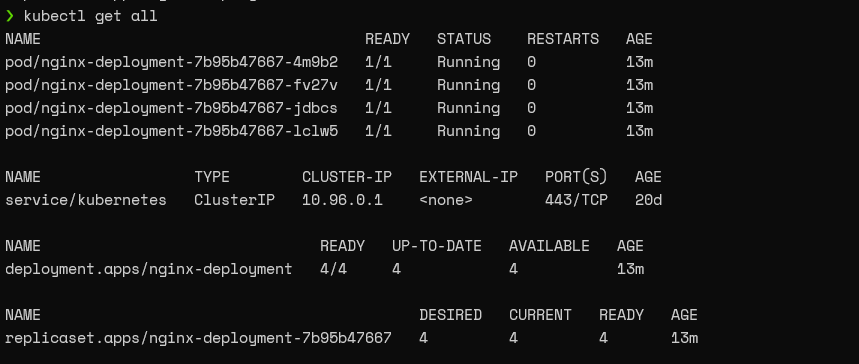
Wenn wir den Kubernetes-Cluster nach einiger Zeit überprüfen, sehen wir, dass die Pods mit der vorgegebenen Vorlage bereitgestellt sind. Zusätzlich können wir Details der Bereitstellung mit dem Beschreibefehl abrufen.
kubectl get all
Ergebnis:
kubectl describe deployment nginx-deployment
Ergebnis:

Bereitstellung des ReplicaSet
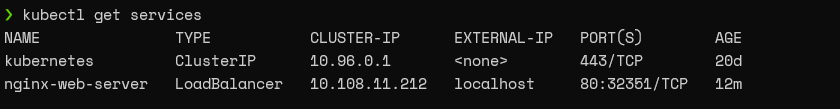
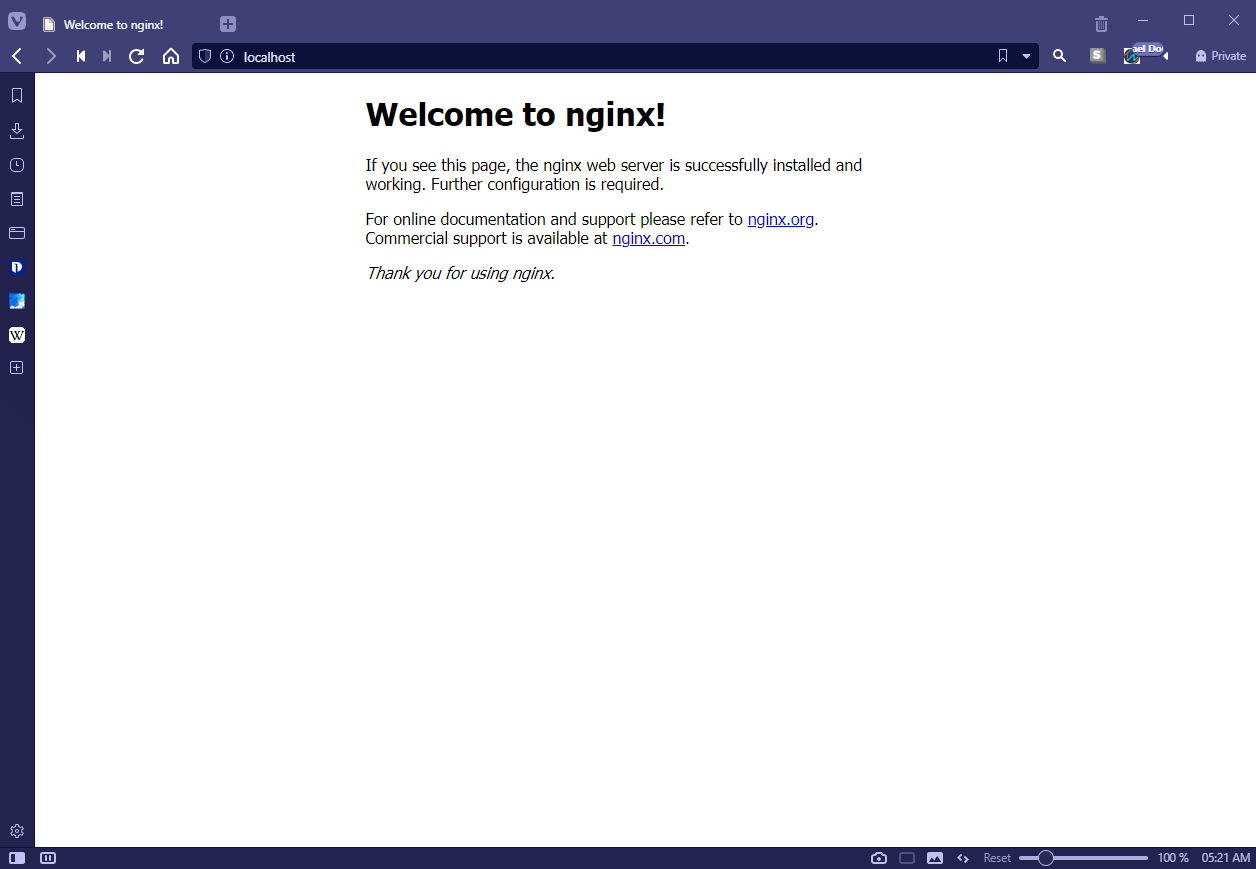
Jetzt haben wir eine Bereitstellung erstellt und müssen überprüfen, ob die Nginx-Webserver korrekt bereitgestellt wurden. Der einfache Weg dazu ist, ein Service-Objekt zu erstellen, das die Bereitstellung offenlegt. Ein wichtiger Punkt ist, dass die Art und Weise, wie wir die Bereitstellung und die Parameter offenlegen, je nach Konfiguration des Kubernetes-Clusters variieren können.
kubectl expose deployment nginx-deployment --type=LoadBalancer --name=nginx-web-server
Ergebnis:

kubectl get services
Ergebnis:
Dann können wir zum Localhost-Port 80 navigieren, um zu prüfen, ob wir die Standard-Nginx-Server-Landingpage wie unten sehen.
Entdeckung der Details zur Kubernetes-Bereitstellung
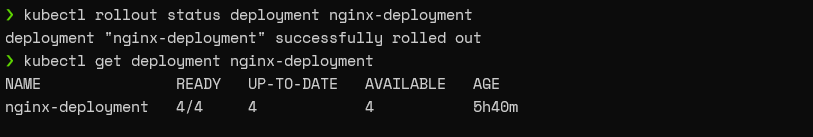
Beim Management eines Kubernetes-Clusters besteht der erste Schritt darin, eine erfolgreiche Bereitstellung zu überprüfen. Dafür können wir die Befehle kubectl rollout status und kubectl get deployment verwenden.
- Der Rollout-Status von kubectl informiert den Nutzer, ob die Bereitstellung erfolgreich war.
- kubectl get deployment zeigt die gewünschte und aktualisierte Anzahl der Replikate, die Anzahl der laufenden Repliken und deren Verfügbarkeit. Wie bereits erwähnt, können wir den Befehl kubectl describe verwenden, um ein vollständiges Bild der Bereitstellung zu erhalten.
    kubectl rollout status deployment nginx-deployment
kubectl get deployment nginx-deployment
Ergebnis:
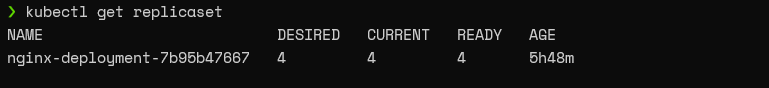
Wir können Informationen über die während der Bereitstellung erstellten ReplicaSets mit dem Befehl kubectl get ReplicaSet abrufen. Standardmäßig fügt Kubernetes automatisch einen pod-template-hash-Wert dem Namen ReplicaSet hinzu. Umbenenne das ReplicaSet jedoch nicht, da dies die Bereitstellung stören würde.
kubectl get replicaset
Ergebnis:
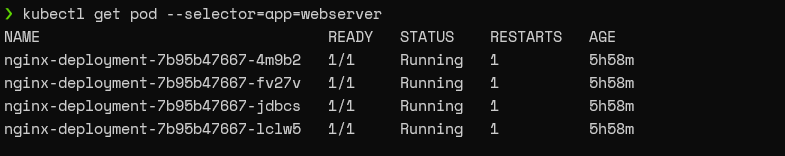
Der Befehl kubectl get pod kann verwendet werden, um nur die Informationen über die Pods im Zusammenhang mit der Bereitstellung zu erhalten, während ein Selektor definiert wird. In diesem Fall verwenden wir das Label "app:webserver" als Selektor.
kubectl get pod --selector=app=webserver
Ergebnis:
Verwaltung von Kubernetes-Deployments
Jetzt wissen wir, wie man eine Bereitstellung erstellt und Informationen über diese Bereitstellung abruft. Der nächste Schritt ist die Verwaltung der Bereitstellung. Was Bereitstellungen von einem einfachen ReplicaSet unterscheidet, ist, dass Bereitstellungen es den Nutzern ermöglichen, die Pods (Pod-Vorlagen) zu aktualisieren, ohne die zugrundeliegende Anwendung zu unterbrechen.
Durchführung eines rollierenden Updates bei einer Bereitstellung
Nehmen wir an, wir müssen die Nginx-Serverversion in unserer Bereitstellung so ändern, dass unsere Anwendung auf eine bestimmte Serverversion ausgerichtet ist. Wir können dies tun, indem wir entweder:
- Verwendung des Befehls kubectl set image
- Änderung der Bereitstellungskonfigurationsdatei
Verwendung des Befehls Set Image
Der Befehl Set Image kann mit dem Containernamen der Vorlage und dem erforderlichen Bildnamen zum Aktualisieren der Pods verwendet werden.
kubectl set image deployment nginx-deployment nginx=nginx:1.19.10
Ergebnis:

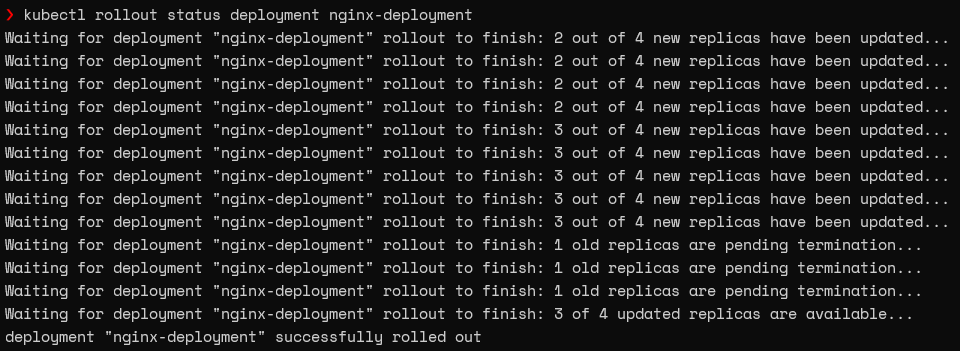
Wir bekommen den Rollout-Prozess, wenn wir sofort den Befehl get rollout status ausführen.
kubectl rollout status deployment nginx-deployment
Ergebnis:
Änderung der Bereitstellungskonfigurationsdatei
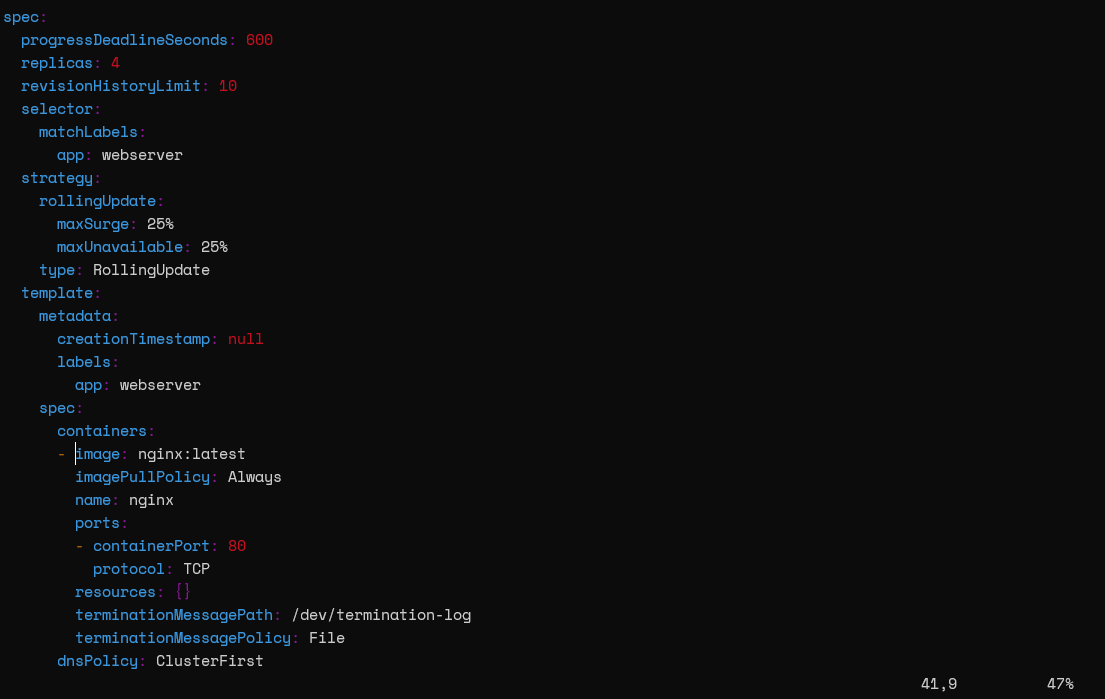
Wir können den Befehl 'Edit Deployment' verwenden, um die Konfigurationsdatei zu bearbeiten. Navigiere im entsprechenden Abschnitt (Container-Image) und mache die notwendigen Änderungen. Kubernetes startet den Prozess der Aktualisierung der Pods, sobald wir die neue Konfiguration speichern.
kubectl edit deployment nginx-deployment
Bereitstellungs-Bearbeitungsansicht (nginx-deployment):
Einsatzstrategien
Kubernetes verwendet zwei Bereitstellungsstrategien namens "Recreate" und "RollingUpdate", um Pods neu zu erstellen. Wir können diese Strategien im Feld .spec.strategy.type definieren. Die RollingUpdate-Strategie ist der Standard für Deployments.
- Recreate löscht alle bestehenden Pods, bevor die neuen Pods erstellt werden.
- RollingUpdate erstellt die Pods im laufenden Update-Modus. Außerdem löscht und erstellt es die Pods schrittweise, ohne die Anwendungsverfügbarkeit zu unterbrechen. Diese Strategie nutzt die maxUnavailable- und maxSurge-Werte, um den laufenden Aktualisierungsprozess zu steuern.
- maxUnavailable definiert die maximale Anzahl der Pods, die im Update-Prozess nicht verfügbar sein können.
- maxSurge definiert die maximale Anzahl der Pods, die erstellt werden können.
In unserer Bereitstellung haben wir keine explizit definierte Strategie, sodass Kubernetes die Standardstrategie RollingUpdate verwendet. Wir können den Beschreibefehl verwenden, um die aktuelle Strategie für die Bereitstellung zu überprüfen.
kubectl describe deployment nginx-deployment | grep Strategy
Ergebnis:
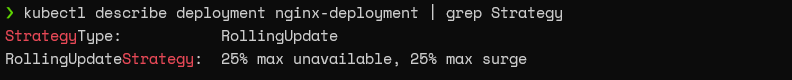
Aus den obigen Ausgaben können wir erkennen, dass die Standardkonfigurationen für die RollingUpdate-Strategie 25 % für maximal nicht verfügbar und 25 % für maximale Übergangswerte sind. Wir erstellen vier Repliken in unserer Konfiguration. Laut der obigen Konfiguration wird im Update-Prozess ein einzelner Pod zerstört, während ein einzelner Pod erstellt wird (25 % von 4 sind 1). Wir können die Ereignisse in der Bereitstellung mit dem Beschreibefehl ansehen, um den Aktualisierungsprozess besser zu verstehen.
kubectl describe deployment nginx-deployment
Ergebnis:
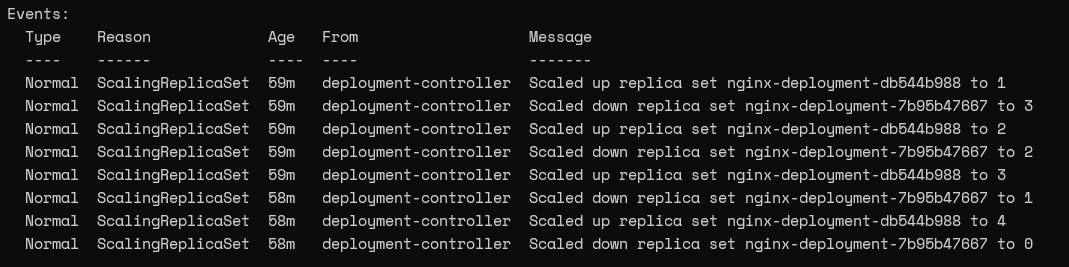
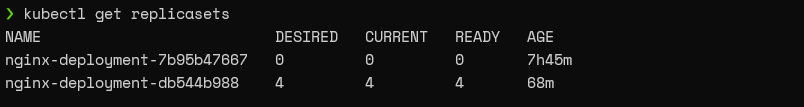
Wenn wir uns das aktuelle ReplicaSet ansehen, sehen wir, dass es vier Pods hat, während das alte ReplicaSet keine Pods enthält.
kubectl get replicasets
Ergebnis:
Pausieren und Fortsetzen von Bereitstellungen
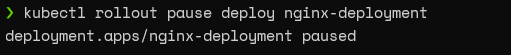
Kubernetes-Deployments bieten die Möglichkeit, Deployments zu pausieren und fortzusetzen. Dies ermöglicht es Benutzern, Probleme zu ändern und zu beheben, ohne einen neuen ReplicaSet-Rollout auszulösen. Wir können den Befehl "rollout pause deploy" verwenden, um die Deployment zu pausieren.
kubectl rollout pause deploy nginx-deployment
Ergebnis:
Wenn wir nun das Nginx-Image im pausierten Status aktualisieren, akzeptiert der Controller die Änderung, löst aber nicht den neuen ReplicaSet-Rollout aus. Wenn wir uns den Rollout-Status ansehen, zeigt er eine ausstehende Änderung an.
    kubectl set image deployment nginx-deployment nginx=nginx:1.20 --record
kubectl rollout status deployment nginx-deployment
Ergebnis:

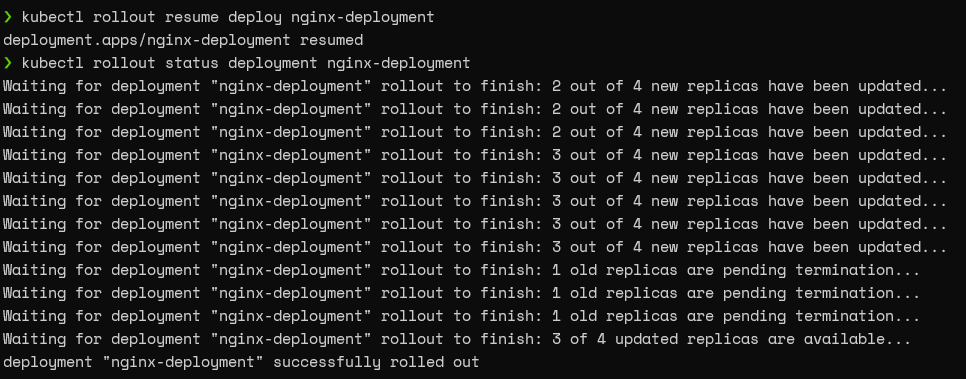
Du kannst einfach den Befehl "rollout resume resume deploy" ausführen, um die Deployment fortzusetzen.
    kubectl rollout resume deploy nginx-deployment
kubectl rollout status deployment nginx-deployment
Ergebnis:
Skalierung von Bereitstellungen
Da die Deployments auf ReplicaSets zur Verwaltung der Pods angewiesen sind, können wir die Anzahl der Pods erhöhen oder verkleinern. Diese Skalierung kann entweder erfolgen:
- Manuell
- Durch die Konfiguration einer Auto-Skalierungsregel
Manuelle Skalierung
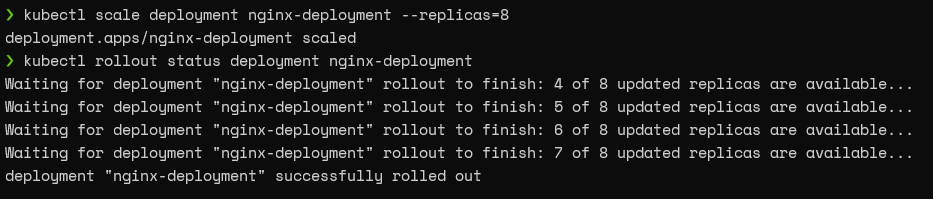
Wir können den Skalierungsbefehl mit dem Replik-Parameter verwenden, um die Deployment auf die gewünschte Anzahl zu skalieren. Zum Beispiel verwenden wir folgenden Befehl, um unsere Deployment von 4 auf 8 Pods zu skalieren.
    kubectl scale deployment nginx-deployment --replicas=8
kubectl rollout status deployment nginx-deployment
Ergebnis:
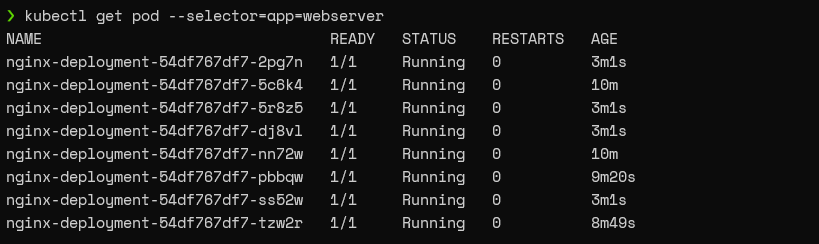
Wenn wir uns die Pods ansehen, die mit dieser Deployment verbunden sind, sehen wir, dass es jetzt acht Pods gibt.
kubectl get pod --selector=app=webserver
Ergebnis:
Autoskalierung
Die beste Vorgehensweise für Skalierungen von Deployments wäre, eine Auto-Skalierungsregel so zu konfigurieren, dass die Pods entsprechend vordefinierten Schwellenwerten skalieren. Lassen Sie uns also eine Autoskalierungsregel für unsere Bereitstellung erstellen, die entsprechend der CPU-Last des Knotens skaliert.
kubectl autoscale deployment nginx-deployment --min=5 --max=10 --cpu-percent=70
Ergebnis:

Gemäß der obigen Konfiguration skaliert die Bereitstellung bei einer CPU-Last von mehr als 70 %, bis die maximale Anzahl an Pods erreicht ist (maximal zehn Pods). Andererseits wird sie schrittweise reduziert, bis es fünf Pods (mindestens fünf Pods) gibt, wenn die Last reduziert ist.
Zurückrollen einer Deployment
Kubernetes unterstützt außerdem das Zurückrollen von Deployments auf die vorherige Version. Dies ist eine entscheidende Funktion, die es den Nutzern ermöglicht, Änderungen in der Bereitstellung rückgängig zu machen. Wenn zum Beispiel ein kritischer Produktionsfehler im Cluster bereitgestellt wurde, können wir die Bereitstellung einfach problemlos auf die vorherige Version zurücksetzen, ohne Ausfallzeit, bis der Fehler behoben ist. Nehmen wir an, wir haben unsere Konfiguration mit einem falschen Image aktualisiert. (In diesem Beispiel werden wir den Caddy-Webserver verwenden.)
kubectl set image deployment nginx-deployment nginx=caddy:latest --record
Ergebnis:

Hier kommt die History-Funktion des Deployment-Controllers ins Spiel. Der Controller verfolgt alle Änderungen an der Pod-Vorlage und speichert sie in der Historie. Wenn wir das Record-Flag in einem Befehl angeben, wird dies im Verlauf widergespiegelt.
kubectl rollout history deployment nginx-deployment
Ergebnis:
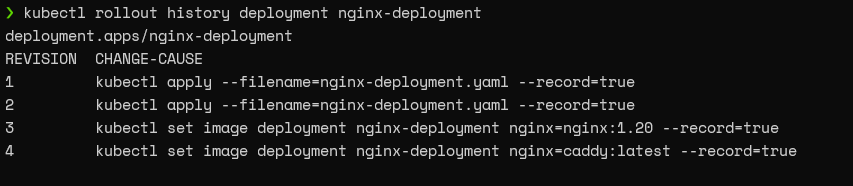
Wir können die Versionsnummer verwenden, um den Deployment-Controller zu informieren, unsere Deployment auf die vorherige Version zurückzusetzen. Zuerst überprüfen wir, ob die Version, die wir zurückrollen wollen, die richtige ist. Hier versuchen wir, zur dritten Version zurückzurollen. Geben Sie einfach die Version im History-Befehl an, um die Details der angegebenen Version zu erhalten.
kubectl rollout history deployment nginx-deployment --revision=3
Ergebnis:
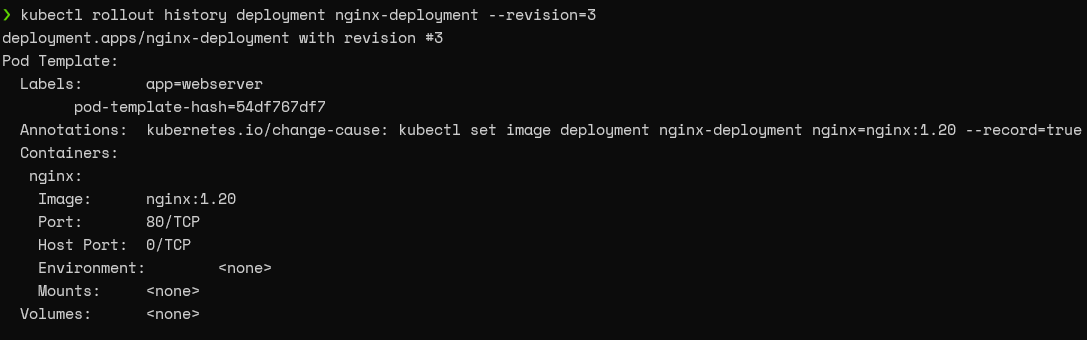
Nach Bestätigung der Revision können wir den Befehl "kubectl rollout undo" mit dem Parameter "to-revision" verwenden, um die Bereitstellung zurückzurollen.
    kubectl rollout undo deployment nginx-deployment --to-revision=3
kubectl rollout status deployment nginx-deployment
Ergebnis:
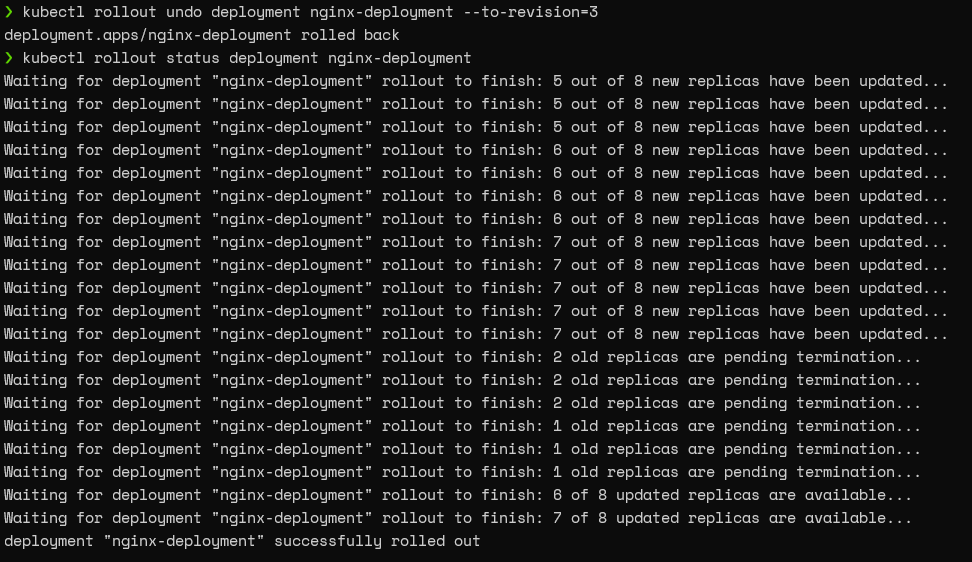
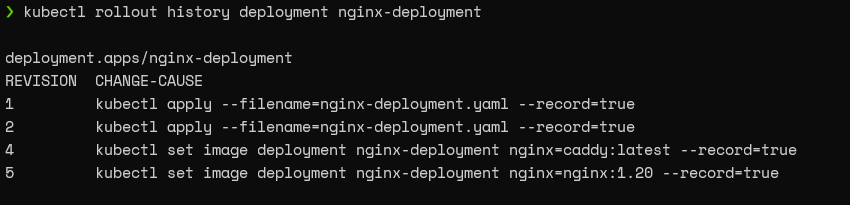
Das war's! Jetzt haben wir die Bereitstellung erfolgreich zurückgesetzt. Nach dem Rollback können wir die dritte Version nicht mehr sehen, da wir sie als aktuelle Konfiguration bereitgestellt haben. Allerdings werden wir einen neuen Datensatz mit einer höheren Versionsnummer für die neu zurückgesetzte Bereitstellung sehen können.
kubectl rollout history deployment nginx-deployment
Ergebnis:
Zusammenfassung der K8s-Einsätze
In diesem Artikel haben wir nur an der Oberfläche der Fähigkeiten von Kubernetes-Deployments gekratzt. Nutzer können robustere containerisierte Anwendungen erstellen, die jedem Bedarf entsprechen, indem sie Deployments mit allen anderen Kubernetes-Funktionen kombinieren.
Verwandte Literatur
Kubernetes-Leitfaden
- Was ist Kubernetes (K8s)? Ein Tutorial zu den Grundlagen von Kubernetes
- Kubernetes Best Practices für verbesserte Cluster-Effizienz
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Kubernetes Pods: Eine Einführung
- Kubernetes ReplicaSets: Eine kurze Einführung
- Kubernetes-Deployments vollständig erklärt
- Wie man Kubernetes DaemonSets verwendet und verwaltet
- Wie Kubernetes-Dienste funktionieren
- Verwendung von Kubernetes Port, TargetPort und NodePort
- Erstellen und verwenden von ConfigMaps in Kubernetes
- Einführung in Kubernetes-Geheimnisse
- Kubernetes-Netzwerkgrundlagen
- Kubernetes-Ingress erklärt
- Einführung in Kubernetes Helm Charts
- Was ist das Kubernetes-Operator-Muster?
- Bereitstellung von PostgreSQL als StatefulSet in Kubernetes
- Kubernetes Custom Resource Definition (CRDs) erklärt
- 3 Kubernetes-Muster für Cloud-native Anwendungen
- Kubernetes Compute-Ressourcen erklärt
- Kubernetes-Sicherheit für DevOps-Pipelines
- Verwendung von Spinnaker mit Kubernetes für Continuous Delivery
- Kubernetes-Multi-Cluster: Wie und warum man sie verwendet.
- Kubernetes-Überwachung: Ein umfassender Leitfaden
- Kubernetes vs. Docker: Ein kurzer Vergleich
- Kubernetes vs. Docker Swarm: Vergleich von Container-Orchestrierungstools
- Kubernetes vs. OpenShift: Was ist der Unterschied?
- Kubernetes-Zertifizierungen: Wie und warum man zertifiziert wird
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.