




Auf einen Blick: Datenbank-DevOps steigert die Effizienz, indem es das Datenbankmanagement in das DevOps-Framework integriert, mit Fokus auf Automatisierung und Best Practices. Ziel ist es, die Quellcode-Kontrolle zu zentralisieren und mit CI/CD-Prozessen zu synchronisieren, um häufige Herausforderungen bei der Datenbankbereitstellung anzugehen.
- Über 90 % der Stakeholder wollen die Datenbankbereitstellung beschleunigen.
- Best Practices umfassen die Übernahme agiler Prinzipien und die Automatisierung von sich wiederholenden Aufgaben.
Datenbank-DevOps ist ein aufkommendes Gebiet der DevOps-Methodik. Werfen wir einen Blick auf Datenbankmanagement und was passiert, wenn man DevOps-Konzepte anwendet.
DevOps für Datenbanken?
DevOps ist (offiziell) das bevorzugte Softwareentwicklungs-Lifecycle (SDLC)-Framework für die Anwendungsentwicklung in den letzten Jahren. Kontinuierlicher Betrieb und Automatisierung haben sich als zentrales Merkmal der DevOps-Philosophie etabliert, wie sie in erfolgreichen DevOps-Umgebungen praktiziert wird. Dennoch haben die Prinzipien von Kontinuität und Automatisierung nicht alle Aspekte von Softwareanwendungen vollständig abgedeckt. Das laufende Management, die Veränderung, Aktualisierungen, Entwicklung und Verarbeitung von Datenbank (Code) hat sich für viele DevOps-Organisationen als Engpass erwiesen. Dies hat Ingenieure gezwungen, unzählige Stunden in Datenbankentwicklungs-Überarbeitungen zu investieren, die kontinuierliche Release-Zyklen unterstützen, wie es für eine optimierte DevOps-SDLC-Pipeline erwartet wird. Da Datenbankänderungen und -entwicklung als einer der riskantesten und langsamsten Prozesse des SDLC gelten, gilt die Anwendung der DevOps-Prinzipien für kontinuierliche Operationen und Automatisierung speziell für die Entwicklung von Datenbankcodes als potenzielle Lösung für das Datenbankproblem. Laut einem aktuellen Forschungsbericht:
- Über 90 % der Anwendungsbeteiligten arbeiten daran, Datenbankbereitstellungs- und -managementverfahren zu beschleunigen.
- Mehr als die Hälfte aller Anwendungsänderungen erfordert zudem Änderungen am entsprechenden Datenbankcode.
Datenbankherausforderungen in DevOps
Bevor wir besprechen, wie Datenbank-DevOps die DevOps SDLC-Pipeline effizient gestalten kann, wollen wir die datenbankspezifischen Herausforderungen betrachten, denen DevOps-Organisationen gegenüberstehen:
- Manuelle Änderungen. Traditionelles Datenbankmanagement folgt manuellen Prozessen wie Code-Reviews und -Genehmigungen – all das verzögert den Release-Zyklus.
- Datenbereitstellung. Aufgrund von Sicherheits- und regulatorischen Einschränkungen sind Produktionsdaten oft nicht verfügbar, um frühe Anwendungsentwicklungen zu testen. Die Daten werden daher verarbeitet und verschlüsselt, um die erforderlichen regulatorischen Anforderungen zu erfüllen.
- CI/CD für Datenbanken. Die Datenpersistenz kann nicht auf die gleiche Weise aufrechterhalten werden wie die Code-Persistenz bei einer Continuous Integration/Continuous Deployment (CI/CD)-Pipeline. Die kontinuierliche Integration und Bereitstellung neuer Datenbankversionen muss die gemeinsame Struktur und das Schema der Datenbanken respektieren – genau deshalb wird manuelles Eingreifen notwendig.
- Integrationsherausforderungen. Die schiere Vielfalt an Werkzeugen und architektonischen Variationen kann es erschweren, dass Datenbanksysteme kohärent funktionieren. Der Mangel an Standardisierung bedeutet, dass ein DevOps-Team kontinuierliche und automatisierte Infrastrukturoperationen für die Bereitstellung und Verwaltung von Datenbanksystemen nicht vollständig verfolgen kann.
Und dann gibt es noch eine größere, schwerer zu bewältigende Herausforderung: unzureichende DevOps-Aufmerksamkeit. Viele reale DevOps-Implementierungen haben es nicht geschafft, Datenbank- und Anwendungsentwicklungsprozesse in eine einheitliche und ganzheitliche SDLC-Rahmenrichtlinie zu integrieren. Datenbankmanagementprozesse haben den traditionellen Weg fortgesetzt, und das zunehmende Ausmaß der Datenbankänderungen hat es Ingenieuren erschwert, Datenbankentwicklungen mit dem Rest der Anwendungsentwicklung zu standardisieren und zu koordinieren. (Beobachten, wie diese Herausforderungen zunehmen, wenn die Datenspeicherung zunimmt.)
Was ist Datenbank-DevOps? Ein Prozess
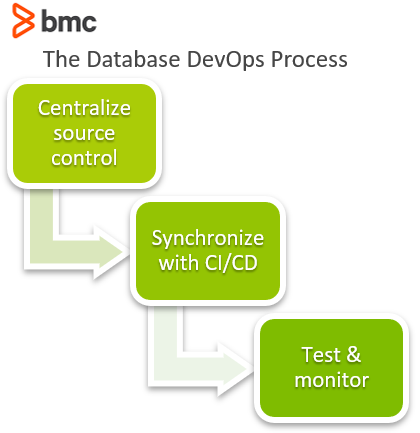
Schauen wir uns nun die Hauptaufgaben im Datenbank-DevOps an, die den Prozess tatsächlich ähnlich machen wie die Einführung des DevOps-Frameworks für Anwendungscode:
1. Quellcode-Kontrolle zentralisieren
Verwenden Sie ein zentralisiertes Versionskontrollsystem, in dem der gesamte Datenbankcode gespeichert, zusammengeführt und modifiziert wird. Das Speichern statischer Daten, Skripte und Konfigurationsdateien in einem einheitlichen Quellcodesystem erleichtert das Rückgängigmachen und Datenbankcodeänderungen mit der Anwendungsentwicklung nach einem CI/CD-Ansatz zu synchronisieren. (Erfahren Sie mehr über CI/CD.)
2. Synchronisieren mit CI/CD
Automatisierung von Build-Operationen, die parallel zu Anwendungsreleases laufen. Dies erleichtert die Koordination des Anwendungs- und Datenbankcode-Deployment-Prozesses. Der Datenbankcode wird getestet und aktualisiert, während eine neue Software-Build-Integration stattfindet, entsprechend den zugrundeliegenden Datenbankabhängigkeiten.
3. Testen & überwachen
Der CI/CD-Ansatz mit einem zentralisierten Versionskontrollsystem für Datenbank- und Anwendungscode erleichtert die Identifizierung von Datenbankproblemen jedes Mal, wenn ein neuer Build eingecheckt und ins Repository kompiliert wird.
- Entwickler können Probleme frühzeitig im SDLC-Lebenszyklus erkennen und beheben, der auf kontinuierliche Bereitstellungs- und Release-Zyklen eines schnelllebigen DevOps-Frameworks folgt.
- Im Gegensatz dazu erfordern traditionelle Datenbankverwaltungsoperationen langsame und manuelle Überprüfungs-, Test- und Genehmigungsprozesse für den entsprechenden Datenbankcode.
Best Practices für Datenbank-DevOps
Weitere Best Practices, die mit dem DevOps-Framework übereinstimmen:
- Übernehmen Sie die DevOps- und Agile-Prinzipien, kleine, inkrementelle und häufige Änderungen am Datenbankcode zu schreiben. Kleine Änderungen lassen sich leichter rückgängig machen und potenzielle Fehler frühzeitig im SDLC-Prozess erkennen.
- Bei jeder schrittweisen Änderung überwachen und verwalten Sie Abhängigkeiten. Verfolgen Sie bei der Datenbankentwicklung einen microservices-basierten Ansatz.
- Übernehmen Sie die schnelle Rückkopplungsschleife , ähnlich wie beim Entwicklungsprozess von Anwendungscodes. Kritisches Feedback kann jedoch in der Flut an Logmetriken, Daten und Warnungen an jedem Knoten des Netzwerks verborgen sein.
- Verfolgen Sie jede Änderung am Datenbankcode. Testen Sie früh und häufig, und priorisieren Sie die Leistung der Kennzahlen basierend auf der Geschäftsauswirkung und der Nutzererfahrung.
- Richten Sie die Testumgebung so ein, dass sie reale Anwendungsfälle repliziert. Richten Sie eine Produktionsumgebung ein, um Tests zu etablieren, die die Zuverlässigkeit der Datenbank gewährleisten.
- Automatisiert so viel wie möglich. Identifiziert wiederholende und vorhersehbare Datenbankverwaltungsaufgaben und schreibt Skripte, die den Datenbankcode aktualisieren, wenn ein neuer Build am Continuous Integration Server kompiliert wird.
Abschließend ist zu beachten, dass jede DevOps-Implementierung einzigartig für die Organisation ist, die das Framework adoptiert. Datenbank-DevOps kann konzeptionell mehrere Richtlinien aus dem Anwendungscode-DevOps-Playbook übernehmen und die Entwicklung und Verwaltung von Datenbankcodes mit dem Anwendungscode integrieren, um ähnliche SDLC-Leistungs- und Effizienzsteigerungen zu erzielen.
Verwandte Literatur
- BMC DevOps Blog
- Datenbankautomatisierung erklärt: Konzepte und Best Practices
- Eine Einführung in die Datenbankzuverlässigkeit
- Was ist ein Database Reliability Engineer (DBRE)?
- CAP-Theorem für Datenbanken: Konsistenz, Verfügbarkeit & Partitionstoleranz
- Datenbankadministratoren (DBA) Rollen und Verantwortlichkeiten im Big-Data-Zeitalter
DevOps-Leitfaden
- Was ist DevOps? Eine umfassende Einführung
- Eine kurze Geschichte von DevOps
- Einführung in die DevOps-Architektur
- Automatisierung in DevOps: Warum und wie man DevOps-Praktiken automatisiert
- Was ist CI/CD? Kontinuierliche Integration und kontinuierliche Lieferung erklärt
- Wie man eine CI/CD-Pipeline mit Jenkins aufbaut
- DevOps-Metriken zur Optimierung von CI/CD-Pipelines
- Kontinuierliche Liefermetriken
- Ist Continuous Integration in Continuous Deployment ein Fortschritt – oder nicht?
- Unterschiede zwischen Continuous Integration (CI), Delivery (CD) und Deployment
- Quellcode und Versionskontrolle in DevOps
- Was ist kontinuierliche Testung?
- Testautomatisierungs-Frameworks: Der ultimative Leitfaden
- Release Management in DevOps
- Erklärt: Monitoring & Telemetrie in DevOps
- Anwendungs-Leistungsmanagement in DevOps
- DevOps-Orchestrierung im SDLC
- Einführung in Datenbank-DevOps
- Die Rolle der Microservices in DevOps
- Die Rolle der Virtualisierung in DevOps
- Container & DevOps: Wie Container in DevOps-Lieferpipelines passen
- Was ist eine Containerpipeline?
- Was ist eine DevOps-Toolchain?
- Verwaltung von Containern und Code für DevOps
- Die Rolle von Agile in DevOps
- Die Rolle der Cloud in DevOps
- Was ist FinDevOps?
- Top-DevOps-Trends im Jahr 2022
- DevOps-Werte & Prinzipien
- DevOps-Kennzahlen und KPIs
- DevOps-Ratschläge für kleine, mittlere und große Organisationen
- DevOps-Teamstruktur
- Top-DevOps-Bücher, die man heute lesen sollte
- Buchrezension von The Phoenix Project: DevOps For Everyone
- DevOps-Influencer: 11 DevOps-Experten, denen Sie auf Twitter folgen können
- GitHub, GitLab, Bitbucket & Azure DevOps: Was ist der Unterschied?
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Konfigurationsmanagement in DevOps
- DevOps-Verzweigungsstrategien erklärt
- DevOps-Jobbezeichnungen, Rollen und Verantwortlichkeiten
- Testen in DevOps: Konzepte, Best Practices und mehr
- Der vollständige DevOps-Zertifizierungsleitfaden für 2022
- Was ist das Kubernetes-Operator-Muster?
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.