




Auf einen Blick: Die Integration von Jupyter Notebooks mit Apache Spark ermöglicht es Entwicklern, Big-Data-Analysen mit vertrauten Tools zu nutzen. Dieser Leitfaden zeigt, wie man Jupyter und PySpark für die Datenanalyse einrichtet, und hebt Installationsverfahren und Konfigurationen für optimale Leistung hervor.
- Jupyter unterstützt mehrere Programmiersprachen und erhöht so die Flexibilität in der Datenanalyse.
- PySpark ermöglicht es Python-Nutzern, nahtlos mit den Funktionen von Apache Spark zu interagieren.
Visualisieren und interagieren Sie mit Daten mit Apache Spark und Jupyter Notebook
Apache Spark ist eine Open-Source, schnelle einheitliche Analyse-Engine, die an der UC Berkeley für Big Data und maschinelles Lernen entwickelt wurde. Spark nutzt In-Memory-Caching und optimierte Abfrageausführung, um eine schnelle und effiziente Big-Data-Verarbeitungslösung bereitzustellen. Darüber hinaus kann Spark problemlos mehrere Workloads unterstützen, die von Batch-Verarbeitung, interaktiver Abfrage, Echtzeitanalyse bis hin zu maschinellem Lernen und Graphenverarbeitung reichen. All diese Funktionen haben dazu geführt, dass Spark zu einem führenden Datenanalysetool geworden ist. Aus Entwicklersicht ist eine der besten Eigenschaften von Spark die Unterstützung mehrerer Sprachen. Im Gegensatz zu vielen anderen Plattformen mit begrenzten Optionen oder bei denen Nutzer eine plattformspezifische Sprache lernen müssen, unterstützt Spark alle führenden Datenanalysesprachen wie R, SQL, Python, Scala und Java. Spark bietet Entwicklern die Freiheit, eine ihnen vertraute Sprache auszuwählen und bei der Entwicklung alle für diese Sprache unterstützten Tools und Dienste ganz einfach zu nutzen. Wenn man Python in Betracht zieht, ist Jupyter Notebooks eines der beliebtesten Werkzeuge für Entwickler. Wie können wir jedoch ein Jupyter Notebook mit Apache Spark zum Laufen bringen? In diesem Beitrag sehen wir, wie man Jupyter, Spark und PySpark nutzt, um eine Apache Spark-Installation zu erstellen, die Datenanalysen über die vertraute Jupyter Notebook-Oberfläche durchführen kann.
Wie Jupyter Notebooks funktionieren
Jupyter ist eine interaktive Rechenumgebung, die vom Jupyter Project verwaltet und unter der modifizierten BSB-Lizenz verteilt wird. Ein Notizbuch ist ein teilbares Dokument, das sowohl Eingaben als auch Ausgaben in einer einzigen Datei kombiniert. Diese Notizbücher können bestehen aus:
- Code
- Mathematische Gleichungen
- Erzähltext
- Visualisierungen
- Statistische Modellierung
- Weitere reichhaltige Medien
Das Schöne an einem Notizbuch ist, dass es Entwicklern ermöglicht, jede Art von Informationen zu entwickeln, zu visualisieren, zu analysieren und hinzuzufügen, um eine leicht verständliche und teilbare einzelne Datei zu erstellen. Dieser Ansatz ist in der Datenanalyse äußerst nützlich, da er es den Nutzern ermöglicht, alle Informationen zu den Daten in ein bestimmtes Notizbuch einzubeziehen. Jupyter unterstützt über 40 Programmiersprachen und ist in zwei Formaten erhältlich:
- Das klassische Jupyter-Notizbuch
- Das JupyterLab
JupyterLab ist die Next-Gen-Notebook-Oberfläche, die die Funktionalität von Jupyter weiter verbessert, um ein flexibleres Tool zu schaffen, das jeden Workflow von Data Science bis Machine Learning unterstützt. Jupyter unterstützt außerdem Big-Data-Tools wie Apache Spark für Datenanalyse. (Lesen Sie unsere umfassende Einführung zu Jupyter Notebooks.)
Wie man Jupyter mit Apache Spark verbindet
Wenn Sie Spark in Jupyter Notebook verwenden möchten, ist Scala die ideale Sprache, um mit Apache Spark zu interagieren, da es in Scala geschrieben ist. Die meisten Entwickler bevorzugen jedoch eine Sprache, mit der sie vertraut sind, wie Python. Jupyter unterstützt sowohl Scala als auch Python. Allerdings ist Python in den meisten Fällen aufgrund seiner Robustheit, Benutzerfreundlichkeit und der Verfügbarkeit von Bibliotheken wie pandas, scikit-learn und TensorFlow die flexiblere Wahl. Während Projekte wie Almond es den Nutzern erlauben, Scala zu Jupyter hinzuzufügen, konzentrieren wir uns in diesem Beitrag auf Python. (Sehen Sie, warum Python die bevorzugte Sprache für maschinelles Lernen ist.)
PySpark für Apache Spark & Python
Python verbindet sich über PySpark mit Apache Spark. Es ermöglicht Benutzern, Spark-Anwendungen mit der Python-API zu schreiben und ermöglicht die Schnittstelle mit den Resilient Distributed Datasets (RDDs) in Apache Spark. PySpark ermöglicht es Python, mit JVM-Objekten über die Py4J-Bibliothek zu interagieren. Darüber hinaus unterstützt PySpark die meisten Apache Spark-Funktionen wie Spark SQL, DataFrame, MLib, Spark Core und Streaming.
Konfiguration von PySpark mit Jupyter und Apache Spark
Bevor wir PySpark konfigurieren, müssen wir Jupyter und Apache Spark installiert haben. In diesem Abschnitt behandeln wir die einfachen Installationsprozeduren zur Nutzung von Spark in Jupyter Notebook. Du kannst diesem Jupyter Notebooks for Data Analytics Leitfaden für detaillierte Anweisungen zur Installation von Jupiter folgen und die offizielle Dokumentation von Spark nutzen, um es in deiner lokalen Umgebung einzurichten.
Installation von Spark
Sie benötigen Java, Scala und Git als Voraussetzungen, um Spark zu installieren. Wir können sie mit folgendem Befehl installieren:
sudo apt install default-jdk scala git -y
Dann holen Sie sich die neueste Apache Spark-Version, entpacken Sie den Inhalt und verschieben Sie ihn mit den folgenden Befehlen in ein separates Verzeichnis.
    wget https://dlcdn.apache.org/spark/spark-3.2.0/spark-3.2.0-bin-hadoop3.2.tgz
tar xf spark-*
sudo mv spark-3.2.0-bin-hadoop3.2 /opt/spark
ERGEBNIS
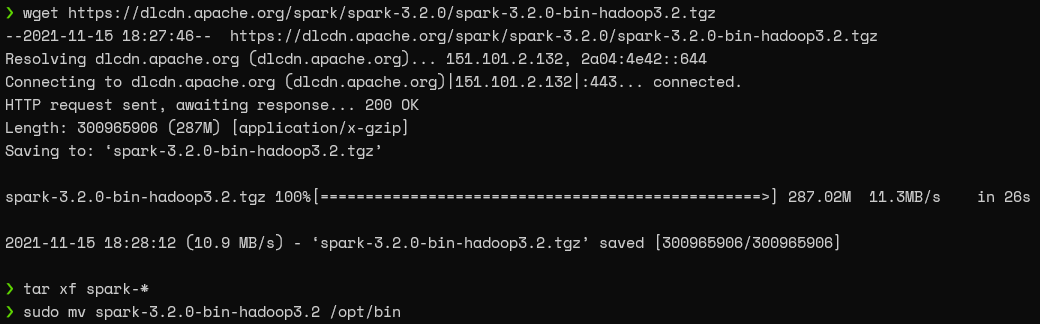
Dann können wir die Umweltvariablen einrichten, indem wir sie der Shell-Konfigurationsdatei hinzufügen (z.B.: .bashrc / .zshrc), wie unten gezeigt.
    export SPARK_HOME=/opt/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
export PYSPARK_PYTHON=/usr/bin/python3
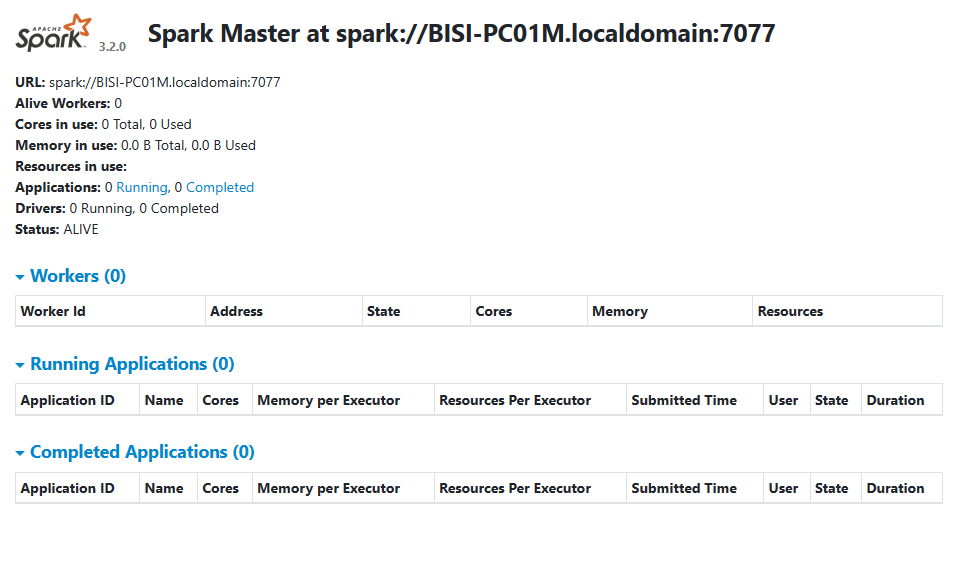
Die SPARK_HOME-Variable zeigt die Apache Spark-Installation an, und PATH fügt die Apache Spark (SPARK_HOME) zu den Systempfaden hinzu. Danach zeigt die PYSPARK_PYTHON-Variable auf die Python-Installation. Führen Sie schließlich den start-master.sh-Befehl aus, um Apache Spark zu starten, und Sie können die erfolgreiche Installation bestätigen, indem Sie http://localhost:8080/ Befehl besuchen
Web-UI
Installation von Jupyter
Die Installation von Jupyter ist ein einfacher und unkomplizierter Prozess. Sie kann direkt über den Python-Paketmanager mit folgendem Befehl installiert werden:
pip install notebook
Installation von PySpark
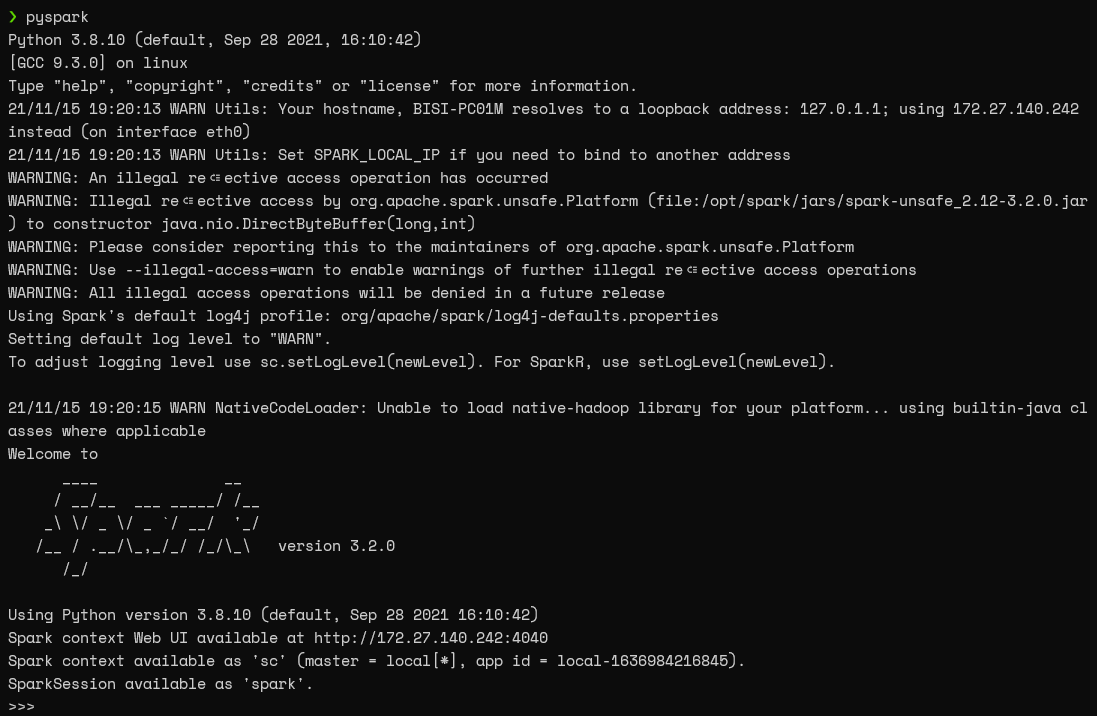
Es ist nicht nötig, PySpark separat zu installieren, da es mit Spark geliefert wird. Allerdings hast du auch die Möglichkeit, PySpark und die zusätzlichen Abhängigkeiten wie Spark SQL oder Pandas für Spark als separate Installation über den Python-Paketmanager zu installieren. Du kannst PySpark direkt starten, indem du den folgenden Befehl im Terminal ausführst.
pyspark
ERGEBNIS:
Wie man PySpark mit Jupyter Notebook integriert
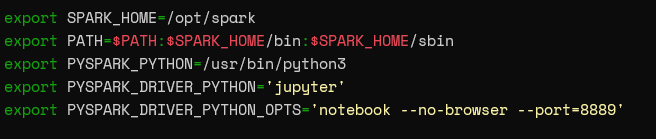
Die einzige Voraussetzung, um die Jupyter Notebook-Referenz PySpark zu erhalten, ist, die folgenden Umweltvariablen in deine .bashrc- oder .zshrc-Datei einzufügen, die PySpark auf Jupyter verweisen.
    export PYSPARK_DRIVER_PYTHON='jupyter'
export PYSPARK_DRIVER_PYTHON_OPTS='notebook --no-browser --port=8889'
Die PYSPARK_DRIVER_PYTHON zeigt auf Jupiter, während die PYSPARK_DRIVER_PYTHON_OPTS die Optionen beim Starten des Notizbuchs definiert. In diesem Fall zeigt sie die Option ohne Browser und Port 8889 für die Weboberfläche an. Mit den oben genannten Variablen sollte Ihre Shell-Datei nun fünf Umweltvariablen enthalten, die für diese Lösung erforderlich sind.
Jetzt können wir direkt eine Jupyter Notebook-Instanz starten, indem wir den Befehl pyspark im Terminal ausführen.
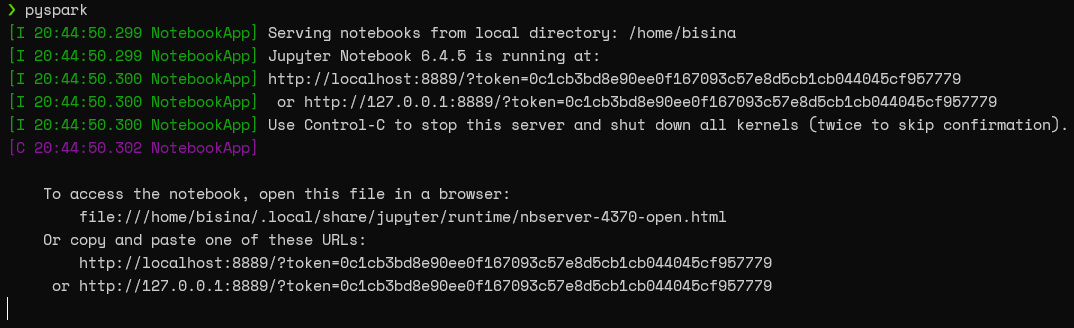
Wichtiger Hinweis: Stellen Sie immer sicher, dass Sie die Terminalumgebung aktualisieren; andernfalls werden die neu hinzugefügten Umgebungsvariablen nicht erkannt. Besuchen Sie nun die bereitgestellte URL, und Sie sind bereit, über das Jupyter Notebook mit Spark zu interagieren.
Test des Jupyter Notebook mit PySpark
Da wir die Integration inzwischen konfiguriert haben, bleibt nur noch zu testen, ob alles einwandfrei funktioniert. Lasst uns also ein einfaches Python-Skript ausführen, das Pyspark-Bibliotheken verwendet, und einen Datenrahmen mit einem Testdatensatz erstellen. Erstellen Sie den Datenrahmen:
    # Import Libraries
from pyspark.sql.types import StructType, StructField, FloatType, BooleanType
from pyspark.sql.types import DoubleType, IntegerType, StringType
import pyspark
from pyspark import SQLContext

# Setup the Configuration
conf = pyspark.SparkConf()

spark_context = SparkSession.builder.config(conf=conf).getOrCreate()
sqlcontext = SQLContext(sc)

# Setup the Schema
schema = StructType([
StructField("User ID", IntegerType(),True),
StructField("Username", StringType(),True),
StructField("Browser", StringType(),True),
StructField("OS", StringType(),True),
])

# Add Data
data = ([(1580, "Barry", "FireFox", "Windows" ),
(5820, "Sam", "MS Edge", "Linux"),
(2340, "Harry", "Vivaldi", "Windows"),
(7860, "Albert", "Chrome", "Windows"),
(1123, "May", "Safari", "macOS")
])

# Setup the Data Frame
user_data_df = sqlcontext.createDataFrame(data,schema=schema)
Drucken Sie den Datenrahmen:
user_data_df.show()
ERGEBNIS:
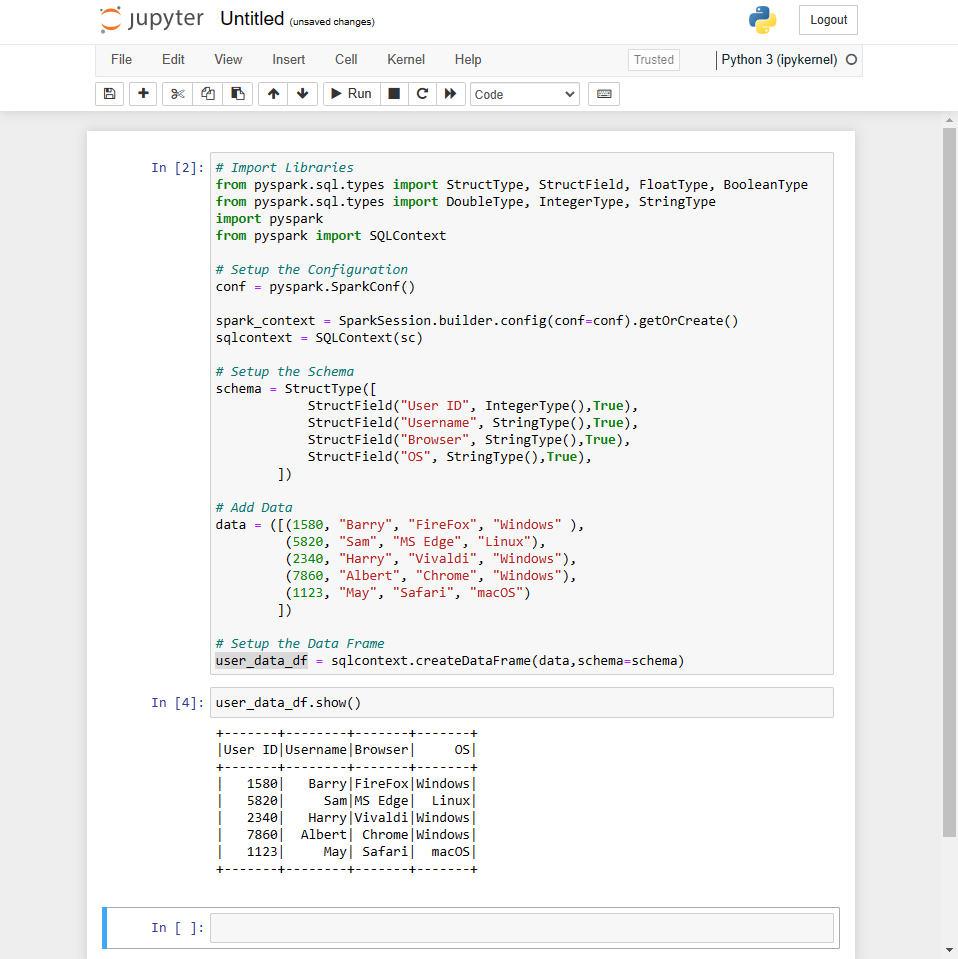
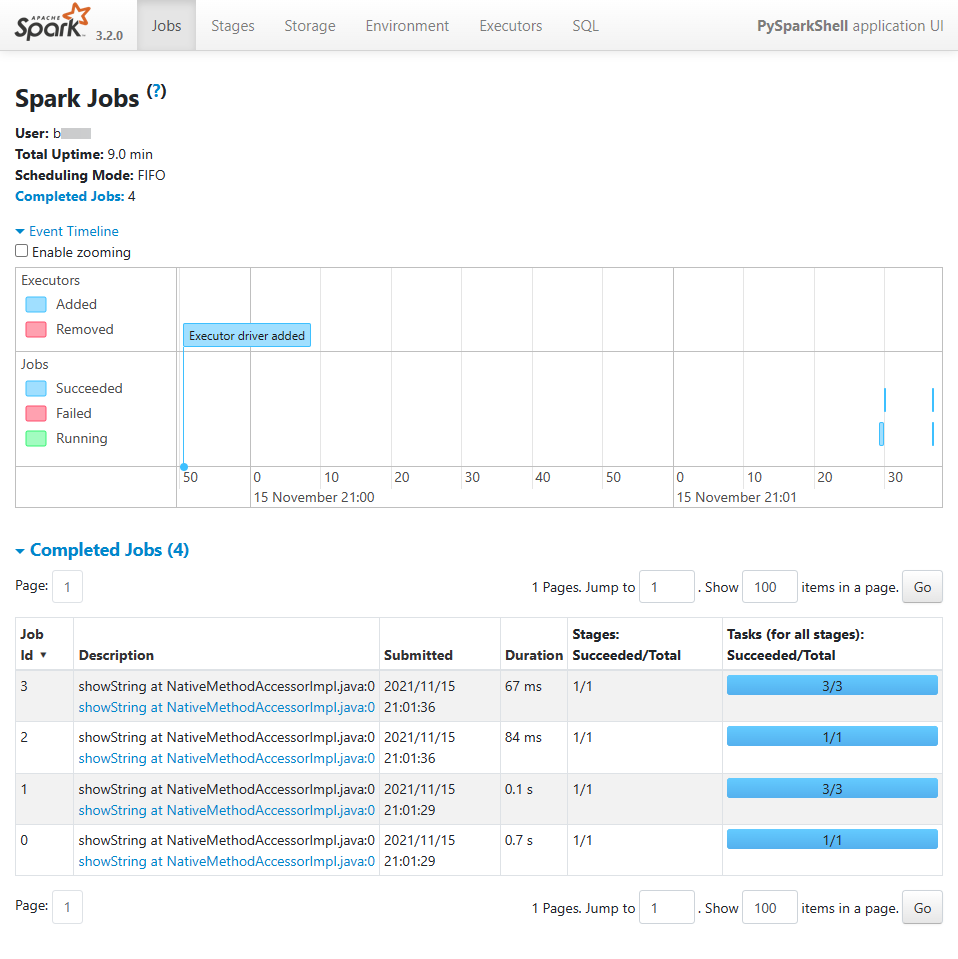
Wenn wir uns die PySpark Web UI ansehen, die über Port 4040 zugänglich ist, sehen wir die unten gezeigten Details zum Skriptausführungsjob.
Die Kraft der Nutzung von Spark und Jupyter Notebook
Apache Spark ist ein leistungsstarkes Tool für Datenanalyse und Big-Data. PySpark ermöglicht es Nutzern, mit Apache Spark zu interagieren, ohne eine andere Sprache wie Scala lernen zu müssen. Die Kombination aus Jupyter Notebooks und Spark bietet Entwicklern eine leistungsstarke und vertraute Entwicklungsumgebung und nutzt gleichzeitig die Kraft von Apache Spark.
Apache Spark Leitfaden
- Apache Sparks maschinelle Lernpipeline: Eine Einführung
- SGD-Beispiel für lineare Regression mit Apache Spark
- Spark Decision Tree Klassifikator
- Mit logistischer Regression, Scala und Spark
- Wie man Jupyter-Notizbücher mit Apache Spark verwendet
- Verwendung von Python und Spark Machine Learning zur Klassifikation
- Wie man Spark UDFs (benutzerdefinierte Funktionen) in Python schreibt
- Python Spark ML K-Means Beispiel
- Wie man maschinelles Lernen auf die Cybersicherheit anwendet
- Apache Spark: Zusammenarbeit mit Streams
- K-bedeutet Clustering mit Apache Spark
- Spark mit Hive verwenden
- Wie man Apache Spark verwendet, um Vorhersagen für die vorbeugende Wartung zu treffen.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.