





Auf einen Blick: Kubernetes-Überwachung ist unerlässlich, um verteilte Workloads zu verwalten und den Ressourcenverbrauch in Clustern zu optimieren. Dabei werden wichtige Kennzahlen erfasst, um die Gesundheit der Anwendung sicherzustellen und betriebliche Herausforderungen zu adressieren.
- Wichtige Kennzahlen umfassen Cluster- und Pod-Leistungsindikatoren.
- Beliebte Tools zur Überwachung sind Prometheus, Kubernetes Dashboard und der EFK Stack.
In Kubernetes (K8s) umfasst das Monitoring verschiedene Werkzeuge, Metriken und Methoden, um den Gesundheitszustand von Clusterkomponenten zu untersuchen. Der Prozess ermöglicht es Entwicklern und Administratoren im Wesentlichen, Probleme zu überwachen, die beim Betrieb von Arbeitslasten auf komplexen und verteilten Clustern auftreten können. Aufgrund der enormen Anzahl an verbundenen Diensten und Ressourcen innerhalb eines Clusters erfordert die Überwachung von Kubernetes oft besondere Aufmerksamkeit. Dies liegt daran, dass das Nachverfolgen von Änderungen und das Protokollieren von Ereignissen in verteilten Clusterkomponenten eigene zusätzliche Komplexitäten mit sich bringt. Lassen Sie uns verschiedene Aspekte der Kubernetes-Überwachung betrachten, darunter:
Was ist Kubernetes-Überwachung?
Kubernetes erleichtert die Ausführung verteilter, containerisierter Workloads. Dieses Modell bringt jedoch auch die Komplexität der Handhabung verteilter und verbundener Rechenelemente mit sich. In solch komplexen Setups ist das Monitoring entscheidend für das Management des Anwendungslebenszyklus, da es hilft, Probleme zu debuggen , die auftreten, wenn der Cluster in Betrieb ist. Monitoring ist die Praxis, alle kritischen Komponenten zu scannen, um sicherzustellen, dass es in einem Cluster keine einzelnen Ausfallpunkte gibt. Einige wichtige Gründe für Kubernetes-Überwachung sind:
- Sicherzustellen, dass Ressourcen optimal von einem Team oder einer bestimmten Anwendung genutzt werden
- Lastverteilung über Instanzen der Anwendung verteilt, die auf separaten Knoten gehostet wird
- Automatisch die Nutzung neu verfügbarer Ressourcen, wenn ein neuer Knoten einem Cluster beitritt
- Workloads auf andere Knoten neu deployen, wenn ein Host ausfällt
- Effiziente Bereitstellung von Updates und Rollbacks bei Bedarf
(Verstehen Sie die Unterschiede zwischen Monitoring und Observabilität.)
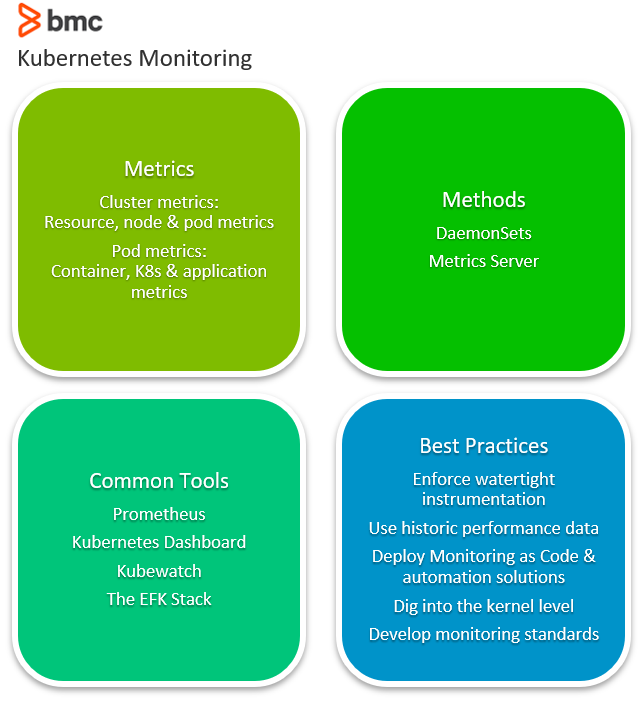
Kubernetes-Überwachungsmetriken
Verschiedene Kennzahlen helfen Entwicklern, sicherzustellen, dass Produktions-Workloads effizient laufen. Diese Metriken sind kritische Ereignisse von Containern, PODs, Knoten sowie der Anwendung, die es Überwachungstools gemeinsam ermöglichen, ein Profil aus den Eigenschaften des Clusters abzuleiten. Bei der Untersuchung eines Kubernetes-Clusters lassen sich Leistungskennzahlen in folgende Kategorien einteilen:
- Clustermetriken
- Pod-Metriken
Clustermetriken
Diese Kennzahlen ermöglichen es Entwicklern, das Verhalten aller Knoten und zugehöriger Ressourcen in einem Cluster zu untersuchen. Solche Kennzahlen helfen dem Administrator:
- Überwachen Sie, ob der Cluster wie vorgesehen läuft
- Kennzeichnung der Ressourcen- und Kapazitätsauslastung der Anwendung
- Behalte jede Node-Workload im Blick
Einige wichtige Cluster-Metriken sind:
- Ressourcenbasierte Metriken. Dazu gehören alle Kennzahlen, die sich auf den Verbrauch von Rechenressourcen beziehen, einschließlich CPU-, Festplatten- und Speichernutzung sowie Netzwerkbandbreitenverbrauch.
- Knotenbasierte Metriken. Die Anzahl der Knoten, die es Entwicklern ermöglicht, die Kosten für den Betrieb des Clusters auf verwalteten Plattformen zu verfolgen und die Arbeitsbelastung auf den Clusterknoten zu verstehen.
- Pod-basierte Metriken. Die Anzahl der laufenden PODs, damit Entwickler sicherstellen können, dass genügend Knoten bereitgestellt sind und der Cluster wechselnde Arbeitslasten im Falle eines Knotenausfalls bewältigen kann
Pod-Metriken
Überwachungstools können auch verwendet werden, um spezifisches POD-Verhalten zu beobachten und wie Kubernetes eine Bereitstellung handhabt. POD-Metriken können drei Arten anteilen: Container-Metriken. Diese Metriken werden vom Metrics-Server bereitgestellt, indem sie über cAdvisor, einen containerzentrierten Service, bereitgestellt werden. Container-Metriken umfassen:
- Nutzung von Containernetzwerken
- CPU-Verbrauch
- Netzwerkbandbreitenverbrauch
Kubernetes-Metriken. Diese Kennzahlen überwachen, wie gut eine Bereitstellung orchestriert wurde und wie der Status eines PODs ist. Kubernetes-Metriken umfassen:
- Gesundheitszustand des POD
- Fortschritt im Einsatz
- Netzwerkdaten
- Die Anzahl der derzeit laufenden POD-Instanzen
Anwendungsmetriken. Diese Metriken werden innerhalb des Anwendungscodes entwickelt, sodass sie besser mit den Anforderungen der Business Case übereinstimmen. Zum Beispiel kann eine E-Commerce-App Daten zu Kennzahlen wie Folgenden bereitstellen:
- Die Anzahl der derzeit angemeldeten Nutzer
- Einnahmen innerhalb eines bestimmten Zeitraums
- Klicks pro Stunde
Eine Datenbankanwendung hingegen kann Metriken bereitstellen, die mit den tabellierbaren Daten zusammenhängen. Während des Monitorings stellen Anwendungen diese Metriken typischerweise über eine API für die Kubernetes-Überwachungstools zur Verfügung.
Kubernetes-Überwachungsmethoden
Beim Extrahieren von Metrikdaten aus Kubernetes-Clustern gibt es zwei Hauptansätze:
- Überwachung mit DaemonSets
- Überwachung mit dem Metrics Server
Überwachung mit DaemonSets
Ein DaemonSet ist ein spezialisiertes POD, das sicherstellt, dass ein Snapshot seiner Arbeitslast auf allen Knoten im Cluster ausgeführt wird. Entwickler können ein DaemonSet erstellen, das auf jedem Knoten im Cluster einen Monitoring-Agenten ausführt, um Leistungskennzahlen zu sammeln. Da es einfach bereitzustellen ist, verwenden viele Kubernetes-Überwachungslösungen einen DaemonSet-Ansatz, um Überwachungssoftware auf Cluster-Knoten bereitzustellen, um die Gesundheit des POD zusammen mit Leistungsdaten zu überprüfen.
Überwachung mit dem Metrics Server
Früher als Heapster bekannt, bevor er eingestellt wurde, sendet Metrics Server Leistungsdaten an einen Speicherserver, der Cluster-Statistiken erfassen soll. Im Gegensatz zu einem DaemonSet fungiert ein Metrics Server als normaler POD, der Leistungsdaten vom Kubelet-Dienst sammelt und die Metrics-API nutzt, um diese dem kube-apiserver zugänglich zu machen. Ein Metrics Server ist hochskalierbar und gilt als fähig, Cluster von bis zu 5.000 Knoten mit einer einzigen Bereitstellung zu überwachen – eine effiziente Wahl für Cluster mit großer Arbeitslast.
Beliebte K8s-Überwachungstools
Hier ist eine kurze Übersicht über beliebte K8s-Überwachungstools.
Prometheus
Prometheus ist ein Open-Source-basiertes, gemeinschaftsgetriebenes Überwachungstool, das von der Cloud Native Computing Foundation verwaltet wird. Dieses Tool speichert Daten als Zeitreihe, die leicht über eine benutzerdefinierte Abfragesprache abgerufen und dann in einer integrierten Browserpräsentation dargestellt werden kann. Durch den Prometheus Operator ist die Bereitstellung des Überwachungstools auf einem Kubernetes-Cluster im Vergleich zu anderen beliebten Tools relativ einfach.
Kubernetes-Dashboard
Als Teil des Kubernetes-Stacks gepflegt, bietet dieses UI-basierte Tool serienmäßig zahlreiche Funktionen, die es Entwicklern ermöglichen, Workloads zu verwalten und die Ressourcenauslastung zur Laufzeit zu überprüfen. Durch verschiedene Ansichten liefert dieses Tool detaillierte Einblicke, darunter Persistent Volume Claims, ConfigMaps, Workload-Arten, CPU- und Speicherverbrauch usw. über alle Knoten eines Clusters hinweg.
Kubewatch
Kubewatch ist ein Monitoring-Agent , der Entwickler über Ereignisse und Protokolle über Kollaborationskanäle wie Slack und MS Teams benachrichtigt. Indem Entwickler die Ressourcen in einer YAML-Datei angeben können, ermöglicht Kubewatch Entwicklern, Benachrichtigungen über einen Webhook mit dem Kollaborationskanal zu integrieren. Anstatt ein vollwertiges Überwachungstool zu sein, ist Kubewatch ein Ereignis-Notifikator, der kritische Ereignisse eines Kubernetes-Clusters in bestimmte Kanäle zieht, um Entwickler-Einblicke zu erhalten.
Der EFK-Stack
EFK ist ein Stack von Tools , bestehend aus ElasticSearch, Fluentd und Kibana , der gemeinsam Logs und wichtige Erkenntnisse eines operativen Kubernetes-Clusters bereitstellt. Diese Tools arbeiten zusammen, um:
- Sammle Cluster-Logs (über Fluentd)
- Speichere sie zentral (ElasticSearch)
- Visualisieren Sie die Metriken (Kibana UI)
Dieser Stack ist besonders nützlich für:
- Erkennung von Problemen, sobald sie auftreten
- Probleme in einer einfachen GUI präsentieren
Best Practices für die Überwachung von K8s
Das Kubernetes-Monitoring stellt einige Herausforderungen speziell für Folgendes dar:
- Microservices-Architektur
- Vergängliche Behälter
- Hochskalierende Instanzen
Viele Best Practices für Kubernetes unterstützen die Cluster-Effizienz. Hier sind einige Best Practices, um das Beste aus den verfügbaren Überwachungslösungen herauszuholen:
- Durchsetzung einer wasserdichten Instrumentierungsstrategie, die es Überwachungstools ermöglicht, genaue Daten zu sammeln, ohne eine Ressource innerhalb eines Clusters zu verpassen.
- Einschließlich historischer Leistungsdaten, um unbekannte Probleme aufzudecken.
- Einsatz von Monitoring-as-Code-Lösungen zur Automatisierung und zur Verbesserung der Teamproduktivität und Clusterleistung.
- Ich grabe tief, um Performance-Probleme auf Kernel-Ebene zu entdecken.
- Entwicklung organisationsweiter Überwachungsstandards, um das Monitoring im Zentrum der Entwicklung zu halten.
Überwachung fördert die Clustereffizienz
Die Automatisierung der Kubernetes-Verwaltung erfordert einen fokussierten Ansatz, dedizierte Werkzeuge und die richtigen Methoden, um Cluster-Ressourcen proaktiv überwachen zu können. Durch die Bereitstellung eines effizienten Überwachungsmechanismus können Organisationen:
- Erhöhung der Clustereffizienz
- Senke die Betriebskosten (OpEx)
- Halten Sie proaktiv die Ressourcen auf optimalem Niveau
Verwandte Literatur
Kubernetes-Leitfaden
- Was ist Kubernetes (K8s)? Ein Tutorial zu den Grundlagen von Kubernetes
- Kubernetes Best Practices für verbesserte Cluster-Effizienz
- Best Practices: Wie man Anwendungen für Kubernetes architekt
- Kubernetes Pods: Eine Einführung
- Kubernetes ReplicaSets: Eine kurze Einführung
- Kubernetes-Deployments vollständig erklärt
- Wie man Kubernetes DaemonSets verwendet und verwaltet
- Wie Kubernetes-Dienste funktionieren
- Verwendung von Kubernetes Port, TargetPort und NodePort
- Erstellen und verwenden von ConfigMaps in Kubernetes
- Einführung in Kubernetes-Geheimnisse
- Kubernetes-Netzwerkgrundlagen
- Kubernetes-Ingress erklärt
- Einführung in Kubernetes Helm Charts
- Was ist das Kubernetes-Operator-Muster?
- Bereitstellung von PostgreSQL als StatefulSet in Kubernetes
- Kubernetes Custom Resource Definition (CRDs) erklärt
- 3 Kubernetes-Muster für Cloud-native Anwendungen
- Kubernetes Compute-Ressourcen erklärt
- Kubernetes-Sicherheit für DevOps-Pipelines
- Verwendung von Spinnaker mit Kubernetes für Continuous Delivery
- Kubernetes-Multi-Cluster: Wie und warum man sie verwendet.
- Kubernetes-Überwachung: Ein umfassender Leitfaden
- Kubernetes vs. Docker: Ein kurzer Vergleich
- Kubernetes vs. Docker Swarm: Vergleich von Container-Orchestrierungstools
- Kubernetes vs. OpenShift: Was ist der Unterschied?
- Kubernetes-Zertifizierungen: Wie und warum man zertifiziert wird
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.