




Auf einen Blick: Big Data bezeichnet umfangreiche Informationen, die durch hohes Volumen, hohe Geschwindigkeit und Vielfalt gekennzeichnet sind – entscheidend für datengetriebene Entscheidungsfindung. Ihr Wachstum wird von Technologien wie KI und IoT angetrieben und könnte bis 2025 175 Zettabyte erreichen.
- Wichtige Trends sind Augmented Analytics und kontinuierliche Intelligenz.
- Der Wert von Big Data liegt darin, Erkenntnisse zu entdecken, die Geschäftsstrategien vorantreiben.
Das digitale Universum expandiert kontinuierlich – genau wie das physische Universum, nur dass allein die digitale Welt mehr Daten erzeugt hat als die Anzahl der Sterne im gesamten beobachtbaren physikalischen Universum. 44 Zettabyte! Das sind 44 mit nachlaufenden Nullen (44x1021). Das sind 40-mal mehr Bytes als die Anzahl der Sterne im beobachtbaren Universum.

Bis 2025 wird es 175 Zettabyte an Daten in der globalen Datensphäre geben. Das Wachstum des Datenvolumens ist exponentiell. All diese Daten werden treffend als Big Data bezeichnet. In diesem Artikel werden wir:
- Einführung von Big Data
- Erkläre Kernkonzepte
- Vergleichen Sie kleine und dicke Daten
- Heben Sie die neuesten Big Data-Trends für Unternehmen hervor
- Ich verweise auf viele Ressourcen
Was ist Big Data?
Big Data ist der Begriff für Informationsvermögen (Daten), die durch ein hohes Volumen, eine hohe Geschwindigkeit und Vielfalt gekennzeichnet sind und systematisch extrahiert, analysiert und für Entscheidungs- oder Kontrollmaßnahmen verarbeitet werden. Die Eigenschaften von Big Data machen es praktisch unmöglich, mit traditionellen Datenanalysemethoden zu analysieren. Die Bedeutung von Big Data liegt in den Mustern und Erkenntnissen, die in großen Informationsressourcen verborgen sind und Geschäftsentscheidungen beeinflussen können. Wenn diese Erkenntnisse mithilfe fortschrittlicher Analysetechnologien extrahiert werden, helfen sie Organisationen, zu verstehen, wie sich ihre Nutzer, Märkte, Gesellschaft und die Welt verhalten.
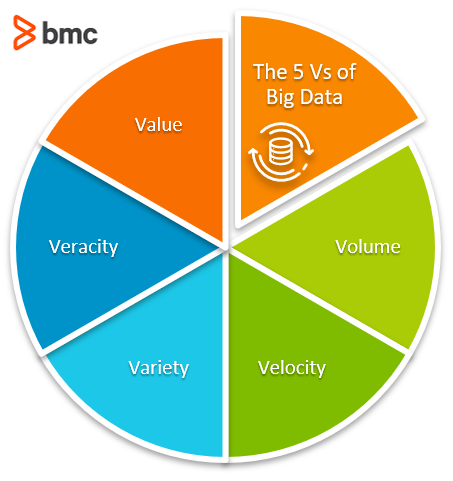
3 Vs von Big Data
Damit ein Informationsvermögen als Big Data betrachtet wird, muss es die 3-V-Kriterien erfüllen:
- Volumen. Die Größe der Daten. Daten mit hohem Volumen enthalten wahrscheinlich nützliche Erkenntnisse. Ein Mindestschwellenwert für Daten, die als groß gelten, beginnt üblicherweise bei Terabytes und Petabytes. Das große Volumen von Big Data erfordert hyperskalierte Rechenumgebungen mit großem Speicher und schnellen IOPS (Input/Output Operations pro Second) für eine schnelle Analyseverarbeitung.
- Geschwindigkeit. Die Geschwindigkeit, mit der Daten erzeugt und verarbeitet werden. Big Data wird typischerweise in Strömen erzeugt und ist in Echtzeit verfügbar. Die kontinuierliche Natur der Datengenerierung macht sie für Echtzeitentscheidungen relevant.
- Vielfalt. Die Art und Natur von Informationsressourcen. Rohe Big Data sind oft unstrukturiert oder multistrukturiert und werden mit verschiedenen Attributen, Standards und Dateiformaten generiert. Zum Beispiel sind Datensätze, die von Sensoren, Logdateien und sozialen Netzwerken gesammelt werden, unstrukturiert. Sie müssen daher in strukturierte Datenbanken verarbeitet werden, um Datenanalysen und Entscheidungsprozesse zu ermöglichen.
In jüngerer Zeit helfen zwei weitere Vs, Big Data zu charakterisieren:
- Wahrhaftigkeit. Die Zuverlässigkeit oder Wahrhaftigkeit von Daten. Das Ausmaß, in dem die Ergebnisse der Big-Data-Analyse für die damit verbundenen Geschäftsziele relevant sind, wird durch die Datenqualität, die Verarbeitungstechnologie und den Mechanismus zur Analyse der Informationsressourcen bestimmt.
- Wert. Der Nutzen von Big-Data-Ressourcen. Die Qualität der Ergebnisse von Big-Data-Analysen kann subjektiv sein und wird anhand einzigartiger Geschäftsziele bewertet.
Big Data vs. kleine Daten vs. dicke Daten
Im Gegensatz zu diesen Eigenschaften gibt es zwei weitere Datenformen: Small Data und Thick Data.
Small Data
Small Data bezeichnet handhabbare Datenressourcen, meist in numerischer oder strukturierter Form, die mit einfachen Technologien wie Microsoft Excel oder einer Open-Source-Alternative analysiert werden können.
Dicke Daten
Thick Data bezeichnet Text oder qualitative Daten, die mit handhabbaren manuellen Prozessen analysiert werden können. Beispiele sind:
- Interviewfragen
- Vermessungen
- Videotranskripte
Wenn man qualitative Daten in Verbindung mit quantitativen Big Data verwendet, kann man die Gefühls- und Verhaltensaspekte, die von Einzelpersonen leicht kommuniziert werden können, besser verstehen. Thick Data ist besonders nützlich in den Bereichen Medizin und wissenschaftlicher Forschung, in denen Reaktionen einzelner Menschen genügend Wert und Einsichten haben – im Gegensatz zu großen Big-Data-Strömen.
Big-Data-Trends in den Jahren 2021-2022
Big-Data-Technologien entwickeln sich kontinuierlich weiter. Tatsächlich werden Daten selbst zunehmend zum wichtigsten Vermögenswert für ein Unternehmen. Die Verbreitung des Internets der Dinge (IoT), Cloud Computing und Künstlicher Intelligenz (KI) erleichtert es Organisationen, Rohdaten in umsetzbares Wissen umzuwandeln. Hier sind drei der beliebtesten Big-Data-Technologietrends, auf die Sie im Jahr 2021 achten sollten:
- Erweiterte Analyse. Die Big-Data-Branche wird bis Ende 2021 fast 274 Milliarden US-Dollar wert sein. Technologien wie Augmented Analytics, die Organisationen beim Datenmanagementprozess unterstützen, werden voraussichtlich schnell wachsen und bis zum Jahr 2023 18,4 Milliarden US-Dollar erreichen.
- Kontinuierliche Intelligenz. Die Integration von Echtzeit-Analysen in Geschäftsabläufe hilft Unternehmen, die Konkurrenz mit proaktiven und umsetzbaren Erkenntnissen in Echtzeit zu überholen.
- Blockchain. Strenge Gesetze wie die DSGVO und HIPAA ermutigen Organisationen, Daten sicher, zugänglich und zuverlässig zu machen. Blockchain und ähnliche Technologien finden ihren Weg in die Finanzbranche als Instrument zur Datenverwaltung und -sicherheit, das äußerst widerstandsfähig und robust gegenüber Datenschutzrisiken ist. Diese EU-Ressource erläutert, wie Blockchain einige zentrale Ziele der DSGVO ergänzt.
Big-Data-Best Practices für Unternehmen
Sicherlich wächst die Welt der Daten exponentiell. Sind Ihre Daten und Datenprozesse den Aufgaben gewachsen, die Sie ihnen stellen? BMC Blogs bietet viele Ressourcen zum Verständnis und zur Arbeit mit Big Data. Stöbern Sie im BMC Machine Learning & Big Data Blog oder tauchen Sie tiefer in diese Bereiche ein:
Datengrundlagen
- Datenqualität: Top-Konzepte und Best Practices für Unternehmens-IT
- Strukturierte vs. unstrukturierte Daten: Ein Wandel in der Privatsphäre
- Datenarchitektur: Komponenten, Standards und sich verändernde Architekturen
- Data Streaming erklärt: Vor- und Nachteile und wie es funktioniert
- Was ist eine Datenpipeline?
Datenspeicherung
- Datenspeicher erklärt: Data Lake vs. Warehouse vs. Datenbank
- Kalte vs. heiße Datenspeicherung: Was ist der Unterschied?
- CAP-Theorem für Datenbanken: Konsistenz, Verfügbarkeit & Partitionstoleranz
- Datenbank-as-a-Service (DBaaS) erklärt
Datenmanagement
- Datenmanagement vs. Data Governance: Hauptunterschiede
- Was ist Data Governance? Warum brauche ich es?
- 3 einfache Strategien zur Datenmonetarisierung für Unternehmen
- Was ist Testdatenmanagement (TDM)?
Datensicherheit
- Einführung in die Datensicherheit
- Datenverlustprävention und DLP-Lösungen
- Big-Data-Sicherheitsfragen im Unternehmen
Datenanalyse und -analyse
- Datenanalyse vs. Datenanalyse: Was ist der Unterschied?
- Big Data vs. Analytics vs. Data Science: Was ist der Unterschied?
- Datenvisualisierung: Einstieg mit Beispielen, Teil unseres Datenvisualisierungsleitfadens
Maschinelles Lernen, Data Science & KI
- Prädiktive Analytik vs. maschinelles Lernen: Was ist der Unterschied?
- Datenannotation und ihre Rolle im maschinellen Lernen
- 3 Schlüssel zum Aufbau widerstandsfähiger Datenpipelines
Datentheorie & Thought Leadership
- Datenethik für Unternehmen
- Was ist Datenschwerkraft?
- Achtsame KI: 5 Konzepte für achtsame künstliche Intelligenz
- Was ist Goodharts Gesetz? Balance zwischen Authentizität und Messung
Big Data lernen
-
- Data Engineer vs. Data Scientist: Was ist der Unterschied?
- Data-Science-Zertifizierungen: Eine Einführung
- Ermöglichung der Bürgerdatenwissenschaftler
Big-Data-Tutorial-Reihe
Diese Tutorial-Reihen sind Teil der BMC Guides.
Diese Beiträge sind meine eigenen und spiegeln nicht unbedingt die Position, Strategien oder Meinung von BMC wider.